系统可靠性设计:那些年被忽视的魔鬼细节
说实话,我第一次真正被系统可靠性设计震撼到,是在凌晨三点接到报警电话的时候。那会儿刚入职,自认为代码写得滴水不漏——结果被现实劈头盖脸浇了盆冷水。一个小小的超时设置失误,直接导致整个服务雪崩,用户骂声一片。我在机房抱着笔记本一边发抖一边回滚,心里只有一个念头:原来“可靠”这两个字,真不是玩笑。
 分布式系统脑裂故障示意图
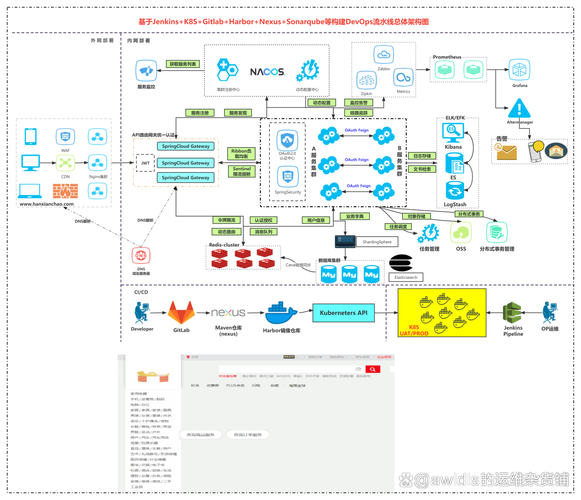 Netflix混沌猴子故障注入实验示意图
 监控:你以为看到了全部,其实盲人摸象
很多时候,我们觉得有了Prometheus、Grafana,报警规则一堆,就万事大吉。大错特错。监控系统可能成为最华丽的遮羞布。首先,指标采集本身有延迟和遗漏;其次,报警阈值是人定的,要么过于敏感整天“狼来了”,要么太迟钝火灾都烧完了才响。更重要的是,可观察性(Observability)不同于监控——你不可能预想所有故障模式。所以,日志、追踪、指标得三位一体,而且一定要做故障演练来验证监控的有效性。
有一回,我们一个核心接口延迟飙升,但监控大盘上QPS、错误率都很正常。排查半天才发现,是某个下游数据库查询变慢,但因为我们用了超时自动重试,导致实际处理时间巨长,但错误被掩盖了。如果当时有详细的分布式追踪,一眼就能看到那个瓶颈。后来我们强制要求所有服务必须接入全链路追踪,并且定期进行故障注入测试。科研上,关于trace的分析算法,比如基于机器学习的异常检测,其实有很多,但工业界还在追赶。别光看论文,动手试试才是最实在的。
 可靠性是日拱一卒的烂仗
最后吐槽一下,很多人把系统可靠性当成一个大项目,搞个“稳定性专项”,搞完就散场。没用。可靠性是持续斗争的过程,因为业务在变、流量在变、依赖在变。今天可靠的架构,明天可能就是瓶颈。你必须把可靠性设计融入到每一次代码提交、每一次架构评审里。比如,规范要定死:所有外部调用必须设置超时和重试策略,并且重试必须幂等;所有共享资源必须有隔离;所有关键路径必须有熔断。这些东西琐碎、烦人,但救命。
哦,还有故障报告(Postmortem)——别把它写成批斗会,也别糊弄了事。好的故障报告能推动系统进化。我有一次写故障报告,写了七千字,复盘过程里发现了一个隐藏很深的依赖循环,最后重构了整个模块。这种苦活累活,没点执念真干不下来。
所以,系统可靠性设计,别想着有银弹。踏踏实实踩坑,诚惶诚恐运维,晚上才睡得着觉。
冗余越多越安全?未必
咱们搞技术的,尤其是分布式系统,总觉得多来几台机器、多部署几个副本就高枕无忧了。对吧?可事实上——冗余本身就是在引入新的故障点。我记得有篇Google的论文提过,一个大型系统里,磁盘年故障率大概2%到4%,服务器故障率更高。如果你有1000台机器,每天至少有一台坏掉。这还不是最要命的,冗余带来的管理复杂度往往被忽视。主从切换时的数据一致性问题,副本之间的同步延迟,心跳检测的误判……弄不好,冗余节点自己成了定时炸弹。 有一次我们数据库迁移,主库挂了,从库自动提升,结果因为网络分区,两个库都以为自己是大爷——脑裂了!数据全乱套。我懊恼得恨不得把监控屏幕砸了。那段经历让我深刻记住:自动化故障转移必须在严格的一致性协议下进行,比如Paxos或Raft,而且你得真的测试过脑裂场景。科研圈里关于共识算法的研究一堆,但说实话,落地时细节琐碎得要命。分布式系统脑裂故障示意图
别太迷信“优雅降级”
优雅降级听着特别美好——某个功能坏了,系统还能苟着。可谁想过,降级策略本身可能引发二次灾难。举个例子,你为了防刷,做了限流,但限流阈值设得太死,结果正常流量也被砍了,业务受损。更惨的是,降级开关一旦打开,可能把一些关键监控信号也屏蔽了,等到发现时,系统已经病入膏肓。 我参与过一个视频直播项目,高峰期弹幕服务压力大,就设计成“如果弹幕服务不可用,客户端静默跳过”。听起来没问题吧?结果有一次,弹幕服务的健康检查接口因为网络抖动超时,所有客户端瞬间停止请求弹幕,但后端弹幕服务其实还活着——只是没人找它了。等故障恢复,大量缓存消息积压,直接把消息总线撑爆了。这就叫虚假的降压,真实的背刺。做降级,你得想清楚每一层依赖,并且进行混沌工程实验。Netflix的Simian Army就是这么干的,随机杀死服务,逼着你把容错做进骨头里。Netflix混沌猴子故障注入实验示意图
监控:你以为看到了全部,其实盲人摸象
监控:你以为看到了全部,其实盲人摸象
很多时候,我们觉得有了Prometheus、Grafana,报警规则一堆,就万事大吉。大错特错。监控系统可能成为最华丽的遮羞布。首先,指标采集本身有延迟和遗漏;其次,报警阈值是人定的,要么过于敏感整天“狼来了”,要么太迟钝火灾都烧完了才响。更重要的是,可观察性(Observability)不同于监控——你不可能预想所有故障模式。所以,日志、追踪、指标得三位一体,而且一定要做故障演练来验证监控的有效性。
有一回,我们一个核心接口延迟飙升,但监控大盘上QPS、错误率都很正常。排查半天才发现,是某个下游数据库查询变慢,但因为我们用了超时自动重试,导致实际处理时间巨长,但错误被掩盖了。如果当时有详细的分布式追踪,一眼就能看到那个瓶颈。后来我们强制要求所有服务必须接入全链路追踪,并且定期进行故障注入测试。科研上,关于trace的分析算法,比如基于机器学习的异常检测,其实有很多,但工业界还在追赶。别光看论文,动手试试才是最实在的。
可靠性是日拱一卒的烂仗
可靠性是日拱一卒的烂仗
最后吐槽一下,很多人把系统可靠性当成一个大项目,搞个“稳定性专项”,搞完就散场。没用。可靠性是持续斗争的过程,因为业务在变、流量在变、依赖在变。今天可靠的架构,明天可能就是瓶颈。你必须把可靠性设计融入到每一次代码提交、每一次架构评审里。比如,规范要定死:所有外部调用必须设置超时和重试策略,并且重试必须幂等;所有共享资源必须有隔离;所有关键路径必须有熔断。这些东西琐碎、烦人,但救命。
哦,还有故障报告(Postmortem)——别把它写成批斗会,也别糊弄了事。好的故障报告能推动系统进化。我有一次写故障报告,写了七千字,复盘过程里发现了一个隐藏很深的依赖循环,最后重构了整个模块。这种苦活累活,没点执念真干不下来。
所以,系统可靠性设计,别想着有银弹。踏踏实实踩坑,诚惶诚恐运维,晚上才睡得着觉。