隐私计算技术,真的能保护我们吗?——一个从业者的碎碎念
上个月参加了个闭门会,听几个大厂技术总监聊隐私计算,我差点拍桌子——说的都是啥呀。全是PPT里的套话,什么“数据可用不可见”“打破数据孤岛”……我真的,听得胃疼。但话说回来,隐私计算这玩意儿本身挺有意思的,就是被过度包装了。今天趁喝咖啡的空,跟你随便唠唠。
数据的尴尬:流不动,又必须流
你想想,现在的数据就跟黄金似的。企业都想拿别人的数据来训练模型,但又死抱着自己的数据不放。为什么?法规啊,GDPR、个人信息保护法,谁敢乱来?还有商业机密。所以数据“躺”在各自的服务器里,成了一个个孤岛。我有个朋友在银行,他们想跟运营商合作搞个反欺诈模型,谈了半年,最后还是卡在数据共享上。律师说不行,合规说风险大。哎,这就是现实。隐私计算要解决的就是这个——让数据在不泄露原始信息的情况下,还能一起算。
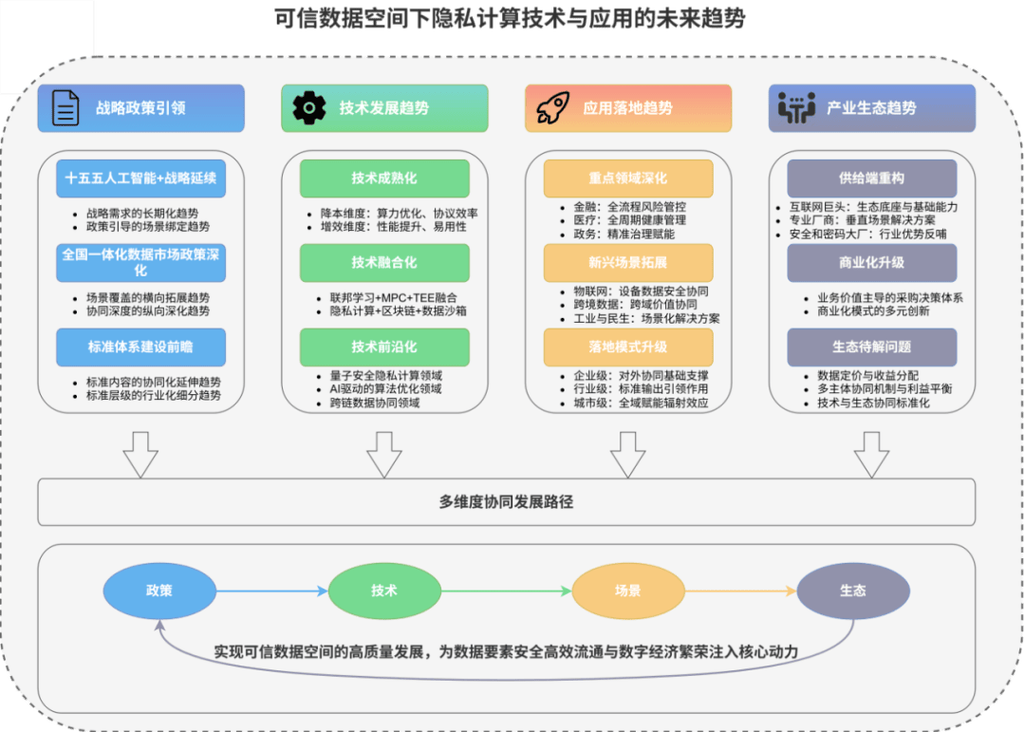 数据孤岛与隐私计算解决方案示意图
简单说,就是给数据穿上“隐身衣”。但隐身衣也分好几种款式,各有各的优缺点。我见过的落地项目里,至少一半以上都踩过坑,因为技术选型没搞对。
三种流派,哪个是你的菜?
现在市面上主流的隐私计算技术,通常分三大类:联邦学习、安全多方计算、可信执行环境。听起来高大上,其实原理……也还好。联邦学习就是“数据不动模型动”,各家自己训练子模型,然后只交换梯度参数。美团用这个做推荐,挺溜的。但你得注意,它也不是绝对安全,梯度还是可能泄露一些信息,论文都有证明。还有,通信开销吓死人,几轮迭代下来,流量费比云主机还贵。我们团队试过一次,差点把预算搞崩。
安全多方计算更硬核,纯密码学那套,让多个参与方在不泄漏各自输入的情况下,完成函数计算。听起来完美对吧?然而——慢!慢到离谱。一个简单的关联查询,能跑好几分钟。金融圈喜欢用它做隐私求交,但也就限于小数据量。去年有个客户想来一套做联合风控,我们私下算了算,光硬件成本就得七位数,对方直接沉默。
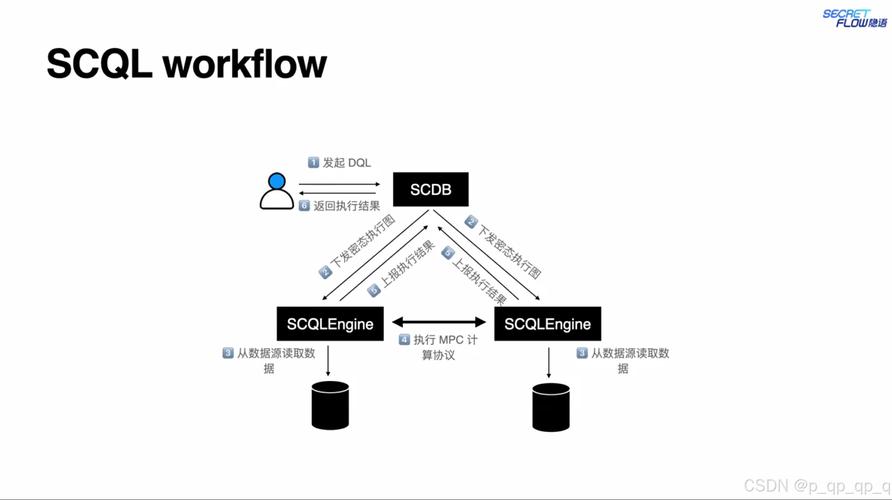 多方安全计算协议架构图
可信执行环境就好玩了,用硬件搞个“黑盒子”,数据进盒子里算,外面看不着。Intel SGX、ARM TrustZone这些。好处是快,接近明文速度。坏处呢,你得信硬件厂商。而且侧信道攻击不是闹着玩的,去年有个研究把SGX里保护的数据偷出来了,搞得行业一阵鸡飞狗跳。但话说回来,落地最快的反而是TEE,因为对应用改动小。阿里云的DataTrust就是典型。
别光看技术,落地才是照妖镜
 别光看技术,落地才是照妖镜
我特别想吐槽的一点是,很多论文里的性能指标,到了生产环境……根本没法看。实验室数据优美,一到真实网络,延迟爆炸。更根本的痛点是:业务方不懂技术,技术方不懂合规。我们做过一个医疗数据的联合分析项目,医院和信息科来回扯皮,最后方案改了七版。隐私计算不是纯IT问题,它是个缝合怪,得把法律、业务、工程全揉一起。
不过最近有个趋势让我挺惊喜——隐私计算和大模型的结合。像蚂蚁的“隐语”框架已经开始支持联邦大模型微调,这个方向有戏。你想啊,医疗大模型苦于没有高质量的病历数据训练,用联邦学习把分散在各医院的病历联合起来,又不碰原始数据,岂不是美哉?当然,我还是要泼冷水:工程落地上的坑,不会因为模型变大就自动消失。
还有个事儿,行业标准正在收紧。信通院搞了一堆评测,但我觉得吧,有些评测指标过于理想化,企业拿个“金融隐私计算优秀案例”的牌子,实际系统照样卡得要死。说实话,我越来越觉得,隐私计算最后的形态,可能不是纯技术驱动,而是被法规逼着走。你只要合规了,慢一点也能接受。
我的一点私货
乱七八遭说了这些,你大概也听出来了——我对隐私计算是又爱又恨。爱它让数据流动的可能性,恨它被吹成万能解药。我打个比方:它就像一辆概念车,看着炫酷,但真开上路,爆胎、没电、导航失灵。我们得一点点修补。如果你现在问我,要不要上隐私计算?我会说:看场景。如果只是为了追热点,趁早放弃;如果确实有跨机构数据合作的强需求,且双方都有靠谱的工程团队,那可以试试,但记得多备点资源,因为调试成本绝对超出你预期。
好了,咖啡凉了,就聊到这儿。回头再补个实践指南,如果我不懒的话。