联邦学习技术:你的数据不出门,我的模型照样练
你知道现在训练一个AI模型,最头疼的是什么吗?不是算法不够强,是数据拿不到。哈哈,你会发现,数据在银行手里,在医院手里,在用户手机里,但它们不肯给你。为啥?隐私呗。于是联邦学习技术应运而生——听起来很高大上,其实核心就一句话:数据不动模型动。
我刚开始接触这个概念时,心里嘀咕:这不就是分布式训练嘛,换了个马甲。直到后来踩了几个坑才明白,它们压根不是一回事。传统分布式训练,数据可以切分后扔到不同GPU上,但中心节点能看见所有数据。联邦学习呢?数据压根不出本地,连中心服务器都看不到原始数据。模型参数在加密或者“掺了噪音”的状态下传来传去,聚合更新全靠安全算法。这相当于让模型自己跑腿,到各家各户去学习,最后汇总经验,但绝不窥探主人的隐私。
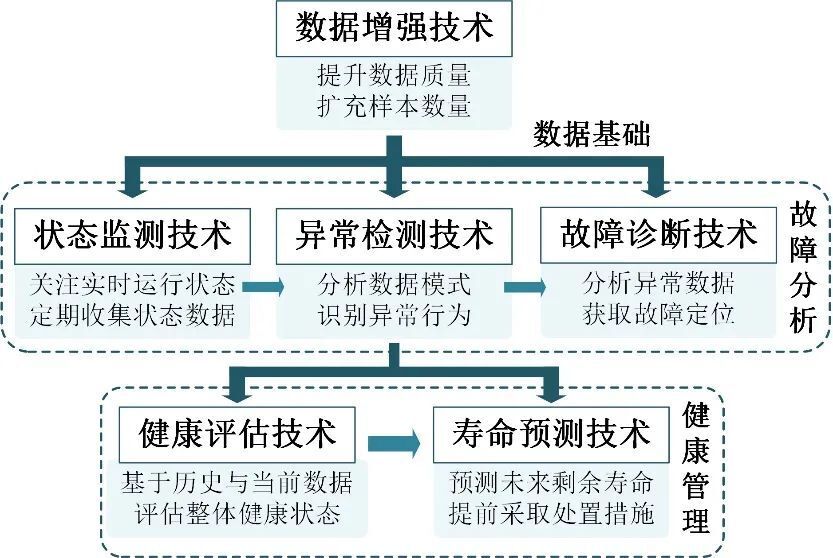 联邦学习的核心逻辑:模型跑腿儿,数据看家
其实联邦学习分了几个流派。最常见的叫横向联邦,就是大家的数据特征一样,但用户群不同。比如两家银行,都有客户的年龄、收入、消费记录这些特征,但客户完全不重叠。这时候,双方各自在本地用相同初始化的模型训练,然后把梯度或模型参数加密后发给中心服务器,服务器一加权平均,再发回去。反复这么迭代,模型就学遍了全局信息。听起来简单对吧?但魔鬼在细节里——通信效率、安全聚合、节点掉线……全是坑。
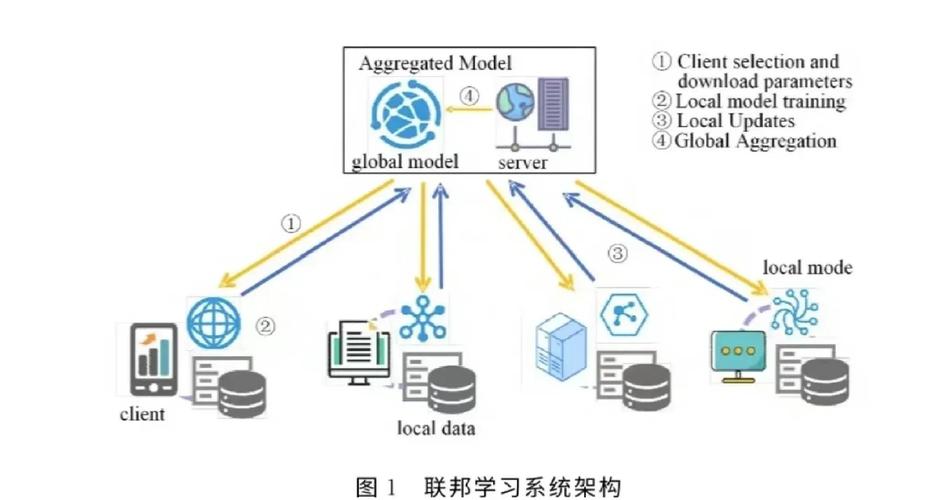 横向联邦学习架构示意图 数据不出本地
纵向联邦呢,就更复杂了。它适用于大家用户群体重叠但特征维度不同的场景,比如银行和电商,他们有共同客户,但银行知道客户的资产状况,电商知道客户的购物偏好。这两方想把特征拼起来训练模型,但又不愿暴露各自具体的数值。于是就要用到加密的实体对齐和联邦特征工程,通常基于隐私集合求交(PSI)技术,对齐用户ID,然后每一方把自己的部分特征加密后交互计算,最后训练出一个联合模型。这过程里,同态加密、秘密共享之类的密码学工具轮番上阵,计算开销大得惊人。有一回我看一个纵向联邦的项目,光对齐数据就用了两天,最后模型效果还不如只用单边特征加些伪标注。真是让人又好气又好笑。
不过话说回来,联邦学习有时候也会用力过猛。有些论文为了创新,把差分隐私、多方安全计算、TEE全叠加上,结果系统复杂到没法部署。实际情况中,一个简单的FedAvg算法,配合一些稀疏化和量化压缩,往往就能取得不错的效果。关键你得根据数据分布和通信带宽选择合适的策略。别搞那些玄乎的,没用。
 落地场景:从医疗到金融,到底能用在哪儿?
聊完原理,说说我见过的真实案例吧。医疗领域最热,毕竟医院之间的数据共享能极大地提升罕见病诊断模型的准确性。去年有个比赛,用联邦学习做脑胶质瘤分割,十几个机构参与,最终效果很接近集中训练。可一旦放到真实医院环境,数据格式、标注标准、扫描设备全不一样,数据异质性严重得让人头秃。我们团队曾经帮一家三甲医院搞联邦学习试点,光清洗和对齐DICOM格式就花了三个月,各方的MRI切片厚度都不统一,有的甚至还带有奇怪的序列标签。最后模型精度只比单中心提高了两个百分点,老板脸都绿了。所以啊,好的算法还得配上扎实的数据治理,否则就是空中楼阁。
 联邦学习在医疗影像诊断中的应用场景
金融领域倒是更务实一些。反洗钱、信用评分这类场景对数据联合有刚需,各家不想泄露客户信息,但合起来能识别更多风险模式。前阵子跟一个银行的风控团队交流,他们用联邦学习构建了一个跨行的交易反欺诈模型,误报率显著下降。不过合规问题依旧棘手,尤其是跨国项目,GDPR和国内的数据安全法把数据跨境掐得死死的。我听说有家欧洲银行的联邦学习项目,因为传输了加密梯度也被监管叫停,理由是“加密梯度可能间接泄露个人信息”。这逻辑……行吧,法规的板子打下来,技术也扛不住。
还有移动端应用,谷歌的Gboard输入法用联邦学习优化词汇预测,算是行业标杆了。但说实话,用户体验的提升微乎其微,更多是宣传价值。毕竟手机性能参差不齐,有的用户一晚只能完成几次本地训练,而模型要成百上千轮才能收敛,黄花菜都凉了。所以学术界现在热捧的设备端个性化联邦学习,让每台设备有自己的专属模型,可能才是正解。
 联邦学习安全聚合与隐私保护技术图解
总而言之……哦不,不能说这个词。反正,联邦学习技术就像一把双刃剑,舞得好,数据孤岛能变堡垒;舞不好,就是一堆加密的废铁。但至少,它给我们指明了一条路:在隐私和智能之间,不一定非要二选一。或许再过五年,我们刷脸支付、看病问诊时,后台都是联邦模型在默默协作,而你我的数据,自始至终,安安稳稳地待在手机里、服务器上,从未离开过家门一步。
联邦学习的核心逻辑:模型跑腿儿,数据看家
联邦学习的核心逻辑:模型跑腿儿,数据看家
其实联邦学习分了几个流派。最常见的叫横向联邦,就是大家的数据特征一样,但用户群不同。比如两家银行,都有客户的年龄、收入、消费记录这些特征,但客户完全不重叠。这时候,双方各自在本地用相同初始化的模型训练,然后把梯度或模型参数加密后发给中心服务器,服务器一加权平均,再发回去。反复这么迭代,模型就学遍了全局信息。听起来简单对吧?但魔鬼在细节里——通信效率、安全聚合、节点掉线……全是坑。
横向联邦学习架构示意图 数据不出本地
纵向联邦呢,就更复杂了。它适用于大家用户群体重叠但特征维度不同的场景,比如银行和电商,他们有共同客户,但银行知道客户的资产状况,电商知道客户的购物偏好。这两方想把特征拼起来训练模型,但又不愿暴露各自具体的数值。于是就要用到加密的实体对齐和联邦特征工程,通常基于隐私集合求交(PSI)技术,对齐用户ID,然后每一方把自己的部分特征加密后交互计算,最后训练出一个联合模型。这过程里,同态加密、秘密共享之类的密码学工具轮番上阵,计算开销大得惊人。有一回我看一个纵向联邦的项目,光对齐数据就用了两天,最后模型效果还不如只用单边特征加些伪标注。真是让人又好气又好笑。
不过话说回来,联邦学习有时候也会用力过猛。有些论文为了创新,把差分隐私、多方安全计算、TEE全叠加上,结果系统复杂到没法部署。实际情况中,一个简单的FedAvg算法,配合一些稀疏化和量化压缩,往往就能取得不错的效果。关键你得根据数据分布和通信带宽选择合适的策略。别搞那些玄乎的,没用。
落地场景:从医疗到金融,到底能用在哪儿?
落地场景:从医疗到金融,到底能用在哪儿?
聊完原理,说说我见过的真实案例吧。医疗领域最热,毕竟医院之间的数据共享能极大地提升罕见病诊断模型的准确性。去年有个比赛,用联邦学习做脑胶质瘤分割,十几个机构参与,最终效果很接近集中训练。可一旦放到真实医院环境,数据格式、标注标准、扫描设备全不一样,数据异质性严重得让人头秃。我们团队曾经帮一家三甲医院搞联邦学习试点,光清洗和对齐DICOM格式就花了三个月,各方的MRI切片厚度都不统一,有的甚至还带有奇怪的序列标签。最后模型精度只比单中心提高了两个百分点,老板脸都绿了。所以啊,好的算法还得配上扎实的数据治理,否则就是空中楼阁。
联邦学习在医疗影像诊断中的应用场景
金融领域倒是更务实一些。反洗钱、信用评分这类场景对数据联合有刚需,各家不想泄露客户信息,但合起来能识别更多风险模式。前阵子跟一个银行的风控团队交流,他们用联邦学习构建了一个跨行的交易反欺诈模型,误报率显著下降。不过合规问题依旧棘手,尤其是跨国项目,GDPR和国内的数据安全法把数据跨境掐得死死的。我听说有家欧洲银行的联邦学习项目,因为传输了加密梯度也被监管叫停,理由是“加密梯度可能间接泄露个人信息”。这逻辑……行吧,法规的板子打下来,技术也扛不住。
还有移动端应用,谷歌的Gboard输入法用联邦学习优化词汇预测,算是行业标杆了。但说实话,用户体验的提升微乎其微,更多是宣传价值。毕竟手机性能参差不齐,有的用户一晚只能完成几次本地训练,而模型要成百上千轮才能收敛,黄花菜都凉了。所以学术界现在热捧的设备端个性化联邦学习,让每台设备有自己的专属模型,可能才是正解。
未来往哪儿走?隐私、效率、信任的三角博弈
联邦学习远没到成熟期,挑战一大把。首先是安全与效率的矛盾。要想真正防止梯度泄露原始数据,得上同态加密或安全多方计算,但计算和通信开销会飙升十倍以上。目前折衷方案多用差分隐私,给梯度加噪声,但噪声大了模型就废,噪声小了隐私泄露风险又高。怎么拿捏这个度?没有标准答案,只能根据场景取舍。另外,可信执行环境(TEE)如Intel SGX也加入战局,把聚合放在硬件“黑箱”里,但TEE的侧信道攻击和固件漏洞也让人不放心。你永远不知道攻击者有多骚。 然后是激励机制。凭什么让各方贡献高质量数据?光靠情怀不行。不少论文幻想用区块链发token,可真正落地时,谁会为了几个代币拿数据合规开玩笑?目前更多是靠联盟或行政命令推动,比如多个医院属于同一个医疗集团,或者银行间由银联牵头。但这种自上而下的模式扩展性有限。未来或许需要更聪明的贡献度评估算法,能自动辨别并奖励高质量数据提供方,同时惩罚浑水摸鱼的。 还有一个我特别在意的方向——联邦学习与大模型。现在大模型动辄千亿参数,联邦学习想都别想。但能不能把大模型的能力用联邦蒸馏的方式传递给小模型?或者用联邦学习联合微调大模型?这些都在探索中。前不久看到一篇论文,用联邦指令微调训练一个医疗大模型,参数量低了好几个数量级,效果却还不错。这要真能搞成,就能在保护隐私的前提下,让各个机构都享受到大模型的红利,想想都激动。联邦学习安全聚合与隐私保护技术图解
总而言之……哦不,不能说这个词。反正,联邦学习技术就像一把双刃剑,舞得好,数据孤岛能变堡垒;舞不好,就是一堆加密的废铁。但至少,它给我们指明了一条路:在隐私和智能之间,不一定非要二选一。或许再过五年,我们刷脸支付、看病问诊时,后台都是联邦模型在默默协作,而你我的数据,自始至终,安安稳稳地待在手机里、服务器上,从未离开过家门一步。