标准制定与推广:聊聊AI模型评估那些让人头疼的事儿
前几天参加一个闭门会,主题是AI评估标准。现场吵得跟菜市场似的——你信吗?反正我是大开眼界。
搞学术的人吵起架来,那股子较真劲儿,真是又好笑又佩服。说实话,这乱象背后,是整个行业都憋着一股火:模型吹得天花乱坠,可用起来根本不是那么回事儿。评测榜单每天变,你方唱罢我登场,用户彻底懵圈。这标准制定,已经不只是技术活儿了,简直就是一场利益、学术和监管的三角博弈。
一团乱麻的评测江湖
现在市面上的大模型,什么GPT-4、Claude、文心一言、通义千问,个个都说自己‘最强’。但你仔细一看,每家用的评测基准都不一样。MMLU、HellaSwag、HumanEval、C-Eval... 我都数不过来。这些基准真的能衡量真实能力吗?我一个朋友把某个号称MMLU 90分的模型拿去回答他女儿的小学奥数题,结果错得一塌糊涂。后来发现,那模型就是刷题刷的,死记硬背,换个问法就傻眼。
 各大AI模型在MMLU与HellaSwag排行榜上的分数对比
更搞笑的是数据污染。很多模型的训练数据里,已经包含了测试题。好比考试前偷看了答案,然后得意洋洋说自己考了第一。这算什么本事?学术界早就有人呼吁,需要动态的、对抗性的评估方法,可就是推不下去。为什么?因为费时费力,而且一旦用了这种硬核评测,资本市场的概念故事就不好讲了。
神仙打架:标准制定背后的角力
制定标准这事儿,本身就带着原罪——谁掌握了标准,谁就捏住了行业的喉咙。你看通信领域的5G标准之争,高通、华为打得多凶。AI圈也一样。OpenAI力挺自己的Evals框架,谷歌推BIG-bench,斯坦福搞了个HELM,国内的中科院、信通院也在弄自己的体系。去年欧盟AI法案落地,对高风险AI的评估要求直接写进法律,这下可好,标准瞬间变成了合规工具,各家又开始抢着把自己的方案塞进监管框架。
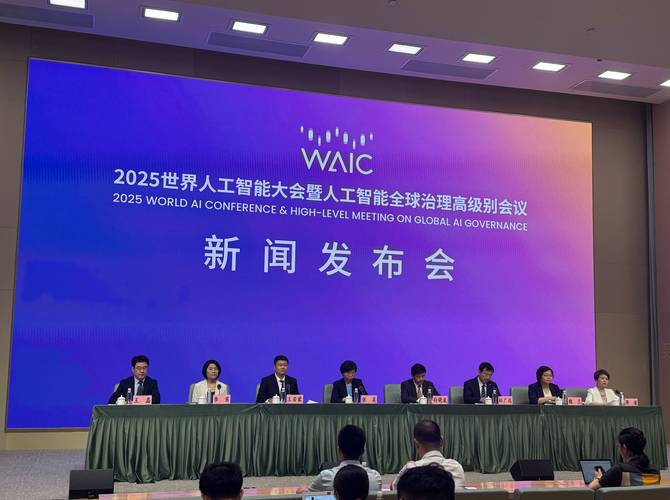 国际人工智能标准制定会议现场专家激烈辩论
我一个在标准院工作的朋友吐槽,有时候开会不是讨论技术,而是互相试探底线。大厂的代表会暗示:‘我们这个方案已经开源了,社区反响不错,采纳起来成本低。’小公司呢,根本没话语权,只能跟着站队。但你说大厂就真为行业好?不见得。他们往往把对自己有利的指标权重拉高,压低竞争对手的优势项。比如强调多语言任务的公司,就拼命推多语言评分标准;擅长代码的,就主攻代码基准。这哪是标准,分明是护城河。
光有标准还不够,得有人用啊
 光有标准还不够,得有人用啊
假设终于憋出一套大家都认可的标准,就万事大吉了?天真。推广才是真正的鬼门关。当年Transformer刚出来的时候,谁规定它必须是标准架构了?纯粹是因为好用,大家一窝蜂跟了。所以标准想推广,得让开发者尝到甜头,或者,有强力的‘胡萝卜加大棒’。
MLPerf算一个正面例子。它靠业内巨头的联合推动,加上媒体的狂轰滥炸,硬生生把AI训练推理的跑分变成了硬件公司每年的‘高考’。现在谁芯片发布不拿MLPerf说事?这就叫生态绑架。但AI模型评估比硬件复杂,不是简单跑个分就能服众的。场景太多,主观判断太重要。比如写首诗,你觉得好我觉得烂,怎么量化?
开源社区其实是很好的推广阵地。Hugging Face上的排行榜虽然粗糙,但它让评估变得透明、可复现。如果未来标准能像GitHub的星星一样,成为项目的荣誉勋章,那推广就水到渠成。不过话说回来,现在国内有些所谓‘官方认证’,根本没人care,形同虚设。制度设计者真该听听草根的声音,而不是关起门来拍脑袋。
最近还有个趋势:企业开始用AI评估AI。也就是让一个裁判模型去打分。这听着挺省事,但万一把裁判也带偏了呢?死循环。所以啊,标准的制定与推广,注定是一场持久战,中间还会夹杂着各种狗血剧情。但有一点是确定的——谁离真实需求更近,谁说话就更有分量。