供应链管理技术那些事儿:从翻车到真香
你知道吗?去年我参与的一个项目,预测模型跑出来的数据漂亮得像维密超模,结果实际执行——啪啪打脸。库存积压了30%,最后清仓大甩卖,老板脸都绿了。
这事儿让我想起 MIT 供应链创新实验室 2019 年的一项研究:超过 60% 的企业预测误差率在 20% 以上,而他们用的技术并不差,SAP 的 APO、Oracle 的 Demantra,听名字都挺唬人的。问题出在哪儿?
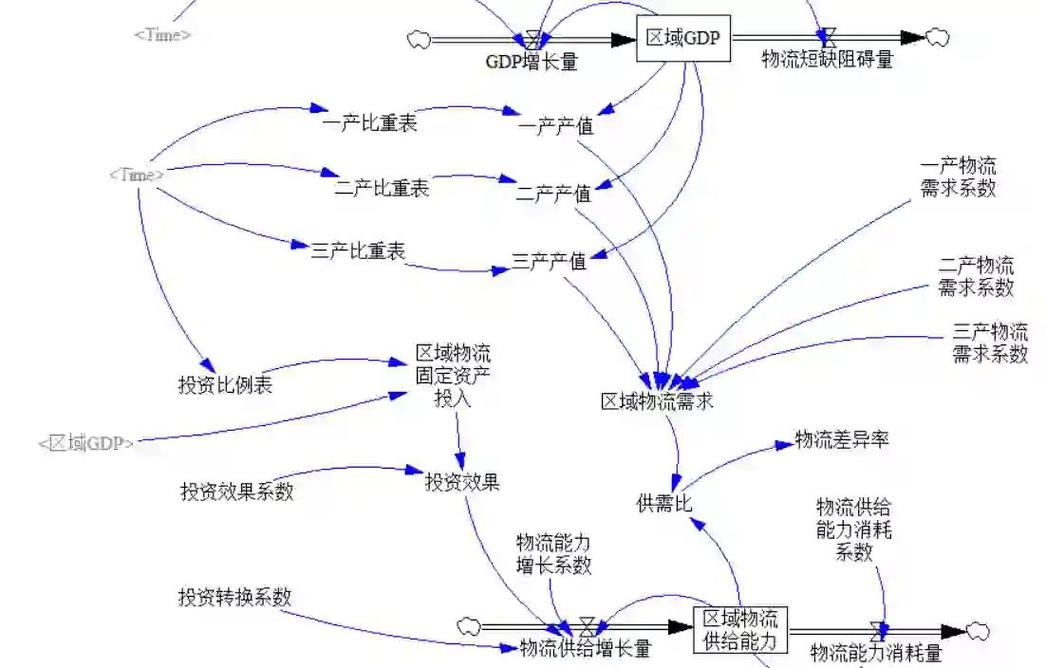 因果推断供应链需求预测示意图
不过话说回来,这东西落地很难。数据不够干净,业务部门又不配合,搞技术的被问“你凭什么说是因为这个原因?”——我一个做算法的,还得去跟市场部吵架,解释 p 值。心累。
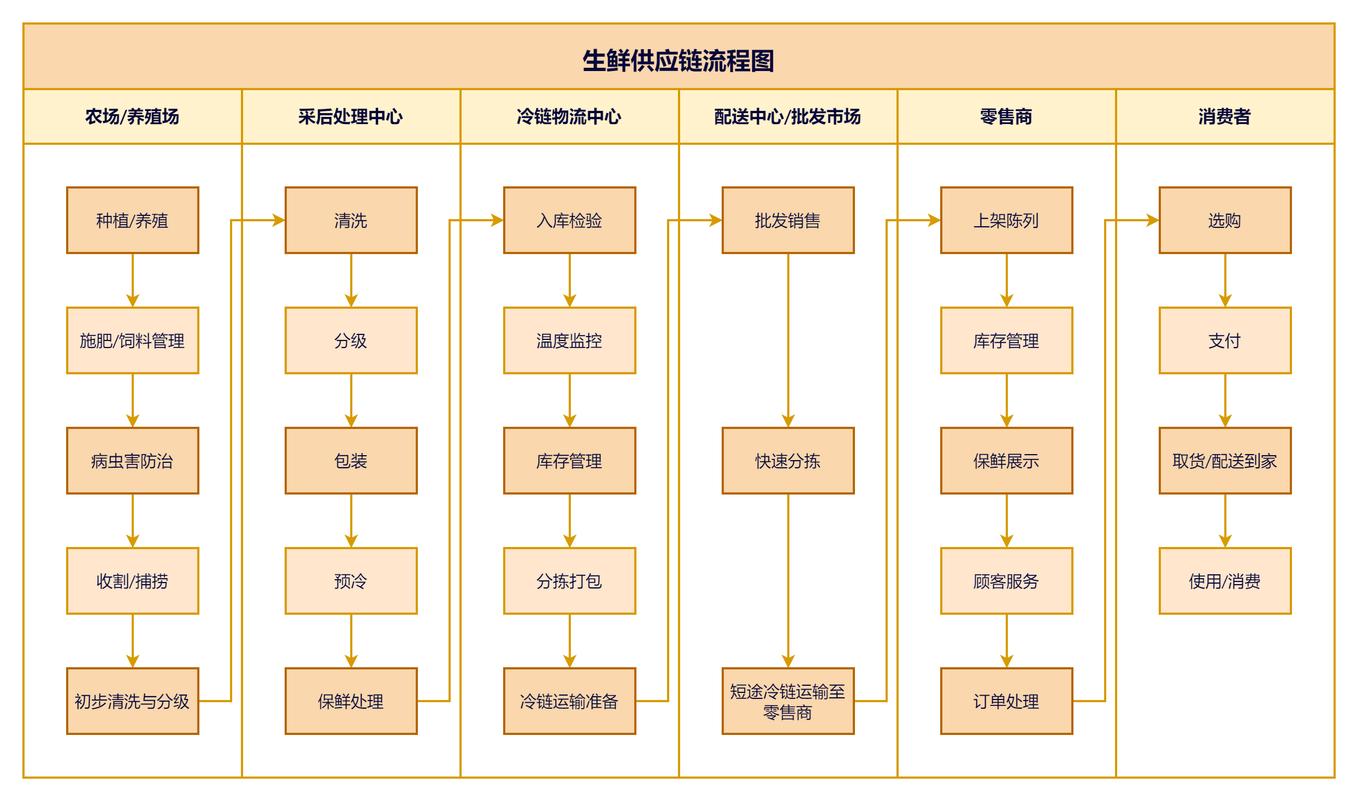 区块链生鲜供应链溯源流程图解
但中小企业玩不起这个。节点部署、智能合约开发,再加上持续运维,没个几百万下不来。所以,我现在的态度?对于核心企业强主导的供应链,区块链是利器;对于松散协作的,还是先做好 API 对接吧。
预测技术:那套“科学”有时候像个算命先生
传统预测基于历史数据,用时间序列、回归分析,再加点机器学习——随机森林、神经网络。听起来高大上,对吧?但市场这玩意儿,根本不吃这套。2020 年疫情一来,所有模型全崩了。你能想象一个模型能预测到口罩需求突然爆增 1000% 吗?不能。 所以现在学界和业界都在搞“因果推断”。简单说,就是不只看历史规律,还要理解为什么。比如一篇发表在《Management Science》上的论文,讲如何用双重机器学习(Double ML)剥离促销、天气、竞品动作对销量的影响,然后预测。我试了一下,确实有点东西——至少不会把季节性波动当成趋势。因果推断供应链需求预测示意图
不过话说回来,这东西落地很难。数据不够干净,业务部门又不配合,搞技术的被问“你凭什么说是因为这个原因?”——我一个做算法的,还得去跟市场部吵架,解释 p 值。心累。
区块链溯源:噱头还是未来?
“区块链能彻底解决供应链信任问题”——这话你信吗?我当初信了,还兴冲冲给一个生鲜平台搭了套溯源系统,从农场到餐桌,每一步上链。结果呢?成本高得离谱,每秒才十几笔交易,根本扛不住双十一的并发。而且,上链的数据就能保证真实吗?源头作假,链上信息还是错的,所谓信任变成了“共同维护一个漂亮的谎言”。 不过,最近沃尔玛和 IBM 搞的 Food Trust 联盟链,倒是让我改观了一点。他们把质检报告、物流温度等 IoT 数据自动上链,加上一些零知识证明技术,既能保护隐私又能交叉验证。去年有篇《Harvard Business Review》的文章分析,这个系统把问题食品追溯时间从 7 天缩短到 2.2 秒。2.2 秒!——这才是杀手级的应用。区块链生鲜供应链溯源流程图解
但中小企业玩不起这个。节点部署、智能合约开发,再加上持续运维,没个几百万下不来。所以,我现在的态度?对于核心企业强主导的供应链,区块链是利器;对于松散协作的,还是先做好 API 对接吧。