云计算平台构建:科研算力这摊事,别被供应商带沟里
去年帮一个做冷冻电镜的课题组看他们的‘云平台’。看完我沉默了。三台工作站拼的集群,调度靠手写脚本,数据盘NFS一挂,全组放假。这不是云计算,这是云里雾里。
云计算平台构建,在科研圈经常被简化成‘买几台GPU服务器,装个K8s’。真这么干,大概率三个月后想砸机器。
 科研云计算平台容器调度架构图
先说个反常识的。科研云和互联网云,压根不是一类东西。互联网业务讲究高峰削谷、弹性扩容、灰度发布。科研呢?一个博士生可能半夜三点跑一个全基因组比对,突然吃掉两百个核。第二天另一个组要做分子动力学,又要几百张GPU。负载像脉冲。预算像心电图。你拿商业云的思路硬套,账单能吓死人。
 高校科研云平台异构算力管理界面
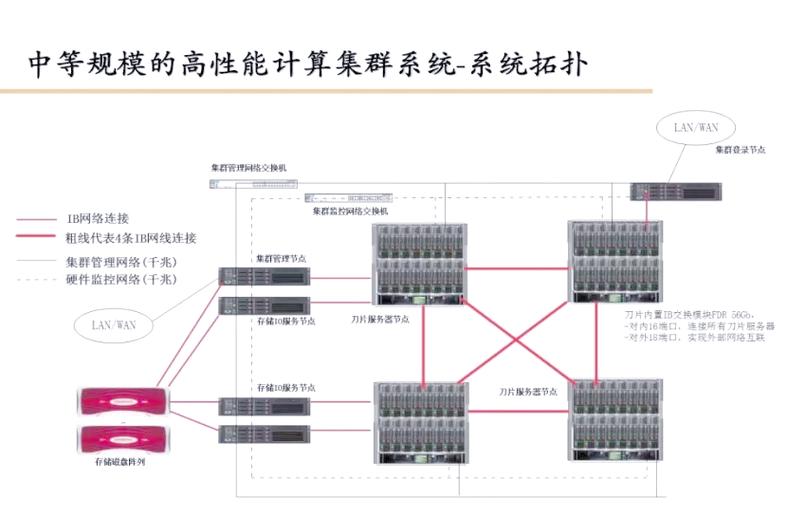 科研高性能计算集群并行存储网络拓扑图
科研云计算平台容器调度架构图
先说个反常识的。科研云和互联网云,压根不是一类东西。互联网业务讲究高峰削谷、弹性扩容、灰度发布。科研呢?一个博士生可能半夜三点跑一个全基因组比对,突然吃掉两百个核。第二天另一个组要做分子动力学,又要几百张GPU。负载像脉冲。预算像心电图。你拿商业云的思路硬套,账单能吓死人。
别把科研云当机房搬家
很多单位一提云计算平台构建,第一反应是买超融合。虚拟化一装,完事。可科研负载不是OA系统。它要的是算力抽象、数据流动、软件可复现。缺一个,平台就变成高级网盘。 科研软件栈有多恐怖?一个老牌仿真软件可能依赖特定版本的MPI、特定版本的GCC、再加一个早就没人维护的Python 2.7库。你让用户自己配?他配三天,最后甩一句‘还是用我自己的笔记本吧’。平台必须把环境打包成镜像,按需挂载。 还有多租户。一个课题组的数据,另一个组不能碰。但GPU又要共享。怎么办?配额、命名空间、cgroup、MIG切片。别指望用户自觉。高校科研云平台异构算力管理界面
调度器才是命门,别只盯着显卡
显卡重要吗?重要。但调度器不行,一百张A100也能跑出十张的效率。 Kubernetes现在是容器编排的事实标准。可它的默认调度器,处理批处理任务真不算强。科研任务往往是DAG,有前后依赖,有数据本地性要求,有抢占需求。于是有了Volcano、Kueue、YuniKorn。这些项目在社区里热度不低。 另一条线是Slurm。HPC老炮。用了二十年。简单、粗暴、稳定。很多超算中心至今靠它。小团队别硬上K8s。Slurm加Apptainer,够用。大团队要混合负载,再考虑K8s加Volcano。 GPU共享也得说。MIG能切七份,但显存隔离不完美。vGPU适合图形,不太适合计算。时间片共享?上下文切换开销能吃掉性能。拓扑感知更关键。GPU和GPU之间走NVLink还是PCIe,差别巨大。调度器不知道拓扑,就会把通信密集的任务扔到慢链路上。存储和网络:慢一次,全组骂你
科研数据有多大?冷冻电镜一天几个TB。基因组测序一次几十TB。气候模拟更别提。你弄个NFS,还单控制器?等着被骂吧。 并行文件系统是标配。Lustre、GPFS、BeeGFS,各有地盘。Ceph也能用,但调优门槛不低。对象存储适合冷数据,S3接口。热数据呢?得靠缓存层。JuiceFS这类方案,把对象存储当后端,本地做缓存,思路不错。 网络别省钱。万兆起步。IB或者RoCE,看预算。RoCE配置不好会丢包,丢包会让存储性能崩。DPU最近很火,能卸载网络和存储协议。但别为了追新而追新。先测实际IOPS和带宽。PPT上的数字,看看就好。科研高性能计算集群并行存储网络拓扑图