边界之外:区域协调发展技术的尺度错配与落地边界
九月的南京,梧桐叶刚泛黄。江北新区一栋写字楼里,一个做都市圈交通预测的课题组为一件小事争了半小时——住在滁州、马鞍山、句容,每天往南京主城跑的那批人,究竟该计入哪一级的需求模型。
争的不是数。是边界。
区域协调发展技术这个词听上去挺宏大,落到工程层面,处理的多半就是这么琐碎的事:一条行政界线,把一套本来自洽的通勤流、物流、水流,硬生生切成了两半。技术真正要干的,是在被切碎的数据上重新拼出一个说得通的空间叙事。
拼不好,后面全是错的。
边界不是一条线,是一组错配
很多人以为难点在“协调”两个字上。错了。卡点在“区域”。
行政区是一套单元,通勤圈是另一套,流域又是第三套,产业链的节点分布根本不认这些。同一个“长三角”,在统计口径里是三省一市,在手机信令里是一张连成片的点云,在长江口的水质模型里则是一条自上而下的物质输运链。三套单元互不重合,而任何一次测算,你都得先选定其中一套作为计算底图。
地理学里有个老概念,叫可塑性面积单元问题。同一份原始数据,按区县聚合和按一公里网格聚合,算出来的集中度、可达性、基尼系数可以差出一大截。这不是算法有 bug,是尺度本身携带了信息。你以为自己在测量现实,其实有一半在测量你选的框。
更麻烦的是数据在省界处的断裂。南京和滁州之间那条线,地图上清清楚楚,数据里却是一道断层——两边的口径、更新频率、字段定义、甚至“常住人口”的统计时点都可能不一样。跨省都市圈最费劲的活儿,往往不是建模,是把两套字典对齐。
手机信令能穿透边界,这是它的价值。但它有偏:老年群体、儿童、双卡用户的覆盖质量都成问题。用它算出来的跨界通勤比例,我见过偏差到让人不敢直接写进报告的。
 南京都市圈跨省通勤客流热力分布图
三层技术栈,和三处容易被忽略的失灵
把区域协调发展技术拆开看,大致分三层。
感知层。遥感、夜间灯光、信令、路网、断面监测。夜间灯光反演经济密度是个经典手段,但核心城区有饱和效应,中小城市信噪比又低,同一条回归曲线在不同规模的城市上表现完全不同。用它做跨区域比较,得格外小心。
建模层。可达性模型、投入产出表、多智能体仿真、复杂网络。这一层的边界条件极其刚性:参数标定依赖历史区间,而政策干预往往落在历史样本之外。换句话说,模型越精确地拟合过去,越可能在“如果”这类问题上给出漂亮而无用的答案。
治理层。隐私计算、联邦学习、区块链存证、数据沙箱。原理是数据不出域、只交换梯度或中间结果。听起来很符合跨行政区协作的诉求——毕竟没有哪个地方愿意把原始数据交出去。但代价是精度损失:噪声注入、梯度裁剪、样本对齐误差,都会在最终模型里累积成偏差。谁承担这部分误差,从来不是纯技术问题。
三层之外,还有三处经常被忽略的失灵。
其一,指标可操纵。一旦某种协同度、融合度被写进考核,它就会迅速被优化,然后失真。这是老规律了。
其二,溢出效应没有进入核算。一个城市的产业转移让邻市受益,这份收益不出现在任何一方的统计账户里,于是激励结构是扭曲的。
其三,平台建成即闲置。我见过不止一个区域一体化数据平台,大屏做得漂亮,半年后访问量归零,因为它的输出压根没有接口接进任何一项决策流程。数据可视化和决策支持之间隔着一条沟,这条沟不是技术能填的。
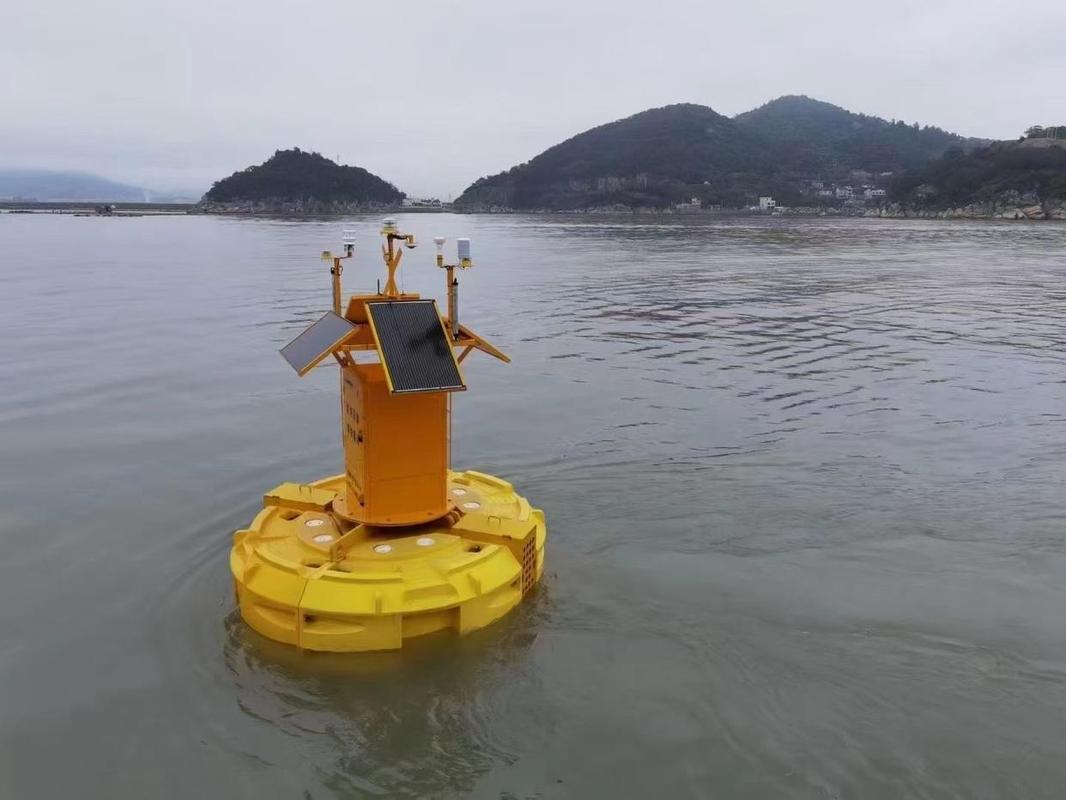 跨省流域断面水质自动监测浮标实景
可达性变好,不等于协调发生
 可达性变好,不等于协调发生
这里有个值得认真对待的争议。
交通可达性提升通常被默认为区域协调的正向指标。但高铁开通对中小城市的影响并不是单调的。如果本地缺少产业承接能力和要素成本优势,通勤时间缩短的结果可能是要素被更快地抽走——人才、消费、甚至本地企业的总部职能。通勤圈变成抽水管。反过来说,具备承接条件的城市,同样的时间压缩就能产生正向的产业外溢。同一个自变量,符号可以相反,取决于一组门槛条件。
生态补偿的核算也有类似麻烦。遥感反演的叶绿素浓度和水质浮标实测的数值,在阴雨、汛期、藻华爆发期会有显著偏离。补偿标准若直接挂在这些指标上,基准年怎么选、数据源用哪套,就成了博弈的焦点。技术上可解,但需要事先约定规则,而不是事后争论。
把技术嵌进机制,而不是替代机制
我的判断比较保守:技术在这里的角色是嵌入,不是接管。
可行的做法往往是先从场景小、规则清晰、收益可验证的地方切进去。跨省就医的费用核验、货运通行证的互认、流域异常断面的联合溯源——这些事情的共同点是,各方的利益边界足够清楚,数据交换的范围足够窄。窄,才谈得拢。
再往上一层,是联合实验室和驻场工程师这类看起来很“土”的安排。模型能不能用,往往取决于做模型的人有没有在对方的机房里坐过几个月。在宁的几所高校这些年跟周边地市做的合作,真正沉淀下来的东西,很少是算法本身,多半是一套双方都认的口径和流程。
评估标准也得换。别看平台访问量、数据条数、接入部门数。看它改变了几个决策。一个季度里,有没有一次规划调整、一次调度优化、一次资金分配,是因为这套系统的输出而改的。没有,就是零。
风险同样要摆上台面。数据安全与属地管理的张力、算法黑箱对问责的侵蚀,还有地方保护主义的技术化包装——用一套看起来很中性的指标,把既有的利益格局固化下来。这种情况不会因为技术更先进就自动消失。
接下来几年值得盯的几条线
 接下来几年值得盯的几条线
空间计算和隐私计算正在合流。过去做空间分析得把数据搬到一起,现在越来越多的工作可以在密态下完成,代价是算力开销和精度折扣。这个平衡点还会继续移动。
大模型进入政策仿真,是另一个方向。它能降低建模的门槛,让非专业的人也能提问。但它编造数字的倾向,在政策场景里是致命的。没有严格的约束和可追溯的数据链路,这类应用不该靠近决策。
数字孪生从单体城市走向城市群,跨区域的电力调度和碳核算耦合,这两块我个人比较看好,原因很朴素:它们有硬约束——物理规律不会因为行政区划而改变。有硬约束的地方,协调反而容易达成。
回到那个课题组。争到最后,他们决定做两套模型,一套按行政单元,一套按通勤网格,把差异本身当成结论写出来。
这个选择挺聪明的。区域协调的第一步,可能不是消除边界,而是先承认它在那儿。