客户需求分析的转译损耗:一份需求在传递途中被改写了几次
写过需求文档的人都碰到过这种局面——客户在访谈里说得很清楚,落到评审会上,工程师问的问题却像是另一个人提的。这不是理解力的问题。需求从客户嘴里出来,到变成一张原型图,中间要经过若干次转译,每一次都有损耗,而且损耗的方向并不随机。
我在南京江宁一家做工业视觉检测的公司待过两周。他们的产品经理把访谈录音转成文字,再把文字摘成要点,最后写成需求卡片。三步走完,客户原话里的“有时候会误报”变成了“需支持误报过滤”。听起来是一种提升,其实丢掉了一个关键信息:误报发生在什么条件下。后来现场排查发现,误报只出现在换批次的那个时段,跟过滤算法基本无关。
需求不是被“发现”的,它是在对话中被建构的
教科书里常把需求分析讲成勘探:地下有矿,你要挖出来。这个比喻省事,也危险。客户对自己痛点的表述,本身是一种即时生产。同一个采购负责人,上午说“我们要降低成本”,下午被问到产线停机损失时,口径就变成了“稳定比便宜重要”。
这不是客户在撒谎。人的偏好排序依赖于提问的框架。问“你最看重什么”,得到的是抽象表态;问“上周三那次停机,你们是怎么处理的”,得到的是行为证据。前者是态度数据,后者才是能拿去判断的数据。
所以访谈的第一件事不是准备问题清单,而是决定记录什么。我的习惯是:把客户说的原句、语气、以及犹豫的位置一起记下来。“这个……应该没问题吧”,和“这个没问题”,在后续判断里的分量完全不同。
 B端软件客户需求访谈现场白板便签记录照片
三次转译,三次走样
第一次转译发生在客户内部。你的访谈对象往往不是使用者。B端场景里,需求要经过“使用者—部门主管—采购或IT—你”这条链。每一环都会做一次过滤:使用者抱怨的是界面难用,主管听到的是人力浪费,采购听到的是预算必要性。你听到的往往是已经被组织语言包装过的版本,而包装过程本身是不自觉的。
第二次转译发生在你自己的记录环节。录音转文字、文字提炼要点,提取本身就是压缩。压缩会优先保留“可执行的动词”,丢掉“条件状语”。于是“换批次时会误报”变成“支持误报过滤”。可执行性上去了,信息完整性下来了。补偿办法不复杂:需求卡片上必须留一条原始语句,禁止只留结论。
第三次转译发生在跨职能沟通。需求从产品文档进入技术方案时,会被技术语言重新表述一遍。这一步的失真通常不是理解错误,而是技术约束反过来塑造了对需求的描述。工程师说“这个做不了”,有时候意思是“按你写的这个形式做不了”。
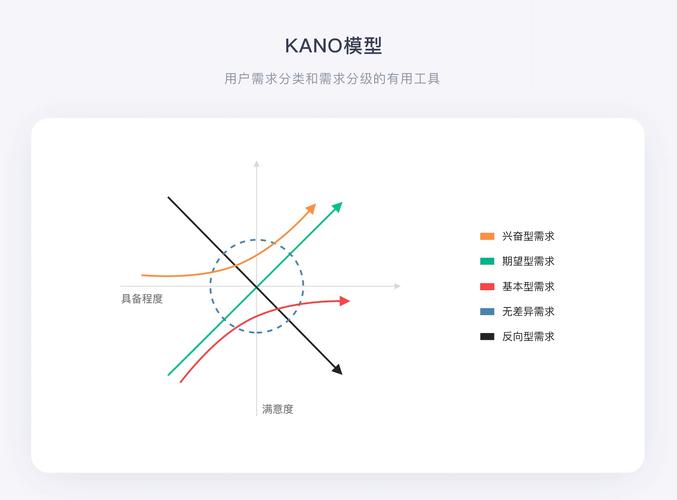 卡诺模型客户需求分类二维坐标手绘示意图
把问题从“问什么”挪到“看什么”
卡诺模型流行,问题也在这。它要求用户对功能做“具备与不具备”的双向评价,问卷回收快,结论也好画图。但它测的是态度,不是行为;测的是当下的想象,不是真实的取舍。对于既有品类里的迭代需求,这套东西够用;对于尚未成型的新场景,用户很难对没见过的功能给出可靠评价。
更靠得住的做法往往是反过来的:先看行为,再回头解释。
任务走查、关键事件访谈、现场观察,这三样的共同点是不依赖用户的自陈。有个做仓储系统的团队告诉我,他们的转折点是去仓库待了一整天,发现拣货员把扫描枪夹在腋下用,因为货架间隙不够转身。这个需求在三次访谈里从没被提到过——不是用户不愿意说,是他们不觉得那算“需求”。
数据埋点当然能补上规模,但它补的是“发生了什么”,补不了“为什么”。事件埋点告诉你某个按钮点击率低,不告诉你用户是不是压根没找到它。把定量和定性叠在一起看,成本高,误判率低。更关键的是,需求一旦被提炼成假设,就得能被证伪——最小可用原型、灰度发布、A/B 对照,这些都是检验手段,不是交付流程里的装饰。
方法有边界,边界比方法更值得记住
 方法有边界,边界比方法更值得记住
需求分析有一套成熟工具,但它的有效性是有条件的。
当需求方是单一决策者、场景相对稳定时,结构化访谈加原型验证的效率很高。当需求方是多角色、且角色之间利益不一致时,任何一份“统一需求文档”都可能只是把冲突推迟到了开发阶段。这时候更该做的是把冲突显式写出来,而不是折中成一句谁都不得罪的表述。
还有一个常见盲区:沉默用户。愿意接受访谈的人,本身就是筛选过的样本。抱怨多的人、配合度高的人、有空的人,会被过度代表。补这个缺口没有便宜办法,只能靠埋点数据、客服工单,以及主动去找那些从没提过需求的人。
反过来说,需求分析也有过度的时候。把每一个功能诉求都拉去做一轮访谈、问卷、建模,产出的是漂亮的文档和延后的决策。需求分析的产出应该是判断,而不是材料。材料越多,判断反而可能越慢。
工具变了,失真并没有消失
 工具变了,失真并没有消失
现在不少团队开始用大模型做访谈记录的摘要和聚类,效率确实提升了。但要注意,模型做的正是我前面说的第二次转译——压缩。它会倾向于生成结构整齐、术语规范的表述,恰好把那些凌乱的、带条件的、口语里的信息抹平。原话被摘要替代,损失的正是最值钱的那部分。
可行的折中是:让模型做分类和检索,人来做判断。保留原始语料库,任何一条结论都能回溯到某次访谈的某句话。做不到回溯,需求文档就只是一份自洽的文本,跟客户没什么关系。
需求分析的难点从来不在工具,而在于承认一件事:你拿到的永远不是需求本身,而是需求经过若干次表述之后的一个版本。知道它丢在哪一步,比多跑几轮问卷有用。