别只会在知网里打转:科技文献检索的硬功夫与野路子
师弟上周差点把键盘砸了。课题做钙钛矿组件稳定性,他在知网里输入“钙钛矿 稳定性”,筛了三天,越筛越虚。为啥?漏了封装、漏了衰减机制、漏了湿度应力。检索式没搭好,后面全是体力活。
先别急着敲关键词,检索式才是分水岭
说实话,科技文献检索的第一道坎不是数据库买没买,而是你能不能把问题拆成概念块。一个靠谱的起手式:把研究问题拆成三到四个块,每个块列同义词、近义词、缩写、旧称。比如做钙钛矿稳定性,概念块可以是 perovskite OR halide、stability OR degradation OR aging、encapsulation OR moisture。中间用OR撑开,块之间用AND收紧。
字段限定也别省。Web of Science里TS是主题,TI是标题,AB是摘要,AU是作者,PY是出版年。只搜标题?那真是跟自己的查全率过不去。截词符也香,degrad*能兜住degradation、degraded、degrading。邻近算子NEAR/n看数据库支持,有的平台叫W/n,别硬套。
 科技文献检索布尔逻辑检索式构建示意图
不过话说回来,查全和查准天生打架。检索式太宽,几千条,读到天亮;太窄,关键文献从指缝漏掉。我的笨办法是先宽后窄,分两轮跑:第一轮用宽式摸清领域脉络,第二轮加限定条件收口。年份、文献类型、语种都别一刀切,尤其是交叉领域,专利和会议论文经常藏着真东西。
引文网络不是玄学,是省时间的笨办法
找到一篇对味的论文,别急着下载完就关页面。看它的参考文献,那是往回走;看它的被引文献,那是往前追。Web of Science、Scopus、Google Scholar都有这功能。引文追踪特别适合刚进课题组的新人,比在关键词里瞎撞强太多。你顺着高被引综述摸一遍,领域里的老炮儿和争议点基本就浮出来了。
我见过有人把综述当圣经,整段整段抄背景。别。综述的价值是帮你找缺口,不是替你写引言。读的时候拿张纸,左边写已知共识,右边写打架的地方。打架的地方,往往就是选题的缝。
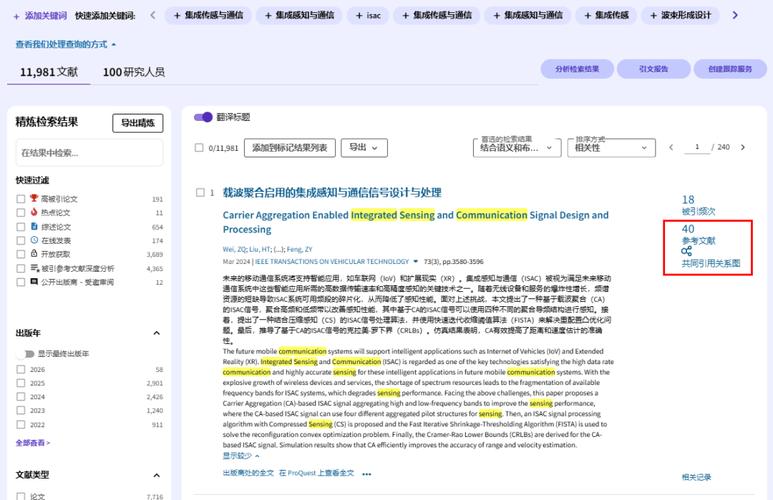 科技文献检索Web of Science引文网络追踪界面截图
近两年预印本越来越猛。arXiv、ChemRxiv、bioRxiv、SSRN,更新快,但没经过完整同行评议。用不用?用,但得标清楚状态。科研成果的时效性和可靠性要分开看。开放获取也在改变游戏规则,Plan S、NIH数据共享政策一推,很多论文和数据集能直接扒。Dimensions、Lens.org、OpenAlex这些工具,别只盯着传统库。
AI能帮你读,但别让它替你判断
现在一堆工具说自己能读文献。Elicit、Consensus、Scite、Research Rabbit,还有各种基于语义检索的插件。有用吗?有。尤其是做宽筛、找相关作者、看引用语境。但你要知道它们的底裤:大模型会编,语义相似不等于证据可靠。它给你一段总结,你得点回原文核。别拿二手摘要当结论,审稿人一眼就能看出来。
我自己的用法很土:AI只干三件事,扩同义词、初筛摘要、生成待读清单。判断实验设计、样本量、统计方法,还是得人眼过。尤其是医学、材料、能源这些领域,一个单位、一个测试条件没看清,结论能翻车。
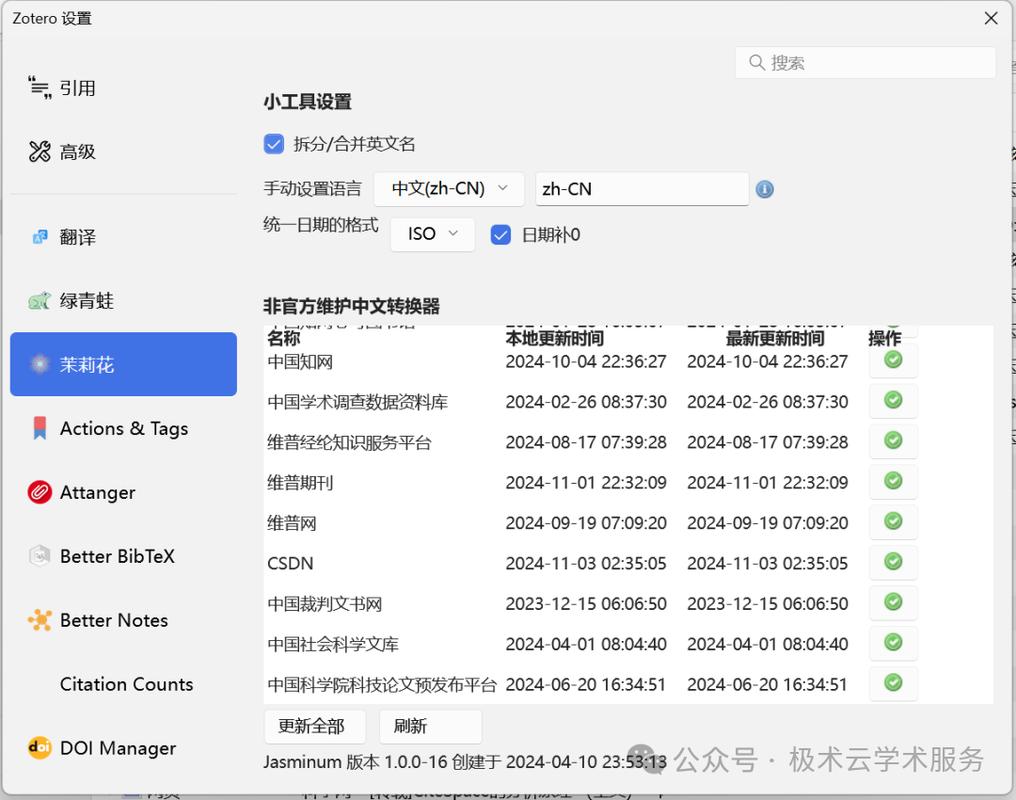 科研人员使用Zotero管理科技文献检索结果截图
把检索变成流水线:从问题到证据表
 把检索变成流水线:从问题到证据表
零散地搜,永远搜不完。得把科技文献检索做成可复现的流水线。第一步,写检索日志:数据库、检索式、日期、命中数、筛选规则。第二步,文献管理。Zotero、EndNote、Mendeley都行,重要的是统一命名和标签。第三步,去重、筛题、读全文,用PRISMA那套流程图逼自己记录为什么排除。第四步,建证据表:作者、年份、样本、方法、主要结论、局限。别看这表土,写讨论的时候能救命。
还有个小坑:别在同一个数据库里反复横跳。中文库、英文库、专利库、会议库,各有各的脾气。中文文献别只搜知网,万方、维普、CSCD也看看;英文别只搜Web of Science,Scopus、PubMed、IEEE Xplore按领域补。交叉领域更得撒网。
最后说句掏心窝子的:检索式是活的,不是一次性写完就供奉起来。每读十篇,回头改一次关键词。领域在动,你的词也得动。行了,我先去把师弟那个检索式重跑一遍。他还在等结果。