软件工程开发的下一个拐点:代码大模型别只看补全率
先泼盆冷水。代码补全率这个指标,好看,但很容易骗人。
我见过团队拿着大模型补全率从42%涨到68%的截图开会,气氛热烈。结果上线前一周,回归测试炸了。为什么?补出来的代码能跑,不等于能维护;能过单测,不等于能过评审。软件工程开发这件事,最怕把“生成速度”当成“交付速度”。
近期行业里最热的是代码大模型和Agent。GitHub Copilot、Codex类模型、各种“自动修issue”的智能体,演示视频一个比一个猛。科研圈也没闲着。SWE-bench这类基准把真实GitHub issue丢给模型,看它能不能改对仓库、跑通测试。说白了,这是把“写代码”往“改工程”上逼。好事。但别急着吹。
补全率好看,不等于工程能交付
补全率衡量的是“模型猜中下一个token/片段”的概率。工程交付衡量什么?可读性、可测试性、变更影响面、回滚成本、安全边界。两套语言。
有课题组做过对照实验:让两组开发者完成同一批需求,一组用AI补全,一组不用。短期看,AI组编码速度快了,主观爽感也高。但把代码评审意见数、缺陷逃逸率、返工时间算进去,优势就没那么夸张了。有的任务里,AI组甚至更慢——因为评审者要花额外时间识别“看起来对”的坏味道。这个结论不性感,但很真实。
说实话,我不反感AI写代码。我反感的是拿补全率当KPI。补全率高,可能只是模型学会了项目里的重复模板。真正难的是跨文件推理、隐式约束、领域规则。比如金额计算不能浮点、权限校验不能漏、幂等键不能乱生成。这些点,补全模型经常“自信地错”。
 软件工程开发代码大模型补全率评测实验场景图
实证研究把“感觉”拆成可测指标
软件工程开发有个老毛病:大家爱讲经验,不爱讲度量。AI来了,这个毛病被放大了。有人觉得AI提效,有人觉得AI添乱。吵没用。得做实验。
比较靠谱的做法是任务分层:脚手架代码、业务逻辑、测试代码、重构、缺陷修复,分开测。每层看不同指标。脚手架看采纳率和编译通过率;业务逻辑看缺陷密度和评审返工;测试代码看变异测试杀死率;重构看行为保持;缺陷修复看回归测试通过率和补丁最小性。别一锅炖。
还有个坑:基准污染。公开数据集里的题,模型可能见过。科研上要做时间切分、仓库隔离、私有评测集。工程上更直接——拿自己仓库最近三个月的真实PR做回放。让模型补丁进CI,跑静态检查、单测、集成测试、安全扫描。能过再谈提效。过不了,别吹。
我挺喜欢“AI当实习生”这个比喻。实习生写得快,你得review;实习生会幻觉,你得给上下文;实习生不懂历史包袱,你得把约束写清楚。区别是,实习生会成长,模型不会自动懂你的业务。所以上下文工程、检索增强、规则库、测试用例,都是配套活。只买模型不建配套,等于买了发动机不装底盘。
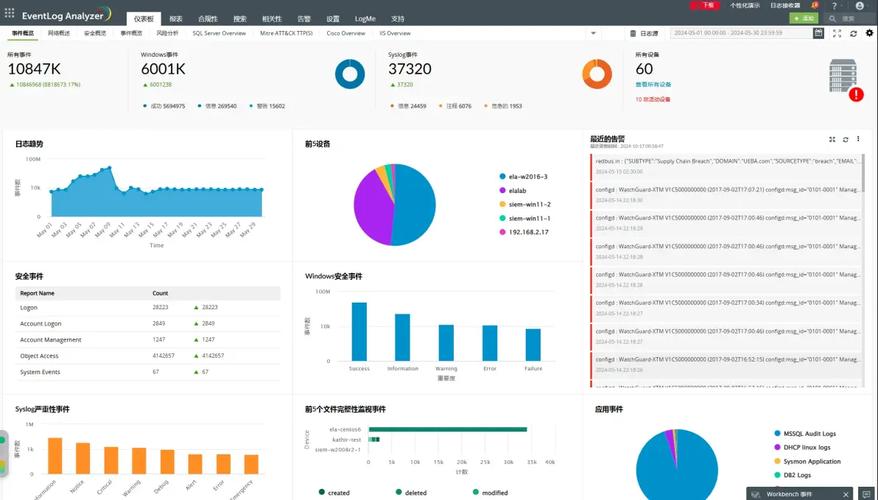 软件工程开发持续集成流水线失败日志分析界面图
供应链和形式化验证,别等出事才补课
再说个容易被忽略的方向:软件供应链。AI生成代码会引入依赖,依赖又会引入漏洞。SBOM、SLSA、依赖锁定、签名验证,这些词听着枯燥,出事时很要命。科研成果里,软件供应链安全已经不只是“扫描CVE”,而是往构建可追溯、制品可验证走。工程团队至少该做到:依赖清单可生成、构建过程可复现、关键制品有签名。
形式化验证呢?别一听就头大。不是所有系统都要上Coq/Isabelle。轻量级方法也能用:状态机建模、契约式设计、属性测试、模型检查。尤其是并发、权限、资金这类逻辑,写几条不变量,比堆一百个UI测试管用。科研上的趋势是降低形式化门槛,把验证嵌进开发流程,而不是另起炉灶。这个方向我谨慎乐观。成本还是高,但比线上事故便宜。
 软件工程开发软件供应链SBOM依赖关系图
落地建议:把AI当实习生,别当救世主
最后给几条不绕弯的建议。第一,先建评测集再采购工具。用自己仓库的真实任务,别只看厂商demo。第二,AI生成代码必须过评审和CI,别开“自动合并”的口子。第三,把提示词和规则库当代码资产管,版本化、可回滚。第四,度量要包含返工和评审成本,不然就是自嗨。第五,供应链安全别等审计前才补,SBOM先跑起来。
软件工程开发从来不是“写代码”三个字。它是协作、约束、反馈回路。代码大模型把写代码的门槛打下来了,这是真事。但工程的门槛没降,甚至因为生成量变大,评审和验证的压力更大了。对吧?所以别只盯补全率。盯交付。盯缺陷。盯回滚。盯那些半夜把你叫起来的东西。
嗯,就写到这。工具会换,基准会过时,可验证的工程习惯不会过时。