告警响到手机发烫:缓存雪崩后的经验教训总结
凌晨两点四十七。手机在床头柜上震,像一只被踩了尾巴的猫。
我摸起来看,值班群里已经刷了十几条。不是CPU告警,也不是磁盘写满——是数据库连接数。曲线直挺挺往上蹿,像南京梅雨天墙角的霉斑,压都压不住。
那晚我们刚做完一次商品详情页的缓存调整。说白了,就是把过期时间从零散的配置统一成三十分钟。图省事。真的,就是图省事。结果整点一过,一批key同时失效,请求像退潮后突然发现桥断了的人群,全涌向数据库。
我先说结论:缓存不是挡箭牌,它自己也会反咬一口。这篇经验教训总结,不写漂亮话,只拆那晚到底发生了什么、哪些假设靠不住、后来怎么补的。
那晚先崩的不是数据库,是连接等待队列
很多人一听“数据库被打挂”,脑子里就是CPU飙到百分之百。不是。至少我们那次不是。
数据库的CPU只到六成多。真正疯掉的是应用侧的连接池。连接池你可以理解成一排公用电话亭:应用线程想查库,得先抢一个亭子。亭子就那么多,外面排队的人越来越多。线程池里的线程全卡在“等连接”上,新的请求进来,连处理的人都没有。
然后接口超时。然后上游重试。然后更多请求涌进来。
看,雪崩不是一瞬间塌的,是一层一层传下去的。缓存命中率掉下去,数据库连接数顶上去,应用线程堵住,网关超时,用户刷新,流量再翻一倍。每一环都觉得自己只是慢了一点,合起来就是一场小型灾难。
 电商大促Redis缓存雪崩监控连接数告警大屏
说实话,那晚我盯着监控大屏,脑子里冒出来的不是架构图,是早高峰的地铁站。闸机没坏,列车也没坏,就是人全堵在换乘通道里。你再加开一列车,通道里的人也上不去。
缓存雪崩、击穿、穿透,别一锅炖
事后复盘,有人张嘴就说“缓存穿透了”。不对。这三个词经常被混着用,但处理手法不一样,混了就容易开错药。
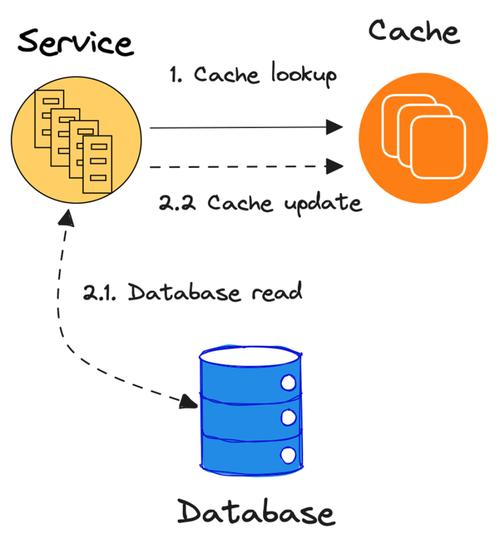
雪崩是大批key同时过期,或者缓存实例整体不可用,请求集体落到后端。击穿是某个热点key过期,瞬间大量请求去重建它。穿透是查一个数据库里也没有的数据,缓存不存空值,每次请求都穿过去。
我们那晚是雪崩,带一点击穿。因为有几款促销商品是热点,过期时间被统一改成了整点失效。整点一到,它们同时“裸奔”。
原理不复杂。缓存本质上是用空间换时间,把慢查询的结果放在内存里。可内存有容量边界,也有时间边界。TTL一到,缓存项就没了。如果大量缓存项的TTL设成同一个值,它们就会像约好了一样同时消失。后端数据库面对的瞬间压力,不是线性增长,是台阶式跳变。
类比一下:小区门口有个快递架,平时大家下班顺手取走。突然物业把整架快递全退回驿站,所有人同一分钟涌到驿站窗口。驿站没扩容,队伍就炸了。
所以后来我们做了几件事,不花哨,但管用。
给TTL加随机抖动。三十分钟的过期时间,实际写成二十五到三十五分钟之间的随机值。别小看这几分钟,它把同时失效的尖峰打散了。
热点key逻辑过期。物理上不设短TTL,值里带一个过期时间戳。读到时发现逻辑过期,先返回旧值,同时异步去刷新。用户感知不到卡顿,数据库也不会被瞬间打穿。
互斥锁重建。热点key失效时,只放一个请求去查库重建,其他请求短暂等待或返回旧值。锁要有超时,别把等待变成新的死锁。
再补一句,空值缓存也得做。查不到的数据,短时间缓存一个空标记,能挡住不少穿透型请求。但空值TTL别太长,不然数据补上了还读不到,用户会骂人。
 缓存击穿导致数据库连接池打满架构示意图
复盘时扎心的一条:我们只压了QPS,没压连接数
 复盘时扎心的一条:我们只压了QPS,没压连接数
压测那天,报表挺好看。QPS达标,平均响应时间也漂亮。可我们忽略了一个东西:连接数。
QPS是每秒请求数,连接数是同时占着的资源。两者不是一回事。短查询能把QPS撑很高,但连接占用时间一长,连接池照样见底。我们那次的慢查询不算多,可每个请求都在等连接,等待时间把连接占用拉长了,恶性循环。
这就是常见误解之一:压测只看吞吐,不看资源等待。后来我们在压测脚本里加了连接池活跃数、等待队列长度、缓存命中率三个观测点。阈值也不是拍脑袋,按历史峰值加三成余量,再留人工降级开关。
另一个误解是“上了Redis集群就高可用”。集群解决的是节点故障和数据分片,不解决你的代码把一批key设成同一时间过期。工具是工具,策略是策略。
还有变更管控。那晚的配置改动走的是“小改动快速上线”,没走完整的评审。经验教训总结里必须写这一条:凡是碰缓存过期时间、连接池大小、限流阈值的变更,都按高风险变更处理。不是流程官僚,是这类参数一出事就是面状故障,不是点状故障。
边界:没有一套缓存策略能包打天下
 边界:没有一套缓存策略能包打天下
话说回来,别听完就去把所有key改成永不过期。那会带来一致性问题。商品价格、库存这种数据,旧值返回太久,用户下单时看到的价格和结算价对不上,客诉比宕机还难缠。
逻辑过期适合读多写少、能容忍短暂不一致的场景。互斥锁重建适合热点集中、重建成本可控的key。多级缓存能扛更高读流量,但本地缓存和远程缓存之间又多了一层同步成本。限流能保命,但阈值太紧会误杀正常流量,阈值太松等于没限。
所以边界比方案更重要。你得先问:这个接口能容忍多旧的数据?后端重建一次要多久?连接池和线程池的比例是多少?降级后返回默认值,业务能不能接受?这些问题不回答,抄一套“高可用缓存方案”回去,大概率是换个姿势踩坑。
那晚之后,我们把这份经验教训总结贴在工位隔板上。不是为了好看。是为了下次手抖改配置时,抬头能看见那句:先想失效,再想缓存。
凌晨的告警声,我至今记得。手机发烫,人发懵。但也正是那次,让我们把“缓存命中率”从报表角落挪到了告警首页。教训这东西,写下来不算完,得变成阈值、开关和演练,才算真的总结过。