告警变少之后:智能运维管理的证据链与反例
告警少了。值班屏幕干净了。然后呢?
这两个月我看了几套运维平台的验收材料,演示环节几乎都从“告警压缩率”开始:原来一天几千条,现在几十条。数字很漂亮。问题也在这里——告警变少并不自动等于系统更稳。如果压缩过程不可追溯,漏掉的那部分信号会变成事后解释不了的空白。
降噪的收益,和它藏起来的暗面
告警风暴治理是刚需。阈值告警在高基数、强波动、频繁变更的环境里会反复抖动,值班人员被噪声拖垮,真正故障反而被淹没。事件归并、去重、抑制、依赖收敛,这些手段有明确收益。
但收益有代价。典型做法是把同一拓扑邻域、同一时间窗内的告警合并成一个事件。合并规则依赖实体对齐和依赖关系。依赖关系错了,事件就会被合错。比如一次数据库连接池耗尽,先触发应用超时,再触发网关5xx,随后触发主机负载告警。若系统只按时间窗合并,可能输出一条“网关异常”,把根因埋在下游。过一会儿告警继续减少,值班人员以为恢复了;实际上只是抑制窗口还没结束。
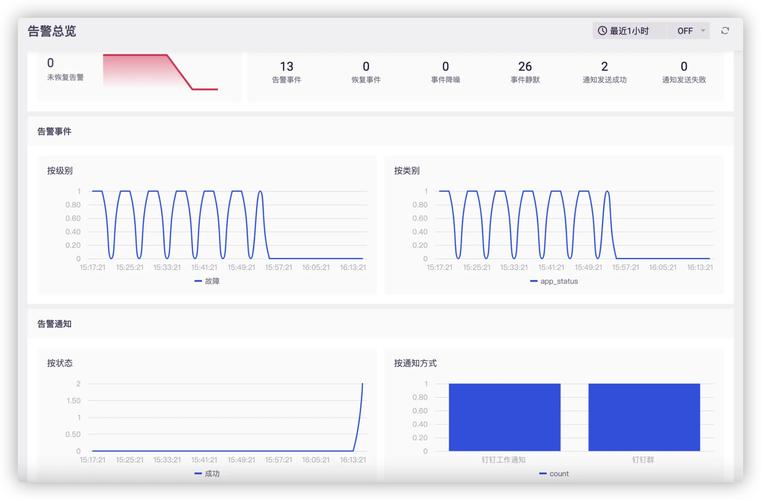 数据中心告警风暴事件归一与关联分析界面
这里有个容易被忽略的条件:智能运维管理的降噪必须同时报告“压掉了什么、依据是什么、如何回放”。只报压缩率,不报召回率,不报证据链,验收就只剩展示价值。非平稳环境里,昨天的抑制规则今天可能失效;变更频繁的系统里,拓扑关系一天能变好几次。没有变更事件参与,归并规则很容易把新故障误判成旧噪声。
我不反对降噪。我反对把降噪当成终点。告警数量是结果,不是证据。
根因定位不是相关性游戏
智能运维管理常被描述成“多源数据+异常检测+根因分析”。听起来顺。做起来卡在数据层。指标、日志、调用链、变更、工单、配置项,各有各的实体标识。主机名、Pod名、服务名、实例ID对不齐,后面的因果图就是空中楼阁。高基数标签还会带来维度爆炸,异常检测在训练集上表现不错,上线后因为新版本、新节点、新路由规则迅速漂移。
更麻烦的是标签。故障样本稀疏,标注成本高,很多团队用值班记录反推标签。值班记录写的是“网络抖动”,真实原因可能是连接池配置变更。相关性模型会学到“网络指标异常→网络抖动”,因果图未必。根因定位要的是假设生成与验证,不是相似度排序。调用链能给出跨层依赖,变更事件能给出时间锚点,拓扑能给出影响面,日志模板能给出错误类型;这几类证据必须能互相印证。只有相关性,没有反例检验,模型很容易把伴生现象当原因。
 微服务调用链拓扑与变更事件根因定位示意图
实现路径可以拆成几层:事件归一先把不同来源的告警映射到同一实体;拓扑与变更关联把“谁依赖谁、谁刚改过”补进来;假设生成给出候选根因;验证环节用检查项、回放数据或人工确认排除伪因。每一层都要留下版本和置信度。没有实体对齐和变更关联,根因定位会退化成告警聚类。这话不好听,但现场经常如此。
自动执行的门槛在门外
 自动执行的门槛在门外
从推荐到自动执行,中间隔着一道门槛。门槛上写着四个词:影响面、可逆性、置信度、审计。
误报的代价是打扰。误操作的代价是故障扩大。自动重启、自动扩容、自动切流、自动回滚,动作越靠近生产流量,越需要门控。置信度低时只给建议;影响面大时转人工;不可逆动作必须双人确认;所有执行要有审计轨迹和回滚方案。影子模式、离线回放、灰度发布、混沌演练,这些不是上线后的补丁,是上线前的门槛。
这一步不能省。省了就要付学费。模型在演示环境里准确率再高,也扛不住一次错误的批量重启。自动执行还要防反馈回路:系统自动抑制了某类告警,训练数据里这类样本变少,模型逐渐认为它不重要,下一次真故障来了反而没有信号。智能运维管理的自动化必须以可观测性为前提,以可回滚为边界。
边界比模型更硬
 边界比模型更硬
有些环境不适合急着上自动根因。强监管、强安全隔离、遗留系统多、变更流程不透明的场景,数据出不去,模型进不来。冷启动阶段故障样本少,知识图谱靠人工维护,维护成本会吃掉收益。跨云、混合云环境里,观测数据口径不一,时间同步都可能出问题。这些边界不解决,模型再花哨也只是演示。
组织因素同样硬。变更管理不规范,根因分析就缺少关键证据;值班流程不沉淀,标签就永远稀薄;SLO不清晰,告警优先级就无法校准。这套东西不是买一套工具,而是把观测、变更、值班、复盘连成闭环。闭环里每个环节都要有责任人,否则模型输出的建议没人敢用,用了也没人认。
验证方式也要克制。离线指标好看,不等于线上可用。回放历史故障能测召回,影子模式能测误报,灰度能测影响面,混沌演练能测恢复路径。四件事做完,再谈自动执行。顺序反了,风险就来了。
告警少一点当然好。先问一句:少掉的那部分,证据还在不在?