开源技术应用:一行import引发的半夜告警,聊聊开源组件怎么用不翻车
凌晨两点十七分。手机在床头柜上震得像个电钻。我摸起来一看,Prometheus告警:订单服务的P99延迟飙到8秒。说实话,本能反应是数据库又抽风了。登录跳板机,top一看,CPU正常,内存曲线却在爬坡——像极了周一早上的地铁客流。查了四十分钟,最后锁定在一个上周随手引入的开源JSON解析库。
它确实快。benchmark数据漂亮得离谱。但默认配置里有个缓存,会把每个请求的schema都存下来,而且没有上限。请求量一上来,堆内存慢慢被吃掉,GC开始频繁停顿。你猜怎么着?README里压根没提这一茬。文档角落里有一行小字:cacheSize默认值0表示无限制。我盯着那行字,心里骂了一句:这算什么默认值?
这就是我头一回认真琢磨开源技术应用这件事的起点。不是“用不用”,而是“怎么用不翻车”。
开源技术应用,不是把代码拖进IDE就完事
很多人对开源技术应用的理解,停留在“免费拿代码”。打开GitHub,搜关键词,找到个star多的,复制安装命令,跑通demo,完事。对吧?我也这么干过。但说实话,开源组件不是一块砖,搬过来就能砌墙。它是一棵活的树——有根、有枝、有虫、有枯叶。
你引入一个开源库,到底引入了什么?
表面上是几行import。实际上,你引入了一组外部依赖:它的作者、它的发布节奏、它的许可证、它的传递依赖、它的安全公告、它的社区氛围。这些东西不会出现在你的代码里,但会在某个凌晨两点十七分,变成一条告警。
拿包管理器打个比方。npm、pip、Maven,像外卖平台。你在上面点了一份“JSON解析”套餐。平台显示月销百万,评分4.9。你下单,五分钟送到,代码跑通。但厨房卫生你看不见,食材来源你看不见,配送员有没有健康证你也看不见。开源技术应用也一样——代码可见,不等于风险可见。
更麻烦的是传递依赖。你只写了import A,但A依赖B,B依赖C,C又依赖D。你的依赖树可能几百个节点。你锁定了A的版本,锁不住B、C、D。某个底层库被曝出CVE漏洞,你的构建扫描突然飘红。然后你发现,那个库已经三年没更新了,issue区一片哀嚎,维护者说“我没时间”。
 开源软件依赖树漏洞扫描报告截图
所以开源技术应用的入门课,不是学某个框架的API,而是学依赖管理。锁定文件(lockfile)是底线。CI里跑依赖扫描是底线。定期看changelog也是底线。这玩意儿像体检——你不想做,但做了能少进急诊。
许可证那页你没读,法务读了
另一个坑,更隐蔽。我见过一个创业团队,产品做得很顺,融资也顺利。直到尽调时,法务发现他们嵌了一个AGPL的数据库中间件。什么概念?AGPL要求:如果你通过网络提供服务,用户能和这个软件交互,那么你也得把修改后的源码开放。他们没改,但嵌了。法务建议换组件。换组件花了三周,连带改了一堆接口。
很多工程师看到MIT、Apache 2.0就放心了。看到GPL就绕道。但实际情况更细。Apache 2.0有专利授权条款——这其实是好事,它保护你免受贡献者专利诉讼。MIT最宽松,几乎随便用。GPL是“传染型”:你的衍生作品也得GPL。AGPL把“网络服务”也算作分发。
常见误解:“个人项目用了没事,公司项目也能用”。错。公司分发软件时,GPL代码会要求你开放整个链接部分的源码。不是“用了GPL的库就全开源”,而是“链接形成单一作品时,你得遵守”。具体边界得看怎么链接、怎么调用、怎么分发。这事不能靠猜。你得读许可证原文,或者让法务读。
打个比方。开源许可证像小区门禁卡。MIT卡:你能进自己楼栋,也能带朋友进。Apache 2.0卡:除了进门,还给你一份专利互不侵犯协议。GPL卡:你进别人家可以,但如果你改了房子结构,得把图纸公开。AGPL卡:你在家开民宿也算经营,图纸也得公开。
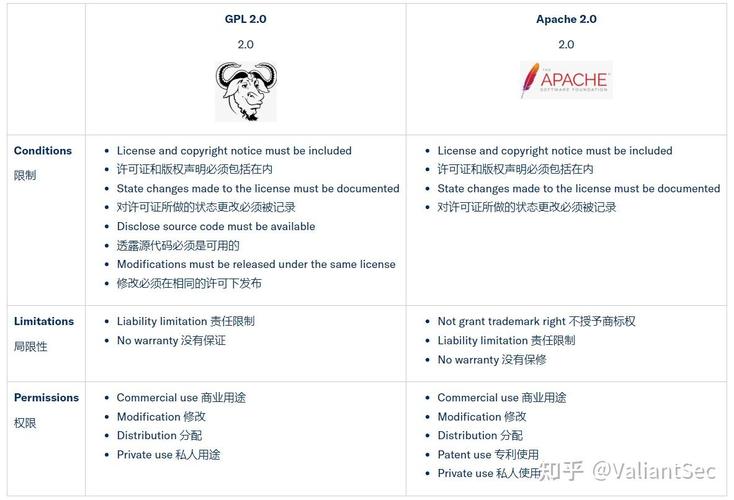 开源许可证GPL与Apache2.0条款对比示意图
不是不能用GPL。Linux内核就是GPL。很多公司基于GPL做内部工具,不分发,没问题。但一旦你把它嵌进SaaS产品对外服务,边界就变了。开源技术应用的“应用”二字,包含合规应用。别等法务来找你。
社区活跃度比Star数重要
 社区活跃度比Star数重要
选开源组件时,很多人先看Star数。Star多当然好,说明有人气。但人气不等于维护。一个停更两年的库,即使有二十k star,你敢用吗?CVE漏洞出来,谁打补丁?
我自己的检查清单,大概这么几条:最近半年有没有commit?issue平均响应时间多久?有没有商业公司或基金会背书?版本发布有没有规律?有没有安全策略文件?这些比Star数实在。说实话,一个每周发patch的冷门库,比一个半年没动静的热门库更让人放心。
不过话说回来,社区活跃度也有陷阱。有些项目commit很勤,但全是文档 typo 修复。有些项目版本号跳得飞快,API天天变。你得看commit内容,看release notes。别只看绿色小方块。
开源技术应用的长期成本,很大一块是盯社区。用Dependabot或Renovate自动提PR是省事,但别自动合并。你得看diff。一个次版本号升级,可能悄悄改了默认超时时间,也可能把某个方法的空值处理逻辑改了。这些不会写在标题里。
自己动手改?先想清楚维护成本
还有一种常见冲动:遇到bug,直接fork仓库,自己改。爽。改完跑通,提PR。但维护者不合并怎么办?你只能维护自己的分支。下次上游更新,你得手动merge。日子一长,你的分支和上游越差越远。最后变成你一个人在维护一个没人用的内部版本。
我见过一个团队,为了让某个开源报表工具支持他们的权限模型,fork了核心代码。改了三千行。两年后,上游重构,他们完全跟不动。想换商业方案,数据迁移又麻烦。就这么吊着。
开源技术应用不是不能改,但要算账。改之前问自己:这个改动能不能通过插件、配置、扩展点实现?上游有没有相关issue?维护者态度如何?如果一定要fork,你团队有没有人力长期跟?如果答案都是“没有”,那可能换组件更划算。
局限与风险,说白了两条:安全风险和维护风险。安全风险靠扫描和更新;维护风险靠选型和预算。开源不是银弹。有些场景,商业软件带SLA,确实省心。比如你需要一个支持千万级并发的消息队列,又没专人研究调优,那花钱买支持不丢人。开源技术应用的核心是“用合适的东西解决合适的问题”,不是“全用开源才纯粹”。
凌晨四点。我把那个JSON库降级,加了缓存上限配置,重启服务。告警停了。窗外南京的雨刚停,楼下早餐摊开始支棚子。我靠在椅背上想,下次还会因为别的东西响。开源技术应用这件事,用得好是杠杆,用不好是债。别只看import那一下爽——后面的依赖树、许可证、社区、维护成本,才是真正的账单。