把摩擦当作材料:用户体验设计的边界与可验证性
南京一家做工业软件的公司曾把“一键完成”写进产品卖点。上线三个月,任务完成率升了,返工率也升了。操作员说不清参数为什么被改,只能在群里问。这个反例说明,用户体验设计的核心并非把摩擦清零,而是把摩擦放在可解释、可恢复的位置。
这句话听起来像常识。落地时却常被指标挤到一边。
摩擦的账本:谁在承担认知成本
交互设计里有个老框架:执行与评估的鸿沟。用户想做什么、界面能否承接、结果是否可见,三段中任何一段断裂,认知成本就会转移。转移到哪里?转移到培训、客服、返工、灰色表格。它们不在界面上,却在组织里。
所以“减少点击”不是无条件正确。工业控制台里,一次高风险参数修改需要二次确认;医疗开嘱系统里,剂量单位要强制复核。这类摩擦是安全阀。把它删掉,效率指标会好看一阵。然后呢?一次误操作就够把账翻回来。
但也不能反过来给所有摩擦辩护。真正的区分在于:摩擦是否帮助用户建立正确的心理模型,是否可撤销,是否与任务风险匹配。探索型任务中,适度的信息揭示能降低迷航;高频重复任务中,多余确认就是噪声。条件不同,答案不同。
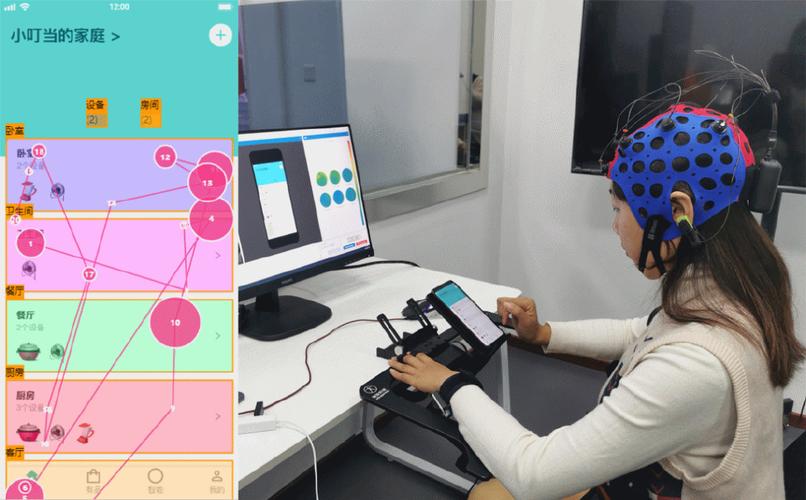 南京工业软件企业用户体验设计可用性测试眼动追踪场景
可访问性常被放在项目末尾。这个位置本身就会制造摩擦。键盘焦点顺序、对比度、错误提示的语义,都是结构问题,不是皮肤问题。等到视觉定稿再补,成本会翻倍。更麻烦的是,补出来的往往是“能过检查”的版本,不是“能完成任务”的版本。
指标会撒谎,证据链不会
NPS、任务完成率、平均耗时,都是好指标,也都容易被局部优化。把“完成”定义成点到某个按钮,完成率当然会上去。把“耗时”压缩到忽略错误恢复,速度也会上去。指标没有错。错在只用一层指标就宣布设计成立。
更稳妥的做法是搭证据链:行为日志说明发生了什么,可用性测试说明为什么发生,访谈说明用户如何解释,眼动或回放补充注意分配。几类证据互相咬合,才能区分“用户学会了”与“界面变好了”。这两件事经常被混为一谈。
南京有高校的人机交互实验室与软件企业做联合测试,做法值得参考:同一任务在实验室与真实工位各跑一轮,记录操作路径、停顿点、求助次数,再把异常片段回放到设计评审。不是追求漂亮报告。是让争论有共同对象。产学研合作在这里的价值,不是谁给谁背书,而是把可复现的观察带进产品决策。
 移动端政务服务平台老年人无障碍操作路径观察记录
当然,证据也有边界。实验室样本小,真实场景噪声大;A/B测试能回答“哪个版本转化高”,却很难回答“用户是否被诱导”。高风险的公共平台尤其如此。把暗模式包装成增长实验,短期数据会奖励它。伦理债却留给后面的人。
可验证的设计:从界面到组织
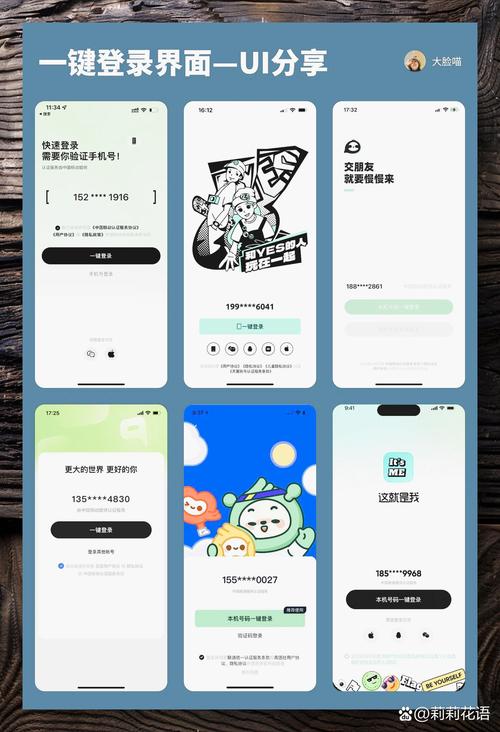 可验证的设计:从界面到组织
设计系统常被当作组件库。组件库只解决一致性的一小段。真正的设计系统要写清楚使用条件:这个确认弹窗适用于不可逆操作,那个空状态适用于首次进入,错误文案必须给出下一步。没有条件说明,组件就会被误用。误用一次,用户就得重新学习一次。
AI生成界面把这个问题的难度抬高了。模型可以快速产出多个布局,但生成不等于可验证。它不知道业务的风险等级,也不知道某类用户的操作习惯。可行的路径是把生成结果放进受控评估:规则检查、任务走查、小流量灰度、可访问性回归。灰度不是万能药。它只能降低试错成本,不能替代对边界的判断。
应用边界也需要说清。消费级应用的“顺滑”逻辑,不能直接搬到工业控制、医疗、金融风控。后者更看重可解释、可追溯、可恢复。反过来,高风险场景的确认机制也不该无差别复制到内容浏览。设计方法没有普适解。只有条件、取舍与验证记录。
讨论到这里,问题仍未闭合。用户体验设计既要面对人的有限理性,也要面对组织的指标压力。把摩擦当作材料,意味着先问“这个摩擦在帮谁”,再问“我们拿什么证据判断它有效”。这两问不浪漫。却比一句“提升体验”更接近可操作的工作。