梧桐树倒了,网还在——抗风险技术设计到底在“设计”什么
台风过境南京那晚,我记得特别清楚。凌晨两点四十,楼下那排梧桐倒了两棵,压断了架空光缆。小区业主群瞬间炸了——宽带全断。可奇怪的是,我手机还能刷,家里那台老路由默默切到了4G备份卡上。第二天早上八点,宽带抢修队还没到,物业群里已经有人在问“谁家WiFi能借一下”。
这事儿让我琢磨了很久。抗风险技术设计,压根不是在“设计一套不出事的系统”,而是在设计“出事之后还剩几条命”。
这个区别特别要命。前一种思路会让你拼命堆料、堆冗余、堆监控;后一种思路会让你坐下来,认认真真算一笔账:如果我只能剩一半,剩四分之一,剩个零头,系统还能不能喘气。
先问一句难听的:你的系统扛得住“少一半”吗
我做项目评审有个习惯,不问“峰值多少QPS”,问“砍掉一半机器,多久会挂”。
十次里有六次,对方会愣住。然后支支吾吾说,这个……没测过。
这就很尴尬了。因为你买的那些服务器,本质上不是买给“正常日子”用的,是买给“不正常日子”用的。正常日子里,一台机器跑满都嫌浪费。真正的问题是:坏掉两台的时候,剩下那些能不能多扛一会儿,扛到你把坏的修好。
这有个专门的说法叫容量余量,业内常说的N+1、N+2,意思是你实际需要N份能力,就备上N+1份。听着像废话对吧?可现实中大量系统是“N就等于需求上限”,也就是一根弦绷得死死的。弦一断,不是音不准,是整个琴塌了。
 数据中心双路市电ATS自动切换配电柜实物接线图
我常拿新街口地铁站早高峰打比方。早高峰人挤人,站务员会栏杆一拉、限流——不是不让你进,是让你慢点进。这就是典型的降级:通行能力降了,但秩序保住了,没出事。你换成“谁也别进、闸机全关”,那叫宕机;换成“全部放开、随便冲”,那叫雪崩。
好设计里都藏着这个“限流栏杆”。恶性的设计里一个都没有。
失效得“可预期”,这才叫设计
咱们这行有个词叫失效模式。说白了,东西坏的时候,它选哪种坏法。
电梯断电是抱死的——刹车咬住,人困在里面,但不会掉下去。这叫失效安全。汽车爆胎是还能滑一段的——这叫带病运行。而很多软件系统的坏法是……沉默。
沉默最坑。
你想想那种情况:服务A调服务B,B卡死了,不返回、不报错,就一直挂着。A等了三十秒,超时重试,又发一遍。B积压了五万个请求,内存涨到98%,最后OOM。整条链路像多米诺骨牌,一张压一张地倒。
这里头其实一个硬件都没坏。全是“坏得不明不白”搞出来的。
所以真正做过线上系统的人,会在A和B之间塞一道闸:熔断器。原理和家里老式保险丝一个意思——电流大了我主动烧自己,保住后面的线路。软件里的熔断器有三态:关、开、半开。开着的时候直接拒绝请求,不往下发,这叫“快速失败”;过一会儿进入半开,放几个探子过去试试水深,能过就复位,不能过继续关。
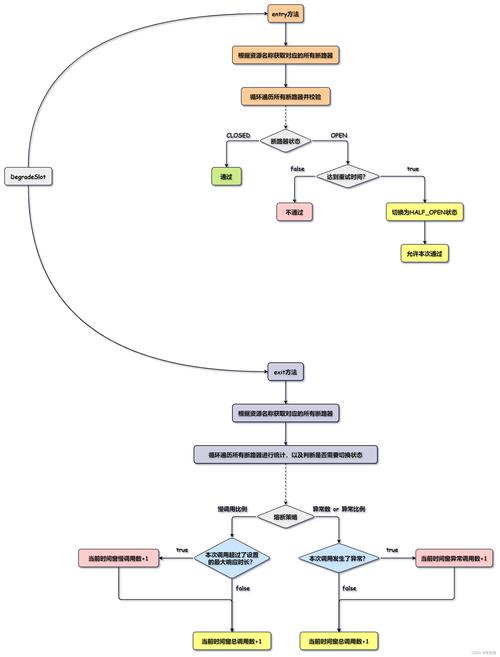 微服务熔断器三种状态流转示意图 半开状态
这套东西的意义在哪儿?在于它把“不可控的慢”换成了“可控的错”。
慢是最恐怖的。慢会让线程池耗尽、连接池耗尽、队列堆积,一路传染上去,最后你看到的是全站挂,但你根本找不到根因在哪。错是可控的——错就错了,返回一个兜底页面,用户骂两句,但系统还活着。
说实话,把“慢”变“错”,是我认为抗风险技术设计里最反直觉、也最值钱的一条。
降级开关得有“手”,不能只长在代码里
 降级开关得有“手”,不能只长在代码里
聊到这儿必须吐个槽。
我见过不少团队,降级逻辑写得漂漂亮亮,熔断、限流、缓存兜底、异步补偿,一样不落。但你问他“现在线上能不能把推荐模块关掉”,他说:得改代码、走发布、大概四十分钟。
四十分钟。事故窗口期早就过去了。
降级必须是“能立刻拉闸”的,而不是“需要重新布线”的。所以那些配置中心、特性开关、动态开关,存在的意义不是让代码显得高级,是让值班的那个倒霉蛋在凌晨三点有个能按的按钮。
更进一步,这个按钮还得有人知道在哪。
我一直坚持一件事:每个季度至少做一次真实的演练——真的把主库切到备库,真的把某个模块关掉,真的拔掉一根网线。不是看文档,是动手。文档上写“主备切换预计30秒完成”,实际切过去要四分钟,还丢了三条数据——你不演练,这个真相就永远躺在事故报告里。
有句话我特别认:没演练过的预案,约等于没有预案。没恢复过的备份,约等于没有备份。
几个被说烂了、但其实经常搞反的地方
 几个被说烂了、但其实经常搞反的地方
第一,冗余不等于抗风险。
见过太多“双活”其实是一个机房里的两台机器、一路市电、一个交换机。地一淹、电一停、网一断,双双阵亡。还有人做了“主备两个负责人”,结果这俩人是同一个人。这类冗余叫自欺欺人。
真正的抗风险得看失效是否独立。两套东西会不会同时因为同一个原因坏掉?如果会,那本质上只有一套。
第二,监控不是抗风险,监控只是“看见”。
能报警,不代表能扛住。很多团队把大屏做得跟航天指挥中心似的,红点一闪一闪,然后呢?没有然后了。看见问题到解决问题之间,隔着预案、权限、演练和那个敢拍板的人。
第三,也是最容易搞混的——抗风险设计的对象不是“故障”,是“不确定性”。
故障你多少能猜到:硬盘会坏、网络会抖、内存会漏。不确定性猜不到:某个下游突然改了接口、某个运营活动流量翻了二十倍、某天早上微博热搜挂了你的名字。
所以好的设计里都留了“缓冲垫”:超时时间不写死、队列长度可调、线程池能动态扩、开关能热更新。这些东西平时看着像洁癖,出事的时候全是救命绳。
但它有价格,别装看不见
说到这儿我得泼盆冷水。
抗风险设计是有成本的,而且成本不低。多一套冗余,就多一套要维护、要监控、要升级、要出故障的东西。系统复杂度上去以后,复杂度本身就成了新的风险源——本来只想防一个坑,结果挖出三个坑。
我见过一个内部工具,日活不到两百人,搞了异地双活、消息队列、服务网格、链路追踪,一套下来运维要三个人。上线三个月,事故全是从这套“高级架构”里冒出来的。这就叫过度设计的反噬。
合理的做法是先问三个问题:坏了会怎样?多久能恢复?代价谁承担?
如果坏一小时损失几千块,那你大可不必上异地多活。如果坏十分钟就是几百万,那再多投入都不算多。风险这件事,从来不是“越多越好”,是“匹配就好”。
最后说个我自己的体会。做了这么多年,我越来越觉得抗风险技术设计的核心不是技术,是一种心态——默认自己会输,然后想清楚输到什么程度还能站起来。
就像那天晚上倒下的梧桐树。它倒了,光缆断了,可网络在几秒钟内换了条路走。没人鼓掌,没人注意,第二天早上大家照样刷视频。
最好的抗风险设计大概就是这样:它存在感极低,只在最糟的那几分钟里,悄悄替你顶了一下。