数据可视化技术:别再把科研成果画成彩虹条了
一张图,能把审稿人劝退。
真的。不是夸张。我见过一份材料科学投稿,六个变量塞进一张三维曲面,颜色从红到紫,图例密密麻麻。作者觉得信息量拉满。审稿人回了一句:我看不出哪条是误差,也看不出你想让我比较什么。完了。图没撒谎,但它也没帮上忙。
数据可视化技术这词听着像工具清单。说实话,它更像一门删东西的手艺。科研场景尤其如此。数据多,噪声大,读者耐心少。你要在几秒内让人抓住结构,还得经得起复现和质疑。
先别急着调色,科研图的第一敌人是数据密度
很多实验室的默认流程是:数据出表,打开绘图库,先选个好看配色。问题来了。好看不等于可读。
数据墨水比这个概念老掉牙了,但依然好使。每一滴墨水都该承载信息。背景网格、立体阴影、渐变填充、3D 柱子,这些玩意儿很热闹,信息密度却没上去。它们只是把噪声涂得更亮。
更隐蔽的坑是平均值的暴政。一根柱子加一根误差线,看起来干净。可如果分布是双峰的,均值附近可能根本没样本。审稿人一追问,图就露馅。我的建议很土:能画散点就别只画柱状,能画分布就别只画均值。小样本更该如此。抖动散点、箱线图、小提琴图、半小提琴,选一个能暴露结构的。别怕图丑。丑一点,真一点。
还有坐标轴。对数轴不是装饰。跨几个数量级的数据,线性轴会把小值压成一条线。你以为是趋势,其实是压缩伪影。反过来,对数轴也可能夸大微小差异。轴标签、刻度、变换说明,老老实实写清楚。别让读者猜。
 科研论文多变量数据可视化图表设计与误差线示例
我最近帮人看一张单细胞测序的 UMAP 图。颜色用了彩虹色。红绿蓝紫一锅炖。色盲读者直接沉默。更麻烦的是,彩虹色没有感知上的顺序,读者会把颜色当类别,尽管它表达的是连续表达量。连续变量优先用感知均匀的色图,比如 viridis 一类。类别变量再用离散色。别拿色图当壁纸。
这里插一句吐槽。有些期刊对图的要求细到字体磅值,却对色盲友好只字不提。你说气不气。作者只能自救。检查一下灰度打印,检查一下红绿色盲模拟。五分钟的事。
那些漂亮的交互,背后是GPU和感知心理学在打架
科研数据可视化技术这几年明显往浏览器和交互走。很正常。论文附件里的静态图,读者只能看一个视角。交互式探索能缩放、筛选、联动,发现静态图里看不到的簇和异常。
但交互不是免费午餐。十万个点,浏览器里一卡,探索欲就没了。于是工程上开始堆:WebGL、WebGPU、层次细节、降采样、空间索引、按需加载。渲染管线一复杂,图是好看了,可解释性风险也来了。
举个真实场景。你在交互图里反复筛选子群,找到一组显著差异。然后截图放进论文。交互式探索带来的多重比较问题,常常被截图抹掉了。读者以为你一开始就预设了这个比较。其实你点了二十次。这不一定是造假,但必须交代。探索性分析和验证性分析,别混着写。
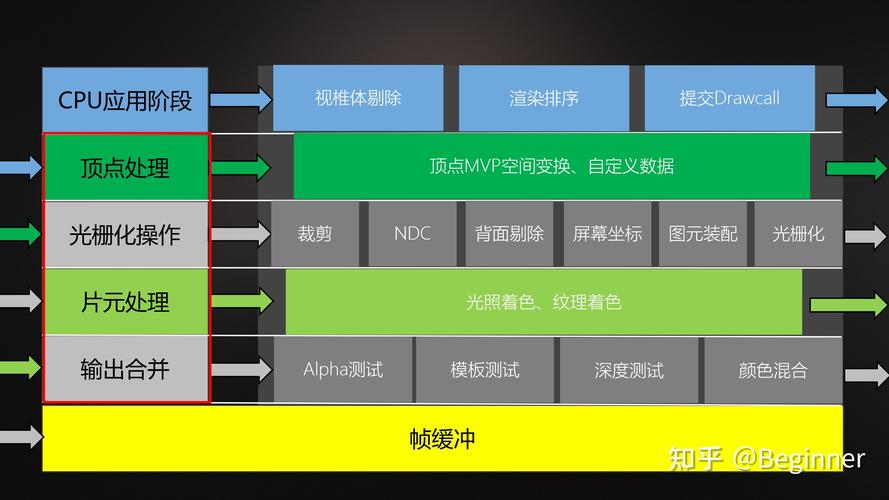 GPU加速科学数据可视化渲染管线与交互式探索示意图
感知心理学也在背后使劲。人眼对位置和长度的判断,通常比面积和角度更准。所以条形图比饼图靠谱,点线图比三维饼图靠谱。不是审美问题,是解码成本问题。你让读者用面积估比例,还要在 3D 透视里估,读错是常态。
颜色也一样。色相多了,人记不住。超过七八个类别,图例开始打架。怎么办?小倍数。拆成一组小图,共享坐标轴,让读者比较模式。别把所有类别塞进一张图。小倍数不酷,但它是科研里的老实人。
还有动画。时间序列动画很抓眼球。可读者没法暂停比较。我的偏见:动画适合展示过程,不适合承载关键证据。关键证据还是静态小倍数加交互附件。两套一起上,别偷懒。
AI画图很爽?科研可视化里它先得学会不撒谎
现在到处都在说自然语言生成图表。你打一句话,它给你一张图。演示很惊艳。到了科研场景,问题立刻变尖锐:它有没有偷偷聚合?有没有选错轴?有没有把缺失值当零?
我不反对用 AI 辅助。查语法、改主题、生成初版布局,挺省事。但科研图表的责任链不能外包。数据怎么来,变换怎么做,统计怎么算,必须可追溯。AI 可以当草图助手,不能当最终解释者。尤其别把生成式模型编出来的趋势线当证据。那不是可视化,那是插画。
行业里一个更务实的方向是声明式可视化。Vega-Lite、Observable 这类工具,把图表规格写成代码。好处很直接:可版本控制、可复现、可审查。参数化之后,换数据重跑,图跟着更新。比手工拖拽稳。ParaView、napari、ChimeraX 这些科学可视化工具也在往脚本化和可复现走。科研团队真该把图当成代码资产,不是桌面上的临时截图。
说到复现,我得啰嗦一句。图的可复现性,至少包括数据、代码、环境三个层面。只存一张 PNG,等于只存了结论的影子。半年后你自己都说不清那根线怎么来的。用 notebook 也好,用脚本也好,把随机种子、包版本、过滤条件写下来。费事。但救命。
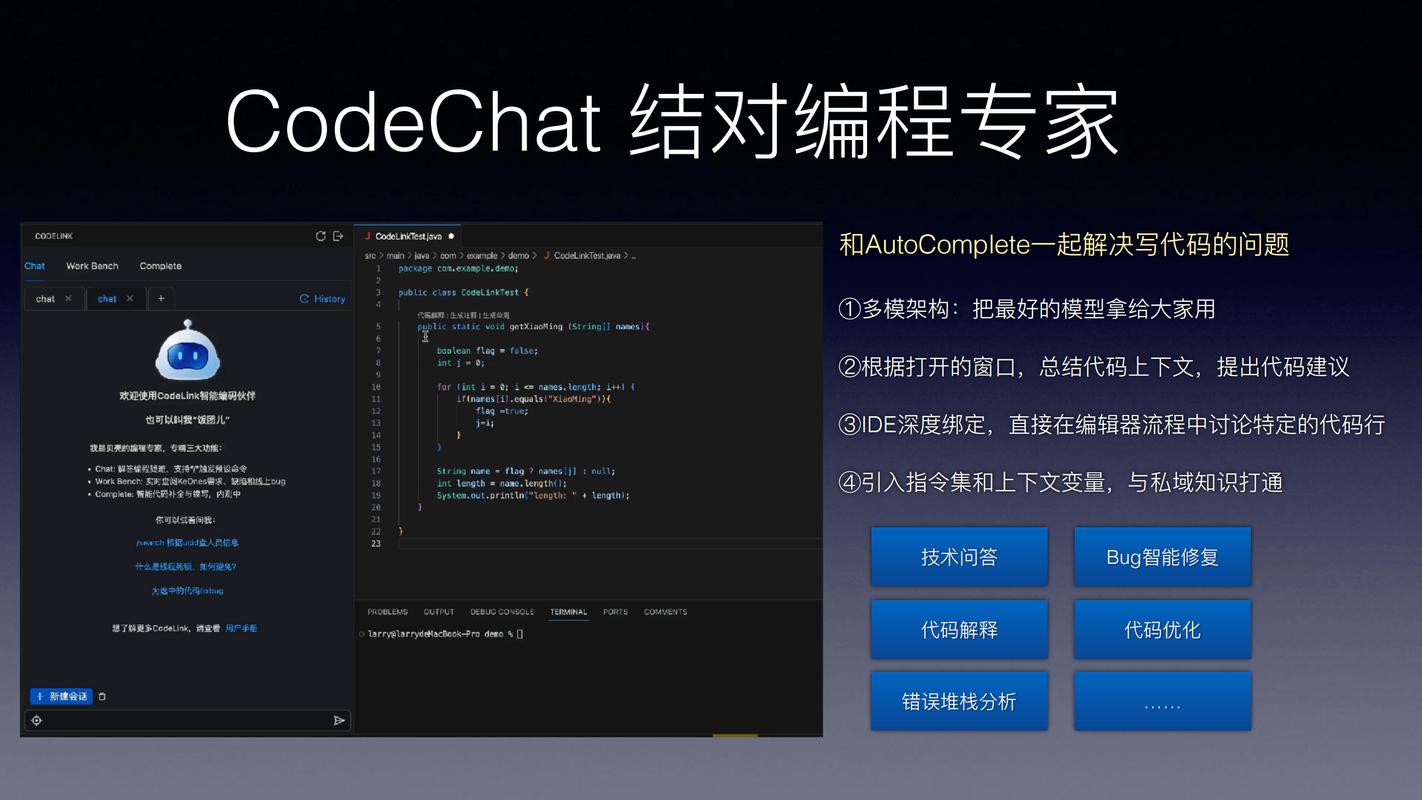 科研数据可复现可视化工作流代码与版本控制截图
给实验室的落地清单:少一点炫技,多一点证据
 给实验室的落地清单:少一点炫技,多一点证据
如果你明天就要改组里的图,我会先做这几件事。不复杂。
第一,把所有彩虹色图翻出来,换成感知均匀色图,做一次灰度检查。第二,给每张图写一句读者应该看到什么,写不出来就删图。第三,误差线旁边标注样本量和误差类型,别让读者猜是标准差还是标准误。第四,交互图附上探索路径和筛选条件,别只给截图。第五,图表代码进版本库,配一个能跑通的环境说明。
听起来像后勤工作。对。数据可视化技术走到最后,拼的不是谁会调渐变色,而是谁能让证据站得住。图不是装饰。图是论证的一部分。你可以让它好看,但先让它诚实。真的,先诚实。