当调用链开始说谎:云原生可观测性的证据链与工程边界
九月二十三号,南京。一场内部评审会开到夜里,投影上是三条曲线:延迟、错误率、饱和度。争论却不在曲线本身——有人问,为什么告警说订单服务慢了,日志里却找不到一次失败请求?
这个问题很典型。云原生可观测性常被描述成指标、日志、追踪的集合,仿佛把三样数据接进平台,系统就透明了。实际不是。可观测性是从外部信号推断内部状态的能力,信号之间必须能互相校验,否则只是三座数据孤岛。
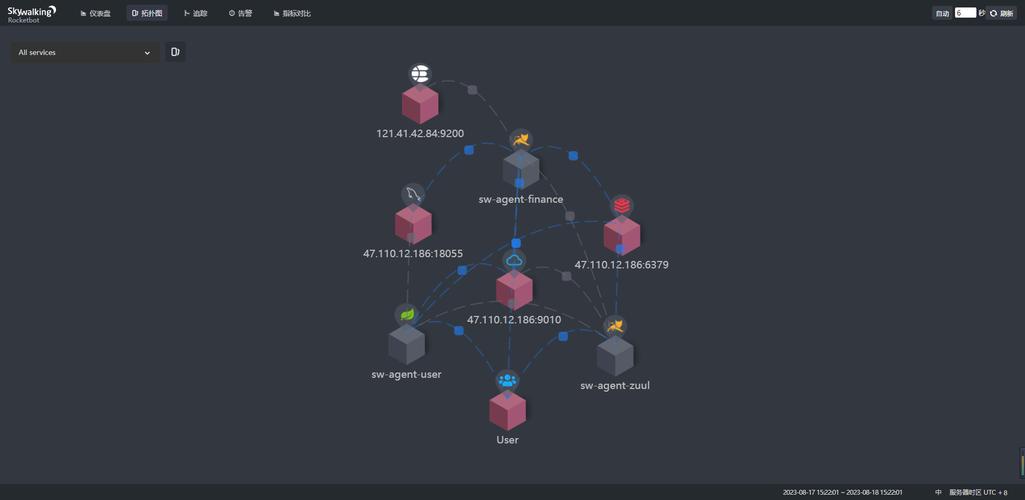 云原生微服务调用链追踪拓扑与告警关联界面
告警不是证据:三支柱之间的时间与因果
 告警不是证据:三支柱之间的时间与因果
指标能说明“有异常”,追踪能说明“异常经过哪些服务”,日志能说明“当时发生了什么”。三者时间基准不一致,因果链就会断。容器节点时钟漂移几十毫秒,跨服务调用链的父子关系就可能错位;异步消息队列把请求拆成生产、存储、消费三段,trace 上下文如果没有跨线程传递,调用链会在队列边缘断掉。此时告警仍然会响,但它指向的已经不是一个可复现的故障现场。
云原生环境放大了这个麻烦。Pod 短生命周期,IP 频繁变化,服务实例在声明式编排下漂移。传统以主机为中心的采集假设——固定节点、稳定标签、可登录排查——逐步失效。可观测性平台需要把 resource attributes、trace_id、span_id、时间戳与 exemplars 放在同一条证据链上,而不是让指标、日志、追踪各自维护一套身份体系。
这里有个容易忽略的限制:关联本身也有成本。给每条日志注入完整资源标签,会让存储和索引膨胀;给每个指标挂 exemplar,需要采集端支持直方图或摘要类型;跨信号 join 在查询时做,延迟会很高。更现实的做法是在采集端完成轻量归一化,在存储端保留可回溯的原始上下文,在查询端按需展开。条件是:语义约定必须稳定。OpenTelemetry 的语义约定解决了命名一致性问题,但它不能替团队决定什么算“服务”、什么算“实例”。
关键不是采集更多信号,而是让信号可关联。一个反例是:某团队把所有日志都打上十几个业务标签,短期查询很爽,长期基数失控,日志平台开始丢索引,排障时反而只能靠 grep。信号丰富不等于证据充分。
采集端的预算约束:基数、采样与数据税
可观测性有很强的“数据税”属性。指标按时间序列计费,日志按摄入量计费,追踪按 span 数计费。云原生系统的动态标签——Pod 名、容器 ID、请求 ID、用户 ID——一旦进入指标维度,时间序列数量会指数级上升。高基数不是原罪,但没有预算的高基数就是事故。工程上常见的约束是:指标只保留可聚合、可告警的低基数维度;高基数信息放进日志或追踪;追踪采用头部采样控制入口流量,再在收集端做尾采样,保留错误与慢请求。
尾采样听起来合理,但它需要缓冲。收集端要等一整条 trace 结束后才能判断是否保留,决策延迟和内存占用随之上升。在突发流量下,缓冲队列溢出会导致采样偏差:被保留下来的样本可能集中在少数实例或少数时间段。于是看板上的 P99 很漂亮,真实长尾却被采丢了。解决路径不是简单调大缓冲,而是把采样策略与 SLO 绑定:错误码、超时、关键业务路径优先保留,普通成功请求按比例降采样,同时记录采样率元数据,让后续统计能还原近似分布。
eBPF 提供了另一条路径:在内核侧采集网络与系统调用事件,减少应用侵入。它对短生命周期容器友好,也能补上语言 SDK 覆盖不到的盲区。但边界同样明显——加密流量、内核版本差异、安全策略限制、容器权限收紧,都会让采集器失效或降级。把它当成“无侵入全知”是误判;更合理的定位是与 SDK 信号互补,并在部署前验证内核兼容性与开销。
 Kubernetes容器指标日志与链路数据聚合架构图
存储侧的分层也值得说。热存储保留近期高精度数据,温存储做降采样与聚合,冷存储归档原始日志和慢追踪。这里的关键条件是查询模式:如果团队习惯用日志做全量检索,冷归档的恢复成本会抵消成本收益。数据治理要先于工具选型,否则只是把账单从一处挪到另一处。
边界与风险:可观测性不是全知视角
 边界与风险:可观测性不是全知视角
可观测性不能替代测试、形式化验证和故障注入。它能告诉你系统在观测点上的行为,不能证明没有未观测到的故障。一个典型反例是:所有指标正常,日志无错误,追踪成功率很高,但业务侧仍然出现库存超卖。原因是观测点只覆盖了 API 层,领域状态的一致性约束没有被表达为信号。此时再加看板没用,需要把业务不变量变成可验证的断言,或者用对账任务暴露差异。
隐私与合规是另一条硬边界。请求参数、用户标识、错误堆栈里的敏感信息,一旦进入日志和追踪,就会被复制到多个存储层。脱敏要在采集端做,且要保留可关联的哈希或令牌,否则排障时又会退回到人工拼凑。AI 辅助异常检测也面临可解释性问题:模型给出“异常分数”,运维仍需要回到原始信号找证据。没有证据链的智能告警,容易变成新的告警疲劳源。
供应商锁定同样需要提前设计。采集端尽量遵循开放标准和可移植的语义约定,存储端保留原始数据的导出能力,查询层避免把关键逻辑写死在专有 DSL 里。商业产品在关联分析和长期存储上有优势,但退出成本要在合同和技术架构里同时评估。
回到南京那场评审会。会后大家同意先做一件事:把告警、追踪、日志的时间戳与资源属性对齐,再谈智能分析。这个顺序不炫,但能减少“调用链说谎”的概率。云原生可观测性的工程边界,往往不在采集器多少,而在证据链是否闭合、预算是否可持续、边界是否被诚实标注。