算力不是堆出来的:高效能计算平台的边界与代价
九月的南京,机房走廊里一股热风。电表比跑分更诚实。
一个平台标称每秒多少浮点运算,听着漂亮;可当作业排队、内存带宽打满、互连链路拥塞时,屏幕上那串峰值数字帮不上忙。高效能计算平台真正要回答的,不是“还能堆多少卡”,而是单位功耗与单位时间能交付多少可用的应用吞吐。这句话不新鲜,却常被采购清单盖过去。
峰值数字会撒谎
Roofline模型给过一个朴素提醒:算力上限由峰值浮点与内存带宽共同夹住。计算强度低的核函数,先撞内存墙。你把GPU换成更新一代,带宽不跟,收益就薄。反过来,一个强串行、频繁同步的作业,Amdahl定律摆在那里,加节点只会让等待更整齐。
互连网络常被低估。胖树、无阻塞、收敛比、链路误码率,这些词不性感,却决定集合通信的尾延迟。一个大规模MPI作业,最慢的那条路径往往不是算得慢,是等得久。
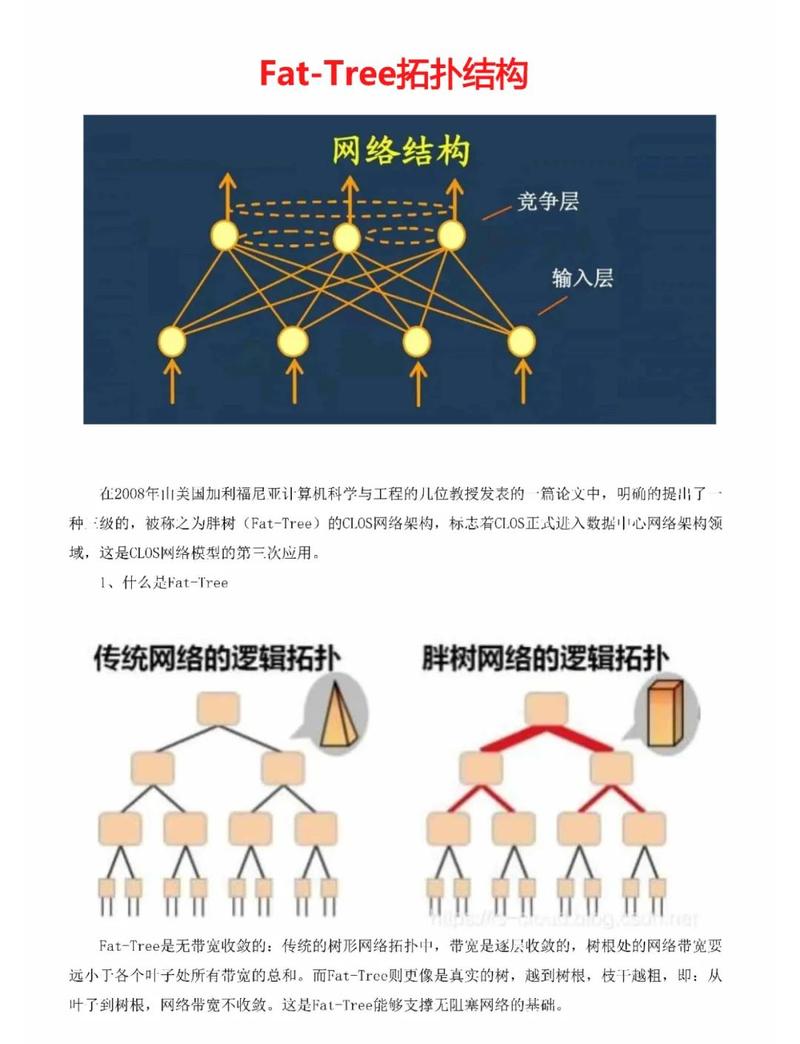 高效能计算平台胖树互连网络拓扑示意图
说实话,很多集群的瓶颈不在算,在等。等I/O,等调度,等一个不均衡的分区。作业画像没做清楚,峰值利用率就像天气预报——参考可以,别当真。
把电变成有效吞吐
能耗墙不是新闻。PUE低不代表应用能效高;机房省了电,作业多跑两倍时间,账还是亏。液冷把散热路径缩短,冷板贴着发热器件走,适合高密度机柜。可它不是万能钥匙:改造成本、运维规范、漏液风险、配电与承重,哪一项都要算。
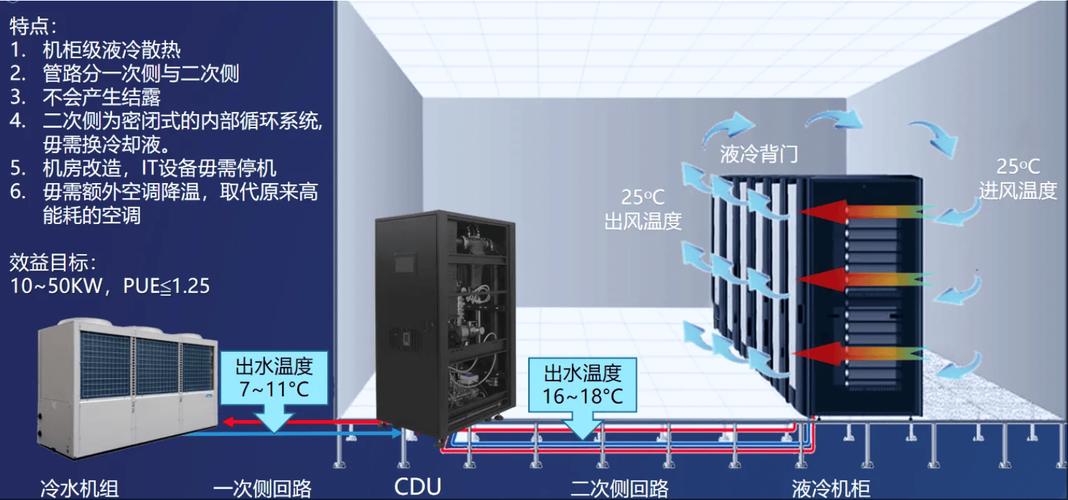 高效能计算平台冷板液冷机柜热流分布示意图
调度层面更微妙。作业粒度太碎,调度开销吃掉吞吐;粒度太粗,回填和预留又难做。配额、优先级、抢占、checkpoint周期,都是 trade-off。存储侧同样:并行文件系统的元数据服务、条带策略、客户端缓存,任何一处抖动都会把计算节点变成等待队列。
这笔账不轻。能效指标如果只盯PUE,容易把问题从机房赶到应用层。更实用的做法是同时看应用级能耗、作业完成时间和排队时长——三个数一起看,才知道电到底变成了什么。
异构之后,软件栈才是硬骨头
CPU加GPU加专用加速器,硬件拼图越来越花。软件栈的债也越滚越大。MPI、OpenMP、CUDA、HIP、SYCL,每多一层抽象,性能可移植性就多一道裂缝。移植成本吃掉硬件收益的例子不少:一个库调用在A卡上快,在B卡上要重写内核,项目周期直接翻倍。
CXL内存池、NUMA亲和、页迁移策略,这些机制能缓解内存墙,也会引入新的抖动。观测能力跟不上,调优就靠猜。性能计数器、trace、作业级画像,应该像电表一样常开。
大规模系统的容错开销也不能回避。节点数上去,故障间隔下来。checkpoint写得太频繁,I/O成瓶颈;写得太稀疏,失败重算成本高。异步checkpoint、多级存储、冗余策略,得按作业特征配,不能一套模板打天下。
什么场景不该上平台
 什么场景不该上平台
边界比能力更值得说。小规模、低并行、强事务低延迟的业务,硬塞进批处理平台,收益可能为负。数据合规、供应商锁定、迁移成本,也都是硬约束。云上弹性HPC适合峰值突发和短周期试验;长期稳定的大规模作业,自建或混合更可控。反例不罕见:为了“上平台”而上平台,最后利用率低、运维复杂、账单难看。
趋势可以看:Chiplet、光互连、CXL、云原生调度、性能标准化。它们会改变边界,但不会取消边界。先把作业画像和电费账本摊开,再谈平台。别急着加卡。