技术风险识别别做成填表:从失效链到证据链的工程化路线
评审会上,项目负责人打开风险登记册,逐条念:供应链中断、算法偏差、接口不兼容、验证不充分。条目整齐,颜色分明。问题在于,这些词离工程决策太远。风险登记册能记录担忧,却很难回答一个更硬的问题:哪条技术路径会在什么条件下失效,失效如何被观测,证据够不够支撑下一笔投入。这不够。
技术风险识别的核心不是列风险,而是建立可追溯的失效链证据。这句话落到项目上很具体:场景拆到任务,任务拆到功能,功能拆到接口与约束,接口与约束再对应失效模式和验证证据。缺一层,识别就会退化成专家拍脑袋。
在南京软件谷和江北新区做产学研对接时,常见一种错位:高校团队把技术风险识别写成文献综述,企业团队把它写成周报里的红黄绿灯。两边都没错,但都难直接支撑评审。评审要的是可核查假设:指标在什么工况下成立,样本量多少,失效阈值怎么定,证据由谁复核。
风险不是名词,是失效链上的位置
很多风险条目之所以空泛,是因为它们只写了名词。供应链风险、算法风险、集成风险,这些词没有位置。位置意味着:在哪个任务环节出现,经过哪条耦合路径放大,最终表现为哪类性能下降或安全事件。
以软件密集型装备为例,接口不兼容只是表象。往下追,可能是时钟同步假设不一致,可能是异常恢复策略冲突,也可能是测试环境与现场工况的分布差异。三种成因对应的识别方法和证据完全不同。前者要查协议与时钟模型,中者要做故障注入和状态机分析,后者要补现场数据与分布偏移评估。
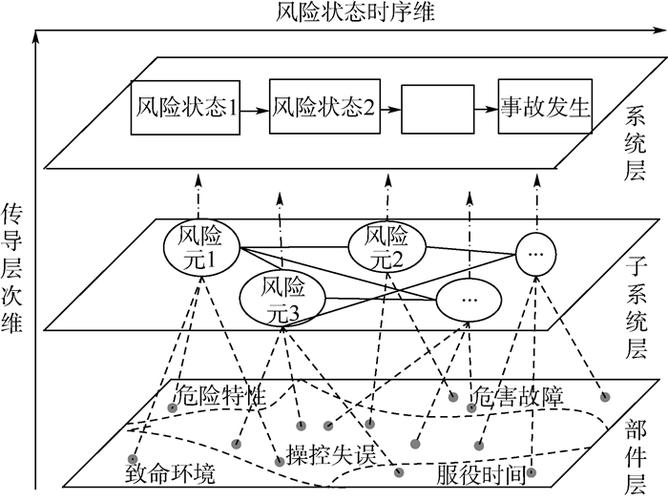 复杂装备研制技术风险识别失效链示意图
所以识别技术风险时,我更愿意先画失效链,再填风险登记册。失效链不追求漂亮,追求可追问:这条边凭什么成立,证据是什么,反例有没有被排除。没有失效链的风险条目,只是会议纪要里的形容词。
识别对象要分层:技术不确定性、集成耦合与验证缺口
技术风险识别常被混成一锅。至少可以分三层看。底层是技术不确定性:原理是否成立,材料与工艺是否稳定,算法在目标分布上是否可泛化。中层是集成耦合:单点都行,合起来不行,接口、时序、资源竞争、故障传播都算。上层是验证缺口:指标有没有测,测了但工况不全,样本量不够,模型可信度不足。
这三层不能用同一套方法打天下。原理不确定,适合做机理分析、原理样机、关键参数扫描;集成耦合,适合STPA、接口FMEA、故障树与场景推演;验证缺口,适合试验设计、数字孪生校核、灰度验证和故障注入。把三层混在一起,评审就会陷入“所有风险都重要,所有资源都不够”的僵局。
还要警惕一个反例:FMEA按RPN排序,容易把高严重度、低概率的失效压到后面。RPN是乘积,概率低会稀释严重度。对安全相关系统,严重度应有否决权,不能只看排序分数。类似地,贝叶斯网络需要先验,数据稀缺时专家先验可能循环论证;德尔菲能收敛意见,但不产生新证据。方法各有条件,离开条件谈方法,等于把工具当结论。
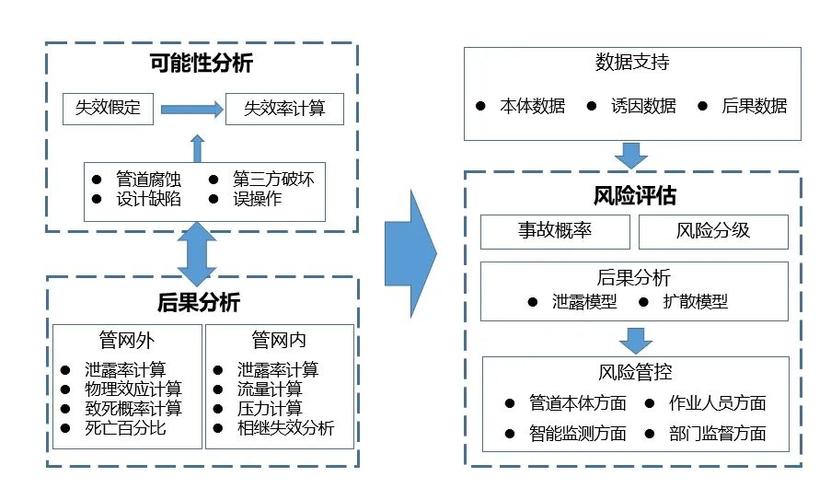 软件密集型系统技术风险识别评审场景图
方法的价值在于留下证据,不是留下签名
评审表上不缺签名。缺的是证据链。技术风险识别要回答四件事:失效模式是什么,触发条件是什么,观测指标是什么,证据强度够不够。四件事对应四个动作:拆解、建模、测量、复核。
拆解不是把WBS抄一遍。拆到能判定失效的粒度才有用。比如“通信中断”太粗,“在强电磁干扰下,心跳包丢失超过三个周期后,主备切换超时”才可判定。建模也不是画一张漂亮的控制回路图,而是要标出控制动作、反馈延迟、传感器盲区和操作员干预点。测量要给出工况覆盖和样本量。复核要留下独立复现路径,最好有反例测试。
证据链的底线要求,是让第三方能沿着同一路径复现判断。做不到这一点,风险识别就会变成专家权威的延伸。专家当然重要,尤其在数据稀缺的早期阶段。但专家判断也要被结构化:假设是什么,置信度来自哪里,哪些证据会推翻它。否则,专家越多,会议越长,结论反而越模糊。
在产学研合作里,这一点尤其关键。高校擅长机理与模型,企业掌握工况与故障库,两边不把证据接口对齐,就会出现“论文里显著、现场里不可用”的落差。较可行的做法是共建风险证据模板:每条风险附失效链、关键假设、验证方案、数据来源和复核人。模板不解决所有问题,但能把讨论从立场拉回证据。
验证与边界:识别有成本,也有盲区
技术风险识别不是越全越好。识别有成本,验证更贵。把所有不确定性都列为高风险,资源会被分散,真正需要前置验证的环节反而得不到投入。较现实的策略是按决策影响分层:影响安全、合规、关键性能或不可逆投入的,前置验证;影响有限、可通过迭代吸收的,进入观察清单。
边界也要说清楚。复杂系统存在涌现行为,早期识别不可能穷尽。供应链的二级、三级环节,软件与物理过程的耦合,操作员在异常工况下的行为,都可能在后期才暴露。因此技术风险识别应是持续过程,嵌入门径评审、变更管理和试验复盘,而不是一次性表格。
另一个盲区是“识别即解决”的错觉。识别只是把不确定性变成可讨论的假设,不保证假设被消除。验证失败也不是坏事,它可能提前暴露路径错误。真正危险的是证据不足却继续加码,或者用形式化评审掩盖技术分歧。识别质量不取决于条目数量,而取决于关键假设是否被证伪过。
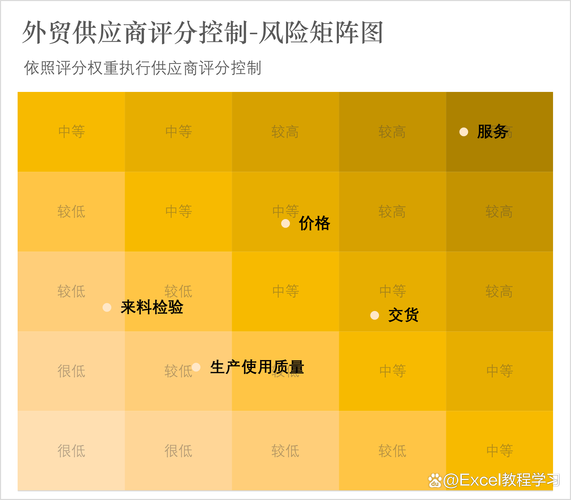 供应链技术风险识别穿透分析图
趋势判断:模型驱动与AI辅助,但解释权不能交出去
近年的变化很明显。模型驱动工程让失效链可以部分形式化,数字孪生让验证前移,知识图谱开始用于故障库和供应链穿透。AI辅助也在进入风险识别:从专利、事故报告、缺陷库中抽取失效模式,做相似案例检索,生成初始风险假设。这些工具能提高覆盖率,但有明确条件。
如果AI生成的风险条目不能回到失效链和试验证据,它只是更漂亮的清单。模型可解释性不足,专家先验不透明,数据分布偏移,都会让识别结果看似丰富、实则不可复核。较稳妥的用法是让AI做线索发现和一致性检查,把判断与验证留在工程闭环里。解释权、复核权不能被交出去。
回到评审桌,判断一条技术风险识别是否有效,可以问三个问题:它能不能指出失效位置,能不能给出可观测证据,能不能被反例推翻。三个问题都答不上来,条目再多也只是安慰。答得上来,哪怕只有几条,也足以改变项目决策。