科研成果:多模态AI的狂飙与隐忧
直接上干货。上周OpenAI发布了GPT-4o,号称全能多模态——能看、能听、能说,几乎没延迟。说实话,我第一反应不是惊喜,是后背发凉。你想想,一个AI能跟你实时视频对话,分析你的表情、语气,甚至你背后的环境。这玩意儿到底算工具,还是算啥?
 GPT-4o多模态交互演示界面
不过话又说回来,牛皮吹得震天响,落地还是看疗效。我找了几家已经接入GPT-4o的API的公司聊了聊,做教育的那家很兴奋,说实时口语陪练终于不用尴尬停顿了;搞医疗的却直摇头,说分析X光片时,模型对罕见病症的误判率还是高得吓人。你看,技术突破跟实际应用之间,永远隔着一个“但是”。
 机器学习顶会论文中注意力机制示意图
 三、普通人的奶酪,要被动了?
聊点接地气的。这些科研成果,跟我们月薪三千的人有什么关系?关系大了。前天我刷到一个新闻,某大厂客服中心裁了70%的人,换上了多模态AI系统。这系统不仅能听懂你骂人,还能从你的语气和用词判断你的愤怒指数,然后自动切换安抚策略。效果怎么样?据说客户满意度还上升了。听到这个,我内心挺复杂的。一方面,作为消费者,我讨厌跟智障客服纠缠;另一方面,作为打工人,我后背又开始发凉。这还只是客服。以后呢?老师、律师、设计师、医生……但凡需要“理解”和“反馈”的岗位,谁说得准?
不过,我倒不觉得会马上出现失业潮。历史经验看,技术消灭旧岗位的同时,总会冒出些新需求。就像汽车淘汰了马车夫,但养活了加油站、汽修厂和滴滴司机。关键是,你能不能快速切换到新赛道。我有个朋友,之前做插画师,AI绘画火了以后,他没抱怨,转头学起了提示词工程,现在专门给公司训练多模态模型,收入翻倍。你看,机会这东西,它不穿工装,你得自己认出来。
 四、狂飙之下,别忘了刹车
最后说点不太中听的。当前的多模态AI研究,太重视“能力”而轻视“品格”。模型能生成逼真的视频了,那造谣是不是更容易了?能合成任何人的声音,诈骗电话怎么防?最近欧洲那边已经开始严查AI生成内容,要求必须加不可见水印,但道高一尺魔高一丈,总有办法破解。科研人员不能光埋头搞突破,得抬头看看伦理后果。否则,我们造出来的不是帮手,是凶器。
还是那句话:技术没有善恶,但搞技术的人有。写到这里,突然想到图灵奖得主Yoshua Bengio最近在一场访谈里哽咽了,说AI发展的风险被严重低估,他后悔没早点投身安全研究。一个一辈子搞AI的大牛说出这种话,分量有多重,不用我多说了吧。
科研成果这四个字,不只是论文和专利。它是一把钥匙,能打开天堂也能打开地狱。就看开锁的人怎么想了。
好了,不啰嗦了。这周我还会继续跟踪这个领域,有新的想法再跟大家聊。对了,如果你对文中提到的那些论文感兴趣,可以去找找原文读读——比看我的二手分析强。
一、多模态这潭水,到底有多深?
多模态不是新概念。几年前就有模型能把图片转文字,或者根据文字生成图片。但那时候的“多模态”,说白了就是拼凑。先用一个模型识别图像,再丢给另一个语言模型处理,中间信息折损严重,反应慢半拍。现在不一样了。原生多模态模型,比如GPT-4o,它从一开始就在同一个神经网络里处理文本、图像、音频,甚至能交叉理解——听到狗叫能立马想到狗的样子,看到菜单能直接念出菜名,语调还能带上服务员的热情。这种丝滑,这种“通感”,真有点科幻照进现实的味道。GPT-4o多模态交互演示界面
不过话又说回来,牛皮吹得震天响,落地还是看疗效。我找了几家已经接入GPT-4o的API的公司聊了聊,做教育的那家很兴奋,说实时口语陪练终于不用尴尬停顿了;搞医疗的却直摇头,说分析X光片时,模型对罕见病症的误判率还是高得吓人。你看,技术突破跟实际应用之间,永远隔着一个“但是”。
二、那些藏在顶会论文里的“小秘密”
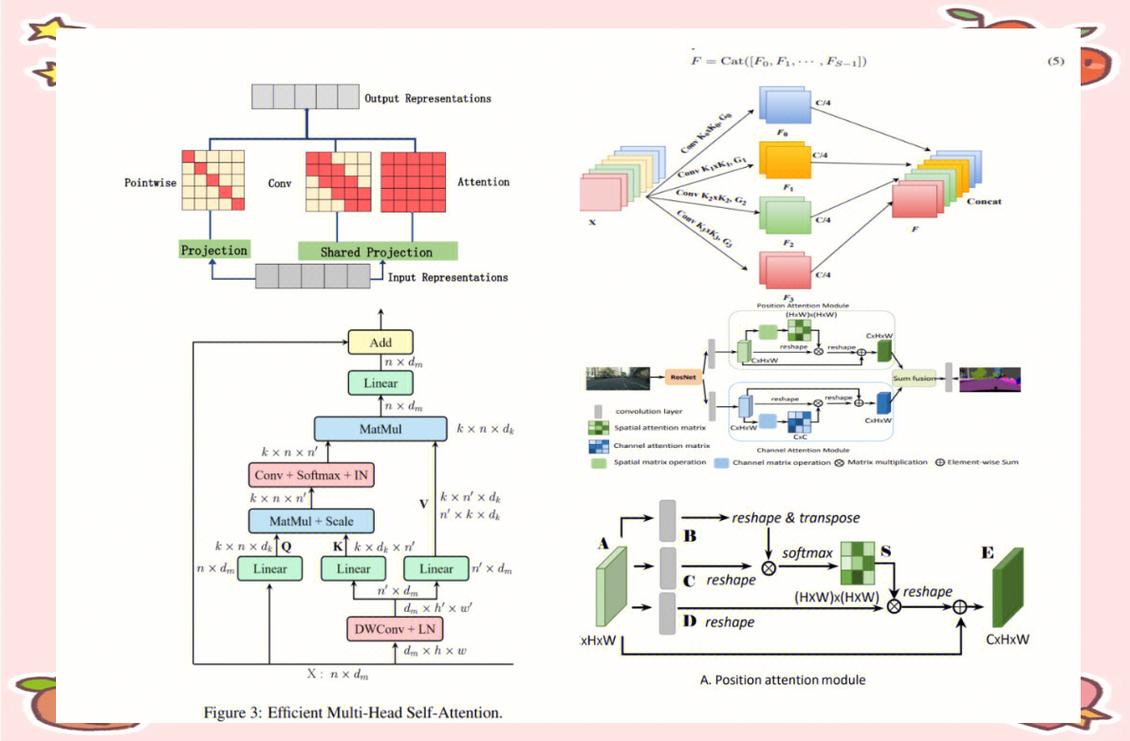
这几天我扒了不少顶会论文——CVPR、ICML、NeurIPS——发现个有意思的现象。很多团队不再拼参数规模了,开始死磕效率和可解释性。比如Google DeepMind最新的一篇工作,用极小的模型实现了超强的视频理解,秘诀在于他们把人类注意力的机制融进去了——模型学会“看一眼就知道重点在哪儿”。这简直是对之前“暴力美学”的啪啪打脸。以前搞AI的都觉得,数据越多、模型越大,效果就越好,结果现在发现,你扔进去几百TB数据,不如教会模型“偷懒”。 还有个MIT的组,搞了个“反省式多模态”,让模型在输出答案前,自己先在内部质疑一遍——这个东西看着像杯子,但它有没有可能是笔筒?这个过程像极了人类纠结时候的样子。测试下来,这种自带怀疑精神的模型,在复杂推理任务上准确率提升了将近20%。我觉得这才是正道。AI不能只会鹦鹉学舌,得学会自己踩刹车。 可惜啊,这些好玩的成果,多半还躺在论文里。工业界更热衷的,还是怎么让模型多卖钱。OpenAI刚发布的那个实时API,计费精细到按分钟算,企业抢着接入,生怕错过风口。有时候我挺矛盾的:科研的初衷是探索未知,但现在越来越像给商业巨头铺路。机器学习顶会论文中注意力机制示意图
三、普通人的奶酪,要被动了?
三、普通人的奶酪,要被动了?
聊点接地气的。这些科研成果,跟我们月薪三千的人有什么关系?关系大了。前天我刷到一个新闻,某大厂客服中心裁了70%的人,换上了多模态AI系统。这系统不仅能听懂你骂人,还能从你的语气和用词判断你的愤怒指数,然后自动切换安抚策略。效果怎么样?据说客户满意度还上升了。听到这个,我内心挺复杂的。一方面,作为消费者,我讨厌跟智障客服纠缠;另一方面,作为打工人,我后背又开始发凉。这还只是客服。以后呢?老师、律师、设计师、医生……但凡需要“理解”和“反馈”的岗位,谁说得准?
不过,我倒不觉得会马上出现失业潮。历史经验看,技术消灭旧岗位的同时,总会冒出些新需求。就像汽车淘汰了马车夫,但养活了加油站、汽修厂和滴滴司机。关键是,你能不能快速切换到新赛道。我有个朋友,之前做插画师,AI绘画火了以后,他没抱怨,转头学起了提示词工程,现在专门给公司训练多模态模型,收入翻倍。你看,机会这东西,它不穿工装,你得自己认出来。
四、狂飙之下,别忘了刹车
四、狂飙之下,别忘了刹车
最后说点不太中听的。当前的多模态AI研究,太重视“能力”而轻视“品格”。模型能生成逼真的视频了,那造谣是不是更容易了?能合成任何人的声音,诈骗电话怎么防?最近欧洲那边已经开始严查AI生成内容,要求必须加不可见水印,但道高一尺魔高一丈,总有办法破解。科研人员不能光埋头搞突破,得抬头看看伦理后果。否则,我们造出来的不是帮手,是凶器。
还是那句话:技术没有善恶,但搞技术的人有。写到这里,突然想到图灵奖得主Yoshua Bengio最近在一场访谈里哽咽了,说AI发展的风险被严重低估,他后悔没早点投身安全研究。一个一辈子搞AI的大牛说出这种话,分量有多重,不用我多说了吧。
科研成果这四个字,不只是论文和专利。它是一把钥匙,能打开天堂也能打开地狱。就看开锁的人怎么想了。
好了,不啰嗦了。这周我还会继续跟踪这个领域,有新的想法再跟大家聊。对了,如果你对文中提到的那些论文感兴趣,可以去找找原文读读——比看我的二手分析强。