科研伦理建设:合规表格之外的科学判断
一次伦理审查会上,委员翻完三十页材料,问了一个问题:如果受试者中途撤回同意,已采集样本还能不能用于衍生研究?申请人愣住。材料里有知情同意书,却没有撤回后的处理路径。会议室安静了几秒。这个场景不戏剧,却把科研伦理建设的难点摊开了:审查表填得漂亮,风险未必被看见。
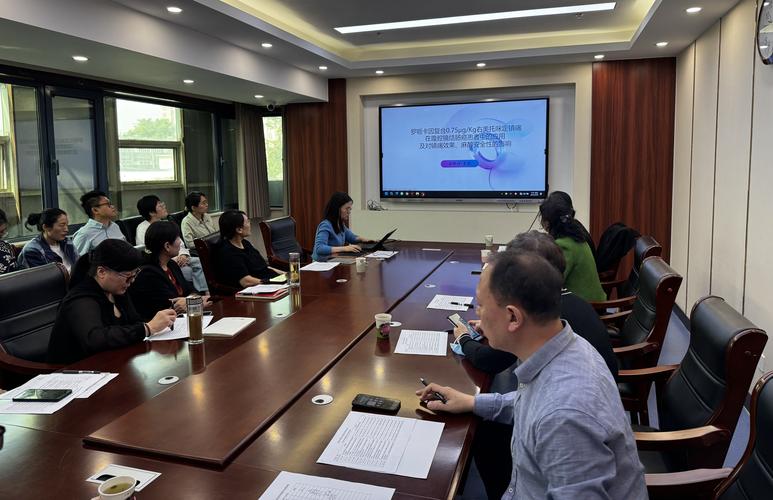 高校科研伦理审查委员会会议桌面材料
风险识别依赖申请人自述,委员会时间有限,专业匹配不足,利益冲突管理不透明,形式化审查就出现了。反例很常见:大数据研究用公开社交媒体数据训练模型,申请书写“不涉及个人隐私”,但文本里包含可定位到个人的罕见病描述;AI辅助诊断研究只审查医院端数据,忽略企业端模型训练日志。这类遗漏不是道德败坏,而是审查能力与研究对象错位。
伦理审查不是行政盖章,而是对不确定性的公开辩护。它要回答的不是“文件全不全”,而是“如果伤害发生,谁承担、如何发现、怎样止损”。委员会需要方法学专家、临床医生、法律与数据治理人员,也需要非专业视角。利益冲突声明不能只收表,还要有回避规则和记录。否则,审查意见很容易变成礼貌的套话。
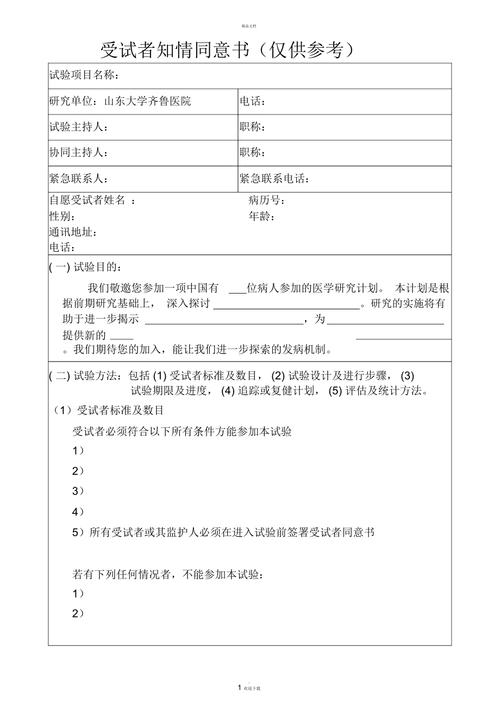 实验室科研数据记录本与受试者知情同意书
更麻烦的是二次利用。样本采集时同意的是某项研究,后来要用于商业转化或跨机构模型训练,原同意范围够不够?动态同意、分层同意、受控开放数据,都是路径,但都有成本。数据最小化、访问控制、审计日志、模型记忆检测,需要写进研究方案,而不是等论文投稿前补一张声明。公开数据也有隐私预期。有人以为“网上能搜到”就等于“可以随便用”,这混淆了可获取性与伦理许可。
应用边界要讲清楚:差分隐私不是万能盾,联邦学习也不自动保护隐私,梯度泄露和成员推断仍可能发生。趋势正在变化——受控访问、数据使用协议、模型审计、撤稿与更正机制,都在把伦理从附件拉回研究流程。速度不快。可方向是对的。
 医学研究论文撤稿通知与伦理审查流程图
验证不能只看材料数量。抽样复核、案例复盘、审查意见可追溯,比“零投诉”更有意义。过度审查会抑制探索,比例原则不能丢:风险越高,审查越严;风险低、数据弱标识,可用简易审查。可简易不等于免审。边界一旦模糊,申请人就会学会“写材料”,而不是“想风险”。
 把伦理写进实验设计的那一行
归根到底,伦理不是实验做完后补的附件。它应写进实验设计的那一行:样本量、对照、停止规则、数据保存期限、撤回同意后的处理、利益冲突声明。产学研协作中,企业掌握数据和工程能力,高校掌握方法和临床资源,医院掌握受试者信任。三方合作时,伦理责任不能按合同拆分。
科学判断需要证据。伦理判断也需要。问题不在纸面!
材料齐全,不等于风险被看见
伦理审查的技术核心是风险—收益评估、知情同意和脆弱群体保护。它需要申请人描述研究设计、数据流向、潜在伤害和降险措施,再由委员会独立判断。问题在于,很多机构的审查被材料驱动:签字齐不齐、模板对不对、培训学时够不够。这些当然要有。可它们只是合规底线。高校科研伦理审查委员会会议桌面材料
风险识别依赖申请人自述,委员会时间有限,专业匹配不足,利益冲突管理不透明,形式化审查就出现了。反例很常见:大数据研究用公开社交媒体数据训练模型,申请书写“不涉及个人隐私”,但文本里包含可定位到个人的罕见病描述;AI辅助诊断研究只审查医院端数据,忽略企业端模型训练日志。这类遗漏不是道德败坏,而是审查能力与研究对象错位。
伦理审查不是行政盖章,而是对不确定性的公开辩护。它要回答的不是“文件全不全”,而是“如果伤害发生,谁承担、如何发现、怎样止损”。委员会需要方法学专家、临床医生、法律与数据治理人员,也需要非专业视角。利益冲突声明不能只收表,还要有回避规则和记录。否则,审查意见很容易变成礼貌的套话。
匿名化不是免责条款
数据治理是科研伦理建设的硬骨头。匿名化、去标识化、差分隐私,各有条件。去标识化数据可通过邮编、日期、罕见诊断组合重识别;差分隐私用噪声换保护,ε预算越大,效用越高,隐私保护越弱。研究者常把“脱敏”当免责条款,这在方法上站不住。实验室科研数据记录本与受试者知情同意书
更麻烦的是二次利用。样本采集时同意的是某项研究,后来要用于商业转化或跨机构模型训练,原同意范围够不够?动态同意、分层同意、受控开放数据,都是路径,但都有成本。数据最小化、访问控制、审计日志、模型记忆检测,需要写进研究方案,而不是等论文投稿前补一张声明。公开数据也有隐私预期。有人以为“网上能搜到”就等于“可以随便用”,这混淆了可获取性与伦理许可。
应用边界要讲清楚:差分隐私不是万能盾,联邦学习也不自动保护隐私,梯度泄露和成员推断仍可能发生。趋势正在变化——受控访问、数据使用协议、模型审计、撤稿与更正机制,都在把伦理从附件拉回研究流程。速度不快。可方向是对的。
让制度在过程里生效
科研伦理建设不能只靠培训学分。实现路径包括委员会独立性、审查能力、持续审查、事件报告、科研诚信与伦理联动、举报保护。条件也要说清:小机构资源不足,可区域协作审查,但责任不能外包;企业参与临床研究,数据和安全事件报告不能按合同拆分。医学研究论文撤稿通知与伦理审查流程图
验证不能只看材料数量。抽样复核、案例复盘、审查意见可追溯,比“零投诉”更有意义。过度审查会抑制探索,比例原则不能丢:风险越高,审查越严;风险低、数据弱标识,可用简易审查。可简易不等于免审。边界一旦模糊,申请人就会学会“写材料”,而不是“想风险”。
把伦理写进实验设计的那一行
把伦理写进实验设计的那一行
归根到底,伦理不是实验做完后补的附件。它应写进实验设计的那一行:样本量、对照、停止规则、数据保存期限、撤回同意后的处理、利益冲突声明。产学研协作中,企业掌握数据和工程能力,高校掌握方法和临床资源,医院掌握受试者信任。三方合作时,伦理责任不能按合同拆分。
科学判断需要证据。伦理判断也需要。问题不在纸面!