量子计算研究:比特“失忆”前的那几微秒,才是工程师的战场
凌晨两点四十,稀释制冷机旁边的显示器又跳了一下。0.1毫开尔文。说实话,我当时困得眼皮打架,可这一下还是把我拽起来了——量子比特的相干时间曲线刚有点起色,温度一抖,全白干。
真冷。
那台机器里塞着几十根微波线、一堆衰减器和滤波器,像给一个怕吵的婴儿搭的隔音房。我们做量子计算研究,很多时候不是在算题,是在哄它别“失忆”。
外界聊量子计算研究,喜欢从“比特数”开刀。多少比特、什么路线、又破了什么纪录。可你要真在实验室蹲过,会发现另一组数字更扎心:T1、T2、门保真度、读取错误率。翻译成人话,就是它能保持量子态多久,操作一次有多容易出错,读出来准不准。
算得快?先活下来再说。
别急着数比特,先看看它能不能活过几微秒
量子比特不是一个小球。超导路线里,它通常是一个约瑟夫森结加电容构成的非线性谐振电路。别被“电路”俩字骗了,它工作在微波频段,能量尺度小得可怜,环境里一点热噪声、一点电磁泄漏,甚至宇宙射线,都可能把它从量子态里踢出去。
叠加和纠缠听起来玄,其实在工程上非常具体:你要让一个量子态在几微秒到几百微秒内保持相位一致。对吧,几微秒。你眨个眼都过去了。
所以量子计算研究的一个核心矛盾是:门操作要快,快才能少受噪声影响;可脉冲一快,控制精度又容易掉。调脉冲形状、调耦合强度、调读取腔参数,最后常常变成焊板子和拧接头的体力活。有次为了一个0.3dB的衰减器折腾两天,结果发现是接头没拧紧……哈,说出来都丢人。
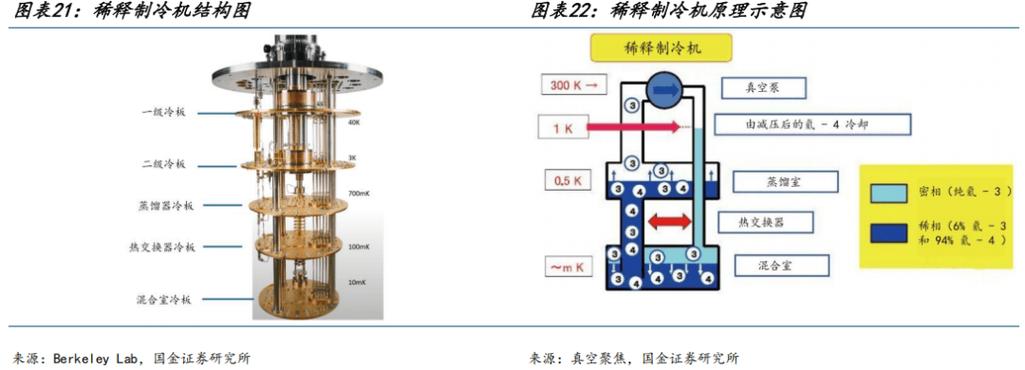 超导量子比特稀释制冷机内部微波布线图
不过话说回来,这就是一线。你会在意那0.1毫开尔文,不是矫情,是因为退相干不跟你讲道理。
纠错码:用一群“结巴”投票,把一句话说清楚
单个物理比特太脆,怎么办?量子纠错。它不是给比特打补丁,而是把信息分散到很多物理比特上,编成一个逻辑比特。表面码是现在常被讨论的一类方案,物理比特排成网格,通过近邻测量提取错误 syndrome。别怕这个词,你就把它想成“体检指标”:不直接看病人,只看指标有没有异常。
类比一下。一个人说话结巴,你可能听不清;一群结巴同时说同一句话,再让投票器去猜,反而能还原。代价呢?人得多,投票规则得严。表面码里,一个逻辑比特可能要用上千个物理比特,具体数字看错误率和码距。很贵。
阈值定理给了工程界一个盼头:只要物理错误率低于某个门槛,增加码距就能指数级压低逻辑错误。但门槛以下每一步都贵得肉疼。我师兄有句糙话:这就像用一百个漏水的桶接雨,还得保证总漏水量比一滴少。
 量子纠错表面码物理比特与逻辑比特连接示意图
所以量子计算研究里,纠错不是“后期再优化”的模块。它从布线和微波隔离开始,就决定了你后面能不能走远。
“量子优势”在实验室里,经常是一堆校准曲线
媒体喜欢说量子计算研究要“碾压经典计算机”。我理解这种传播冲动,但实验室里的画风朴素得多。随机线路采样、玻色采样这类实验,确实能在特定任务上展示量子设备的演化能力,可它们离通用计算还有距离。你看到的是一条漂亮的概率分布,背后是几百次校准、无数次重复。
我们更关心能用来干什么。材料模拟、量子化学、某些优化问题,这些是长期看点。比如模拟一个分子的电子结构,经典方法在体系变大时会撞墙,量子设备原则上能更自然地表示。但现在的噪声会让结果漂,VQE 之类的变分方法调参调到头秃。冷思考一句:把量子计算研究等同于“破解密码”是传播上的偷懒,它更像一场对复杂量子系统控制能力的长期拉练。
Shor 算法很漂亮,可它需要大规模容错量子计算机。百万级物理比特、纠错开销、低温布线、经典控制电子学,全是硬骨头。别急着把 RSA 挂嘴边。
它不是万能加速器,也别指望明天就替你打游戏
 它不是万能加速器,也别指望明天就替你打游戏
常见误解一:量子计算能同时试遍所有路径。听着像并行,其实一次演化后测量只给你一个结果。量子算法的加速来自干涉,把错误路径抵消掉,不是无限开分身。误解二:量子计算会取代经典计算机。想多了。它更像一种专用协处理器,很多任务还是经典机器干得利索。
边界也很现实。稀释制冷机的冷量有限,布线密度上去了,热负载和噪声就上来;经典控制电子学要跟着 scaling;软件栈和编译优化还年轻。我们调一个双比特门,可能要在示波器前坐一下午。情绪?当然有。有时候真想把机柜踹了。可第二天还是得回来,把线重新插一遍。
量子计算研究不是一条平滑上升的曲线。它更像在暴风雨里搭积木,一边搭一边扶。那0.1毫开尔文的抖动很小,小到外人觉得不值一提。可对我们来说,它决定了几微秒后,那个量子态还在不在。