抗风险技术设计:别再拿‘多备份’当万能解药
上周和苏南一家装备制造企业的数字化负责人喝茶,对方把保温杯往桌上一墩,语气里全是懊恼。去年刚砸了两百万搭的容灾备份系统,今年遇到产线近30%的振动传感器出现批量零点漂移,整个系统直接卡成PPT——告警通道堵死,数据同步中断,连手动切备用节点的入口都找不到。
这不是个例。
很多人对相关设计的认知,还停留在"多买几台服务器、多存几份数据"的层面,真遇到非孤立的链式故障,所有之前花的钱全打了水漂。
被误读的“冗余”:不是堆硬件就能扛住风险
行业里最常见的设计误区,是把冗余等同于资源堆叠。好像只要备的硬件够多,不管出什么问题都能兜住。
但真正的容错设计核心,从来不是资源数量,是故障域隔离——把不同风险的发生路径切割开,不让一个节点的故障顺着网络、数据、权限链路传导成系统性崩溃。
之前接触过的一家头部电商,早年做跨城双活数据中心的时候,为了省光缆租赁成本,两个中心共用同一条主干光缆线路。结果去年夏天市政施工队挖断了光缆,两个中心同时断网,整个平台瘫了4个小时。这种所谓的双活,本质上就是假冗余——两个节点共享同一个外部风险源,真出问题的时候,根本没有独立的故障隔离边界。
 分布式系统故障域隔离边界划分示意图
很多设计的隐含前提是"故障是孤立的"。但真实生产环境里的风险,从来不是单点出现的。传感器的微小零点漂移,本来是个换个零件就能解决的小问题;但如果数据清洗层的规则是硬编码的,把漂移数据当成正常流量喂给调度模块,调度模块就会给出完全偏离实际的排产指令,最后传导到执行端,就是整条产线停转。这种链式传导的风险,靠多备份根本挡不住——因为备份系统用的是同一套规则、同一套数据逻辑,主系统错的时候,备份系统会跟着一起错。
从“被动兜底”到“主动预判”:设计逻辑的根本转向
现在越来越多的团队开始跳出"等故障发生再切流量"的被动思路,把设计的触发点往前移。
核心的实现路径,是在系统全链路埋入风险熵值的实时监测点。和传统靠固定阈值告警的逻辑不同,风险熵值算的是每个节点的运行状态,偏离同环境下正常基线的程度——不看绝对数值,看相对波动。
之前和一家做动力电池的企业交流,他们之前的电池管理系统,设计的告警逻辑是电芯温度超过60度才触发降温。去年夏天有个批次的电芯,温度一直在55度上下浮动,比正常40度的基线高了15度,但因为没到60度的告警线,系统一直没动作,最后发生了热失控。后来改的设计,就是把每个电芯的电压、温度、内阻的实时波动值,和同批次电芯的平均波动范围做对比,只要熵值超过平均范围的3倍,哪怕绝对数值远低于传统告警阈值,就立刻触发预控——比如给对应电芯做局部降温,下调所在电池簇的输出功率,根本等故障攒到爆发的程度。
 工业控制系统全链路风险熵值监测节点部署图
当然,这种主动预判的设计不是万能的。它有非常明确的应用边界。
比如在航天飞控系统里,因为系统的容错要求是零误判,靠动态熵值的监测逻辑很容易出现误报——一旦误报触发了姿态调整,反而会直接威胁飞行安全。这种场景下,还是得用传统的三模冗余、硬逻辑校验的设计思路,毕竟航天系统要求的故障概率是10^-9量级,和工业场景10^-3的容错容忍度,根本不在一个评价维度上。硬把工业场景的动态监测逻辑套到高可靠要求的场景里,本身就是风险。对吧,不同场景的容错要求根本没有通用的设计公式。
容易被忽略的隐性成本:别让设计本身变成风险源
我见过太多项目,从立项开始就盯着"能扛多大的故障"这个硬指标,从来不算算为了实现这个指标,要搭进去多少额外的成本,要引入多少新的不确定性。
某股份制银行的核心交易系统,之前为了应对发薪日的交易洪峰,在流量入口加了七层校验逻辑。结果去年发薪日,流量比平时高了30%,本来是完全在设计范围内的正常峰值,结果七层校验里的一个节点,缓存超时设置错了,整个校验链路卡了20秒,用户转账的时候一直转圈,最后引发了上千起投诉。
这里面的核心问题,是设计的时候没算复杂度的边际收益。每加一个抗风险的模块,带来的风险抵御能力的提升,是不是抵得上这个模块本身可能引入的故障概率。刚才说的银行系统,前面三层校验其实已经能挡住99.9%的异常流量了,后面四层的边际收益不到0.1%,但系统整体的复杂度提升了三倍,故障概率翻了两番。
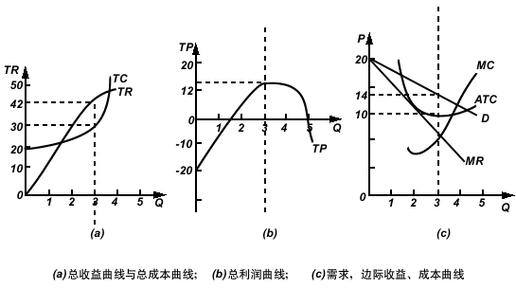 系统复杂度与抗风险能力边际收益曲线
还有个更离谱的例子。某产业园的消防联动系统,设计的时候加了自动断电逻辑——只要烟感报警,就自动切断整个机房的供电。结果去年消防测试的时候,一个靠近食堂的烟感因为油烟误报,系统直接把机房的电断了,当时值班的运维工程师根本不知道有这个自动联动的开关,连紧急手动override的按钮都找不到,整个机房停了两个小时。
这就是典型的"为了抗风险制造风险"。设计的时候完全把人的操作习惯、认知边界排除在外,觉得系统的逻辑是完美无缺的,真出问题的时候,那些写在设计文档里的完美逻辑,反而会变成压垮系统的最后一根稻草。
没有万能的设计。
那些在实验室环境下跑通的完美容错模型,一旦落到真实的生产场景里,往往会被施工队挖断的光缆、产线上积了灰的传感器、运维人员凌晨三点的误操作、供应商偷偷换了型号的电容这些完全不在设计文档里的变量打个措手不及。
好的抗风险设计,从来不是追求系统永远不出问题。是当问题真的发生的时候,不会演变成让所有人都兜不住的系统性崩溃。