从材料晶格到流体湍流:科学计算应用的落地边界与技术陷阱
上周跟南大理学院的博后在汉口路的咖啡店聊天,他吐槽花了三个月搭的第一性原理模型,结果跟实验值差了17%,查了三天才发现是周期性边界的截断半径设错了。
真的。这种坑,踩过一次就记一辈子。
被算力叙事遮蔽的核心矛盾
 被算力叙事遮蔽的核心矛盾
现在很多地方谈科学计算,开口就是多少张GPU,多少P的算力,好像堆的卡越多,出的结果就越准。根本不是这么回事。物理模型的保真度,才是决定计算结果可信度的核心——算力只是帮你把模型算得更快,但是如果模型本身就是错的,算得越快,错得越离谱。比如做高分子材料拉伸模拟的团队,要是把分子链的缠结效应简化成理想弹簧模型,哪怕你调动上千个核心跑满一周,最后得到的拉伸模量跟实验值的偏差也能超过30%。
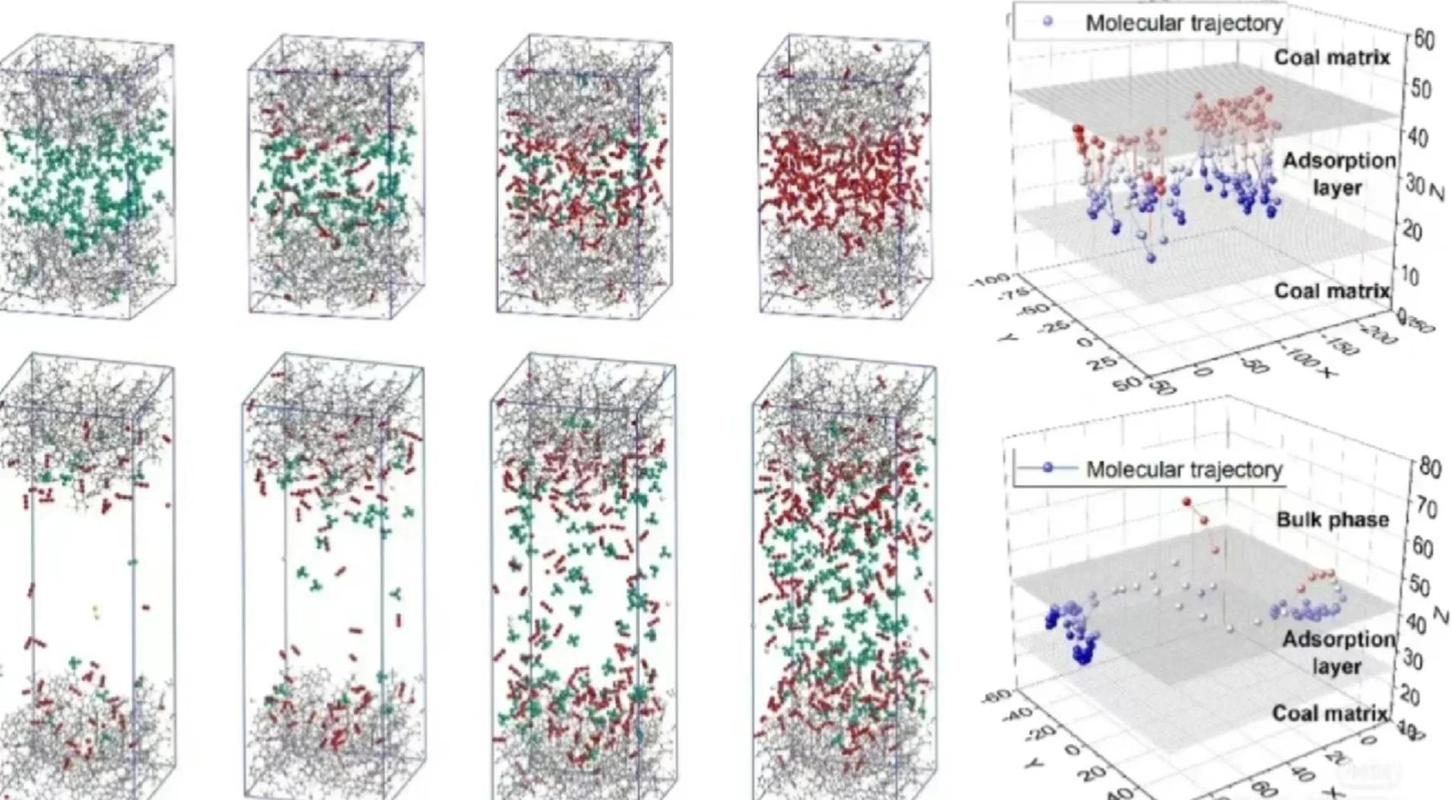 高分子链缠结分子动力学模拟轨迹图
我之前还碰到过一个读博二年级的学生,做大气边界层的数值模拟,网格精度已经比商业软件高了一个量级,但是因为没把城市建筑的粗糙元做分形处理,最后算出来的近地面风速比实测值高了2m/s,根本没法给城郊的风电场选址提供参考。说真的,这种踩坑的成本真的太高了。一个博士读三年,可能有一年半的时间都在给这些参数错误、模型简化过度的问题擦屁股。算力不是万能的。参数错了,全白搭。
跨尺度耦合里的隐形误差
现在的工程问题,早就不是单一尺度能覆盖的了。比如做锂电池的循环寿命预测,你得从原子级的SEI膜生长过程,到介观尺度的电极孔隙里的电解液浸润,再到宏观尺度的电池包热管理,三个尺度的控制方程存在着好几个数量级的时间、空间尺度差,根本没法塞进同一个求解器里直接算。
现在行业里常用的解决路径是分层耦合:把每个尺度的计算结果通过预设的接口传递给下一层的模型,听起来逻辑很顺,但这里藏着一个所有人都绕不开的问题——误差传递的非线性特征。原子级模拟得到的SEI膜离子电导率,传到介观模型的时候,如果接口的松弛时间参数设得不对,最后宏观层面预测的容量衰减速率,可能会比真实值快400个循环。
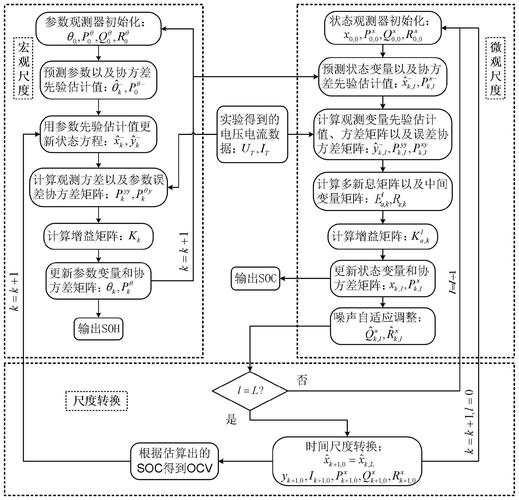 锂电池多尺度耦合计算流程示意图
之前接触过一家新能源车企的仿真团队,为了赶新车型的冬季测试节点,直接把原子级模拟得到的材料参数套到了宏观热管理模型里,连最基本的参数校准环节都省了。结果实车在-10℃的环境下做加热测试的时候,实际的电池升温时间比仿真预测的多了整整6分钟,差点耽误了整个车型的上市节奏。谁没为了赶deadline偷过懒呢?只是这种偷懒的代价,往往要到测试阶段才会暴露,到时候再返工,成本就是之前的好几倍。
不能被神化的应用边界
 不能被神化的应用边界
很多宣传材料里把科学计算吹成了能解决所有工程问题的万能工具,好像只要把方程写进代码,就能得到跟真实世界完全一致的结果。实际上,它的能力边界比大家想象的窄得多。
比如做生物大分子的构象模拟,哪怕现在用最先进的分子动力学算法,算一个常规的球蛋白折叠过程也要花好几个月。但如果碰到本征无序蛋白——就是那种没有固定三维结构、构象随环境动态变化的蛋白,现有模型根本没法准确预测它的构象变化,因为这类蛋白不存在传统意义上的能量最低点,所有的构象都是动态平衡的。这种情况下,你堆再多的算力,也得不到有实际参考价值的结果。
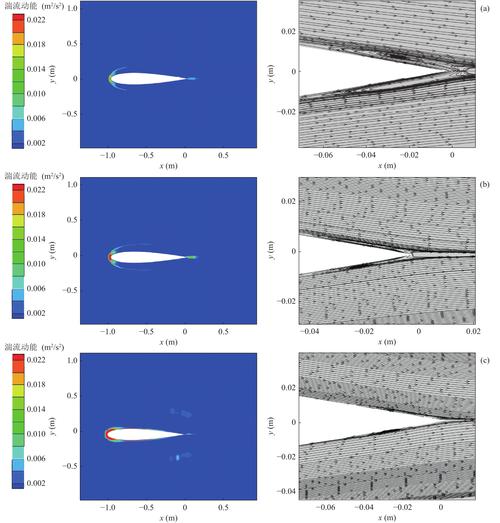 航空机翼湍流边界层数值模拟云图
上次去紫金山实验室看他们的流体计算平台,值班的工程师吐槽说,很多用户上来就要求“最高精度”,根本不说自己的实际需求是什么。比如算一个民航机翼的升阻比,网格精度到1mm就足够得到可信的结果,非要用0.1mm的超细网格,算一次要花整整3天,结果因为选的转捩模型跟实际流动状态不匹配,结果还不如人家用1mm网格配对模型的准。
更值得警惕的是,现在很多行业已经开始把科学计算的结果当成不容置疑的“金标准”。比如做化工生产的安全评估,如果计算模型里没有考虑催化剂失活速率的随机波动,最后算出来的可燃气体爆炸极限就会偏窄,真到生产环节,是要出安全事故的。那些没有经过实验校准的计算结果,哪怕背后站着规模最大的算力集群,本质上也只是在计算机的虚拟空间里重复了一遍研究者预先写进代码里的假设,跟真实世界的物理过程没有必然的因果联系。
前几天跟那个南大理学院的博后又去喝咖啡,他说把截断半径的参数改对之后,模型输出的结果跟实验值的偏差已经不到2%,那种爽感,比熬了一周夜跑出来的漂亮云图还让人开心。
科学计算从来不是什么飘在云端的高科技噱头。它跟在实验室里做滴定、搭风洞、测材料强度的工作本质上没区别——都需要盯着每一个参数,核对每一条边界,慢慢把模型跟真实世界对齐。没有捷径的。