别被AI吹的神乎其神,聊聊医学影像分割现在真能打几分
上周帮导师审一篇投MICCAI的稿子,审稿意见里一半的退稿理由都踩在同一个坑上——医学影像分割的模型在公开数据集刷得飞起,拉到临床真实场景里连狗都嫌。
真的。
我见过太多做算法的人,对着BraTS、LUNA16这些公开数据集调一两个月参数,Dice系数干到0.95往上,就敢拍胸脯说自己的模型能落地辅助临床。结果真把模型接到医院的PACS系统上,碰到带金属输液港伪影的CT、呼吸运动糊成一片的胸片、扫描时患者动了的模糊断层,直接输出一堆乱七八糟的色块。
那些被吹上天的"99%准确率",到底坑在哪?
我之前带的研二小孩,花了三个月搭了个改进版的Swin UNETR,在公开腹部肿瘤数据集上测,Dice系数冲到0.94,那段时间天天在实验室哼歌,觉得毕业已经稳了。欢天喜地拉去跟放射科的老师对接,人家扔过来20份从临床日常存档里抽的真实腹部CT,他跑了一遍模型,结果出来全科室笑了十分钟——模型把肠道里的粪石、肾盏里的小结石、甚至腹膜后正常的脂肪间隙,全当成恶性肿瘤给圈了出来。
你说这是模型垃圾吗?也不全是。问题出在他从一开始就没见过真实临床的影像长什么样。公开数据集里的影像,全是标准化扫描的:层厚统一1mm,没有伪影,对比度拉到最适合分割的程度,甚至连患者的年龄、基础病都是经过筛选的。可临床里的影像哪有这么完美?基层医院用的十几年前的老CT机,扫出来的片子噪声大的像蒙了一层纱;老年患者身上带的起搏器、骨科手术留下的钢板,扫出来全是放射状的金属伪影;急诊的患者疼的躺不住,扫到一半动一下,断层直接歪掉。这些情况,模型从来没在训练集里见过,自然分不出来。
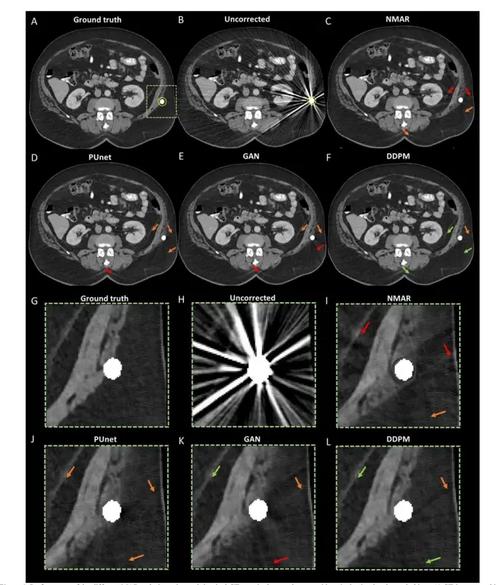 腹部CT影像金属伪影导致分割错误对比图
说实话,我见多了这种脱离临床的"高分模型"。有次听个行业报告,台上的人讲他们的肝分割模型准确率99.2%,我举手问了一句,你们测的数据集里,包含肝硬化、脂肪肝、有过肝切除手术史的患者影像吗?台上的人愣了两秒,说我们用的是公开的健康人数据集。
合着您这模型,就只能给没病的健康人分肝是吧?那要您干嘛。
这两年真正落地的技术,根本不是在拼模型大小
前几年行业里的风气特别奇怪,大家都在卷模型参数:Transformer堆的层数越来越多,注意力模块加了一层又一层,有的模型参数干到几亿,推理一张512*512的断层要半分钟。你想啊,放射科医生一天看几百份片子,每份片子几百个断层,等你模型推理完,医生都已经把报告写完了,这东西有什么落地价值?
这两年风向终于变了。真正在医院里跑起来的分割模型,没一个是靠刷榜赢的。去年我去苏州一家做医疗AI的公司交流,他们给基层医院做的肺结节分割模型,参数只有最开始版本的十分之一,推理一张薄层CT只要0.2秒。他们根本没在LUNA16数据集上跟人卷SOTA,而是专门跑了三个多月的基层医院,收了1200多份老CT机扫的真实胸片,拿这些片子给模型做微调。最后测出来的结果,医生说分割出来的结节边界,比他们刚入职的规培生手圈的还准。
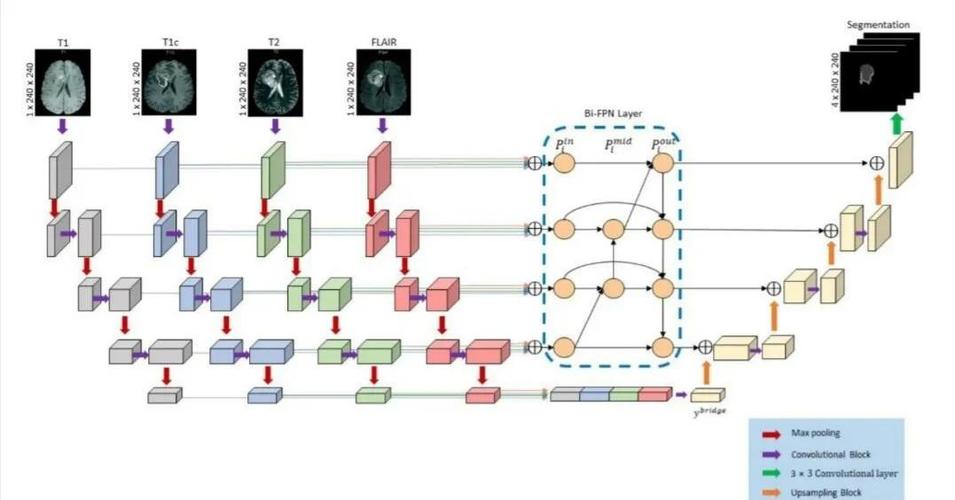 轻量型肺结节医学影像分割模型推理流程示意图
还有个更有意思的方向,是把医生的操作经验直接嵌到模型的训练逻辑里。之前有个团队做肝静脉分割,之前因为肝静脉跟周围的肝实质密度差特别小,模型经常把边界切的歪歪扭扭,Dice系数卡在0.8上不去。后来他们干脆把放射科医生手动勾画肝静脉时的操作路径——就是医生的鼠标从哪个解剖标志点开始画,沿着哪个血管走行,遇到分叉的时候怎么判断——当成额外的监督信号喂给模型,结果不到一个月,Dice系数直接涨了5个点。
你说绝不绝?之前大家拼尽全力把网络结构搭的越来越复杂,结果把人本身的临床经验加进去,效果比堆三层注意力机制还好使。
别神化,也别踩低,这东西现在真的在帮医生减负
 别神化,也别踩低,这东西现在真的在帮医生减负
去年我去浙西某县医院放射科蹲点,他们用的是一套骨折自动分割的模型。遇到外伤来的急诊患者,CT扫完之后,模型会先把所有可疑的骨折位置标出来,还会自动标注有没有累及关节面、有没有碎骨片移位。之前年轻医生看外伤CT最头疼的就是肋骨骨折——老年患者骨密度低,骨折线浅的跟头发丝似的,看久了眼睛都花,稍微走神就漏了。
我那天在科室待了一上午,碰到个70岁的老太太,摔了一跤,年轻医生对着片子看了两遍,都只看到第8肋有个轻微的骨裂,结果模型跑出来,直接把第9肋靠近脊柱的位置标了个红框。老主任凑过去放大看了半天,一拍桌子说,对,就是这里,差一点就漏了。
当然,你要是跟我说这东西能代替医生,那纯纯是扯犊子。现在很多模型的短板还是很明显:碰到有术后改变的患者,模型经常把放疗导致的组织坏死当成肿瘤分割出来;碰到有严重伪影的片子,模型的输出基本是随机的。医学影像分割从来不是个纯算法问题,它的核心是要服务于临床决策,不是服务于论文的影响因子。
最近看MICCAI 2024的投稿列表,已经有超过三成的论文在关注域适应、小样本泛化、临床真实场景的鲁棒性问题,不再是那种把公开数据集的分数往上刷0.1个点就拿出来讲的老套路了。这其实是个好事,说明做这行的人,终于从实验室的自嗨里走出来了。
前几天跟那个之前把粪石当肿瘤的研二小孩吃饭,他说现在不卷SOTA了,天天泡在放射科跟着老师看片子,知道哪些区域是真的需要分割的病灶,哪些是会干扰模型的正常组织。
挺好的。
真的,做医学影像分割这行,最怕的就是你对着电脑调一年参数,连临床医生真正需要什么都不知道。
那不是做技术。
那是闭门造车。