别等生产事故才补窟窿:混沌工程的落地逻辑与避坑指南
去年帮某电商复盘大促故障时,发现他们的容错机制全是纸面上的——所有服务挂掉的场景,从来没人真的在生产环境试过。故障发生的那天,只是订单中心的一个节点因为磁盘满了自动重启,整个系统的熔断策略就彻底失效,半小时内积压了十几万笔订单,最后靠人工对账花了整整三天才捋清楚。团队的技术负责人在复盘会上皱着眉说,之前总觉得这些极端场景离自己很远,直到真的撞上了,才发现所有的预案都是编出来安慰人的。
不是故意搞破坏,是给系统做压力体检
很多人第一次听到这套方法,第一反应是“好好的系统为什么要故意搞坏”。其实和大家定期做体检的逻辑没区别——你不能等身体出了大问题才去医院,平时就得主动测测血压、查查内脏,看看哪个零件在高压下会出问题。核心目标从来不是制造故障,而是在故障真正发生前,找到系统隐藏的脆弱点。
和普通的功能测试不一样,这类实验测的不是系统“正常运行时会不会出错”,而是“出问题的时候能不能扛住”。你写再多的单测、集成测试,都没法覆盖到所有的极端场景:机房突然断电、跨可用区的网络闪断、第三方支付接口超时30秒、某个依赖的服务突然返回乱码……这些场景你在测试环境里模拟十次,都不如在真实的生产流量里跑一次来得实在。
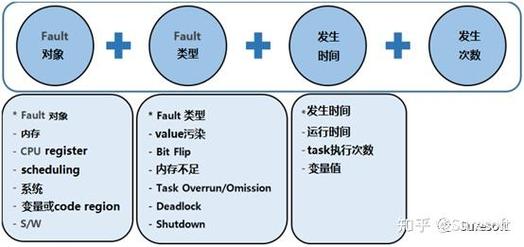 分布式系统混沌实验故障注入流程示意图
见过太多团队把这事搞成走过场。提前一周发全员通知,运维全员待命,在和生产环境隔离开的测试集群里跑一遍早就彩排好的流程,最后写一份几十页的报告上报“完成年度混沌演练”。连生产环境的边都没碰过,测出来的结果能有多少参考价值?说穿了就是怕出事,怕担责任,把一套本来要直面真实风险的方法,变成了走流程的KPI。
实验的边界,比实验本身更重要
我见过最离谱的一次“混沌实验”,是某互联网社区的技术团队刚看完几篇科普文章,就兴冲冲地在生产环境给核心数据库打了个高延迟的故障注入。他们甚至没做流量隔离,也没提前准备快速回滚的开关。结果整个用户登录功能卡了整整40分钟,APP的启动页都转不出来,客服后台的投诉单半小时堆了上千条。最后整个技术团队扣了季度绩效,CTO在全员会上做了检讨。这不是做实验。是搞破坏。
这类方法的核心前提,是你对自己的系统有足够的掌控力。所有实验的第一步,永远是先明确边界:你要测的是哪个链路?能承受的最大故障影响范围是多少?有没有一键回滚的机制?就像医生做手术之前要先划定安全范围,总不能为了查个阑尾炎,把整个腹腔都剖开。
成熟的团队做实验,都会严格控制爆炸半径。最开始的实验,只会选完全非核心的边缘节点,切1%甚至更低的真实流量过来跑,哪怕真的出问题,影响的用户也寥寥无几。等摸清楚系统的反应规律,再慢慢扩大范围,从单节点到单可用区,从边缘服务到核心链路,一步一步来。从来没人敢一上来就把整个支付链路搞挂,那不是勇敢,是莽撞。
 混沌实验爆炸半径分层控制策略示意图
什么情况绝对不能碰这类实验?系统本身还在大规模重构,连核心链路的拓扑图都没理清楚的时候,别上来就试。所有的容错机制、熔断策略还在调试阶段,你根本不知道哪个开关会触发什么连锁反应,这时候注入故障,跟闭着眼睛在马路上开车没区别。还有那种用户量极小、全年都不会出一次大规模故障的内部系统,也没必要硬上这套东西——投入的成本远大于可能的故障损失,完全是本末倒置。
别为了演练而演练,要盯着真实的故障场景
 别为了演练而演练,要盯着真实的故障场景
很多团队的实验脚本,都是从开源教程里抄来的:随机杀几个Pod,给网络加个10%的丢包率,模拟CPU跑满的状态。跑完一遍,就觉得自己把所有场景都覆盖了。但仔细想想,这些场景真的是你业务最常遇到的风险吗?
做直播业务的团队,核心风险从来不是某个边缘节点的CPU跑满,而是主播推流的链路被中断、弹幕服务因为瞬时流量雪崩、礼物支付的回调接口超时。做跨境电商的团队,核心风险是跨地域的网络波动、海外支付渠道的服务不可用、海关接口的返回格式变更。你不去测这些真正会让你业务停摆的场景,天天在那测一些一年都碰不上一次的极端情况,最后实验报告写得再漂亮,真出了事还是一样抓瞎。
更关键的是,实验完发现的问题,要真的去修。我见过太多团队,实验跑完,把发现的脆弱点记在共享文档里,标个“待优化”的标签,然后就再也没人管了。三个月之后同样的问题再引发故障,大家还会一脸惊讶:“哎?我们之前不是测过这个问题吗?”测过不修,和没测有什么区别?
现在很多团队已经开始把这类实验和可观测性系统打通,注入故障的同时自动抓取全链路的指标,不用人工挨个去排查哪个节点出了问题,效率比前几年高了好几个量级。实验的场景也从最开始的服务层面,慢慢延伸到了更极端的物理场景:模拟整个机房断电、模拟光纤被施工挖断、模拟云服务商的控制台彻底不可用。这些以前想都不敢想的场景,现在都可以在可控的范围内反复测试,直到团队能在故障发生后的几分钟内,自动完成流量切换,把影响降到最低。
说穿了,这套方法本质上不是什么高大上的技术概念,就是一种面对风险的态度。你总觉得自己的系统足够稳定,所有的预案都万无一失,直到真的故障砸到脸上,才发现自己之前的自信全是空中楼阁。与其等着事故逼着你交学费,不如主动在可控的范围内,把这些坑都提前踩一遍。