被K8s排障逼疯的运维,终于靠云原生可观测性松了口气
上周帮朋友排查K8s集群的诡异故障,整整熬了16个小时。
找不到根因。
日志飘得满世界都是,指标跳得像抽风,链路追踪翻遍了也找不到那个延迟高到离谱的调用节点——最后还是靠他们新上的云原生可观测性平台,12分钟定位到是某个sidecar镜像的DNS解析逻辑出了bug,每次解析域名都会多等2秒,攒的请求直接把整条链路的延迟拉爆。
那天从机房出来的时候天都亮了,我蹲在路边买豆浆,就想:早把可观测性的事搞明白,哪至于遭这个罪。
别再把可观测性当监控的升级版了
说真的,我见过太多团队,把装了Prometheus+Grafana就叫"有可观测性了"。扯。
传统监控是什么路数?盯着固定的服务器IP、固定的应用进程,看CPU跑了多少、内存占了多少、磁盘还剩多少空间,超过阈值就弹告警。这套方法在十年前跑单体应用的时候确实够用,毕竟服务器是固定的,应用版本是几个月才更一次的,出了问题顺着日志找总能摸到源头。
现在呢?Pod动不动就飘,弹性扩缩容的时候实例生命周期可能就几分钟,今天这个节点上跑的服务,明天可能就被调度到别的可用区去了。你还盯着固定IP看指标?看到的都是早就下线的僵尸数据,有啥用。
传统监控的核心是"盯着固定对象看状态",而云原生可观测性的核心是"从系统产生的所有数据里,逆向推导出内部运行逻辑"。说白了,监控是告诉你"现在出问题了",可观测性是告诉你"为什么出问题,问题出在哪,之前还出过啥类似的问题"。
别觉得这是文字游戏。我之前碰到过一个团队,监控告警弹出来说"订单服务CPU使用率95%",运维冲上去把服务重启了,半小时后又弹告警,再重启,循环了三次,最后才发现是下游的库存服务接口超时,把订单服务的线程全堵死了。如果有完整的可观测性数据,点一下订单服务的异常指标,就能顺着调用链直接看到下游库存服务的超时情况,哪至于来回重启耗时间。
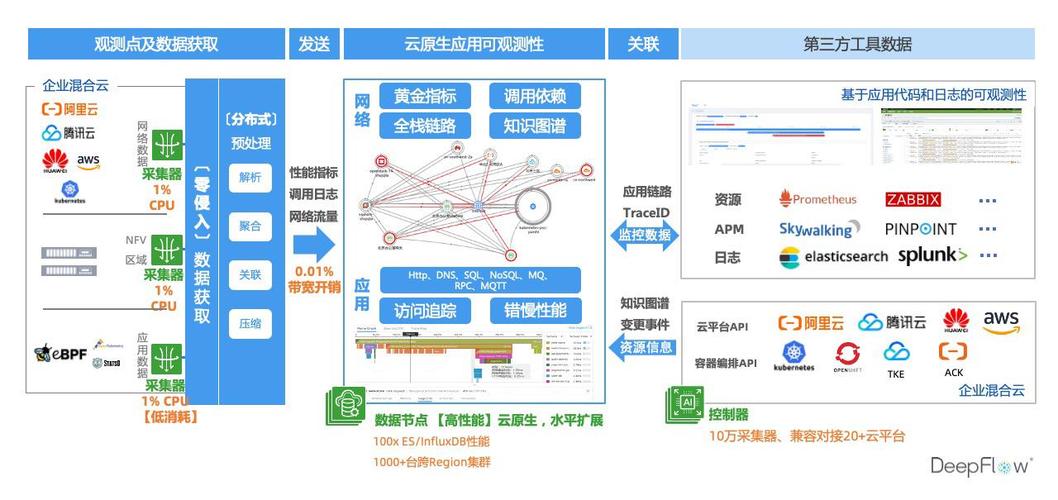 云原生可观测性三支柱数据流向对比图
CNCF2024年的调研,藏着多少人踩过的坑
前阵子翻CNCF出的最新云原生可观测性调研报告,数据挺有意思:现在有68%的团队已经把可观测性作为核心技术栈的一部分,但是其中42%的团队,遇到的最大痛点根本不是工具不够多,是数据割裂。
谁懂啊。
日志存在ELK里,指标存在Prometheus里,链路追踪存在Jaeger里,三个平台各看各的,想关联一下?要手动把trace ID从日志里抠出来,再粘到追踪平台搜,光这个操作,每次排障就要浪费半小时。赶上大促的时候流量翻十倍,日志量直接涨了几十倍,ELK的查询延迟高到半分钟都刷不出来,急的运维直拍桌子。
这两年行业里的风向其实变的很快。大家慢慢发现,与其凑好几个开源工具拼一套能看的东西,不如把三类数据——指标、日志、链路追踪——全部存在同一个存储层,靠统一的标签体系把数据串起来。你看到某个接口延迟高,点一下就能直接跳过去看对应的日志、对应的调用链,甚至能关联到最近的服务发布记录,根本不用在好几个平台之间来回切。
云原生可观测性最大的价值从来不是"看到更多数据",是"减少排障时的认知跳转成本"。之前接触过一个做生鲜电商的团队,大促的时候曾经因为排障不及时,亏了快两百万。后来他们花了三个月把可观测性栈统一,排障平均时长从原来的47分钟压到了3分钟,去年618的时候,整个集群只触发了两次告警,每次都是十几分钟就解决了,算下来省的钱够把整套平台买三遍。
最近也有不少厂商开始往可观测性平台里加大模型能力,比如你在搜索框里直接问"过去1小时哪个服务的错误率最高",大模型直接从底层数据里拉出来给你结果,甚至能列出来可能的故障原因。不过话说回来,别信那些吹的神乎其神的,说什么AI能完全自动定位根因的,我试过好几个,最后给的建议十次有八次是"建议检查网络连接"——这不是废话吗?真的,我上次碰到个平台,大半夜告警响了,我点进去看根因分析,给我推了个"系统运行异常"的结论,我盯着屏幕愣了三秒,合着我花了几万块买的平台,就给我看这个?
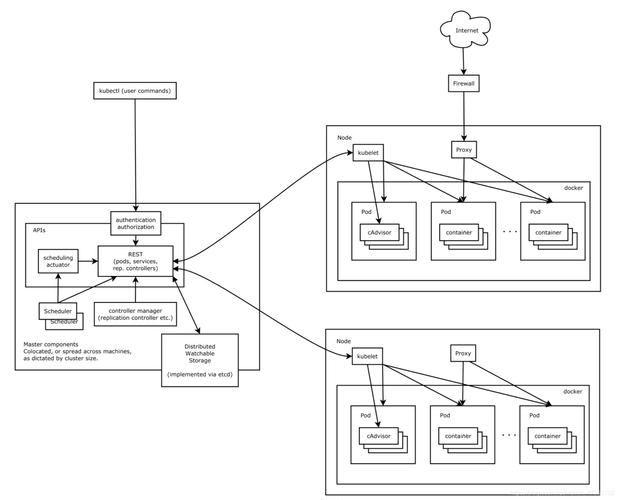 K8s集群下可观测性数据标签关联示意图
别上来就砸钱买全套方案,先想清楚你要解决什么问题
 别上来就砸钱买全套方案,先想清楚你要解决什么问题
我见过太多团队,一听说云原生可观测性重要,上来就砸几百万买全套商业方案,结果用了半年,90%的功能从来没点开过。
没必要。
如果你的团队就是几十个人,跑个几百个Pod的规模,根本不需要上什么复杂的重型方案。把OpenTelemetry接好,把三类数据的标签规范统一,别让不同业务线的人,给同一个Pod打不一样的标签,比啥都强。
说起来OTel这两年真的帮了大忙。之前大家接可观测性,要自己写一堆适配代码:接Prometheus写一套,接Jaeger写一套,接ELK又写一套,业务代码改的乱七八糟。现在OTel把这些适配层全部统一了,业务代码只要接一次SDK,就能把所有数据导到你想用的任何平台里,不管是开源的还是商业的,都能兼容。
不过太多人把OTel当普通的SDK接,接完就不管了。连服务名、环境、版本号这些基础标签都没打全,最后导出来的数据,连哪个服务在出问题都分不清,这不白搭吗?对吧?我之前碰到个团队,接完OTel跑了一个月,翻数据的时候发现所有服务的标签里,服务名全是"unknown",等于一个月的白采集,浪费了好多存储成本。
如果是大规模的场景,比如跑了上万个Pod,跨好几个可用区,有微服务、有Serverless、还有边缘节点,那确实可以考虑成熟的商业方案。但是也别被销售忽悠,什么"全场景智能分析""全链路根因定位",你得先看它能不能把你现有的三类数据打通,能不能兼容你已经在用的开源组件,别上来就让你把之前的技术栈全换了,那纯纯是给你添堵。
上周跟一个做SaaS的技术负责人聊天,他说之前他们团队天天被告警追着跑,半夜两点被告警叫起来,翻半天日志发现是个无关紧要的测试环境的Pod挂了,气的直接把告警系统删了。
后来他们花了三周时间,把可观测性的数据标签全部规范了一遍,把告警的阈值从单纯的"CPU超过80%"改成了"服务错误率超过0.1%且持续30秒",现在告警量直接降了90%,半夜再也没被吵起来过。
你看,很多时候不是技术不行,是你根本没把可观测性用在对的地方。
别神化它。
它就是个工具。能帮你少加班,少背锅,少在大促的时候手忙脚乱找问题,就够了。