零知识证明:不暴露秘密就能完成验证,到底难在哪
你有没有过这种时刻?
去银行办业务要证明你是账户所有人,却不想把身份证号、手机号、家庭住址这些敏感信息全塞给对面的柜员;申请补贴要证明你符合收入门槛,却不想把近半年的工资流水、兼职收入全晒在审核人员面前。这种“不用掏家底就能证明自己符合要求”的技术,就是零知识证明。
最早的逻辑原型,根本不是为了搞区块链
很多人第一次接触这个技术,是在Web3的项目宣传里,默认它就是为了链上匿名交易发明的。根本不是。
1985年,三位密码学家在学术论文里正式提出这套逻辑的时候,根本没想过几十年后会有区块链这种东西。最经典的解释原型是那个流传了快40年的阿里巴巴洞穴模型:环形的山洞中间有一道上了锁的暗门,证明者要向站在洞口的验证者证明,自己知道打开暗门的咒语,却不能把咒语说出来,也不能当着验证者的面走到暗门跟前开门。
解法其实很简单。证明者每次随机选山洞的左侧或者右侧通道走进山洞深处,验证者在洞口喊出指令,要求证明者从指定的通道走出来。如果证明者真的知道暗门的咒语,不管验证者要求从哪个方向出来,他都可以穿过暗门绕到指定的通道;如果他不知道咒语,第一次蒙对方向的概率是50%,连续蒙对十次的概率就不到千分之一,根本不可能长期作弊。
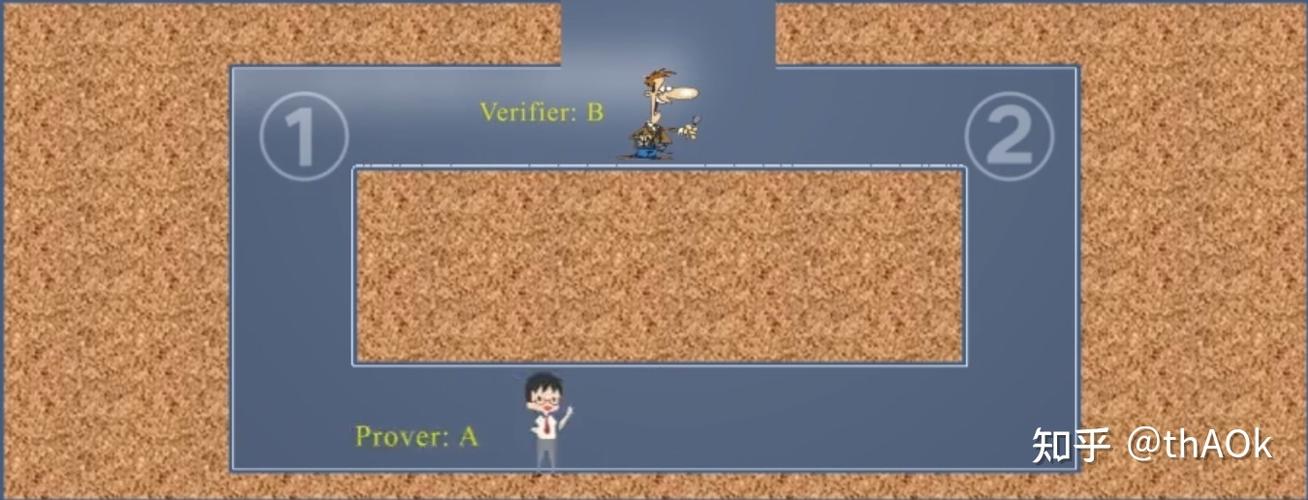 阿里巴巴洞穴零知识证明交互示意图
这套逻辑最早的落地场景,其实是冷战时期的军事身份验证——两个分属不同阵地的作战单位,要在没有第三方可信节点的前提下确认对方身份,又不想把己方的加密密钥、通信频率这些核心机密泄露出去,就用这套交互逻辑完成验证。说实话,现在打开任何一个讲这个技术的科普文章,十有八九第一句就扯以太坊的扩容项目,好像这技术是2017年才从石头里蹦出来的,真的挺离谱的。
零知识证明的核心逻辑从来不是“藏住所有信息”,而是“只暴露验证所必需的最少信息”。你证明自己够18岁,不需要把身份证号、家庭住址、出生日期全给出去,只需要让验证方知道“你提交的年龄数据大于等于18”这个结论就行,剩下的信息一点都不用多给。
工程化的第一道坎,根本不是数学问题
数学逻辑是严谨的,甚至可以说是无懈可击的。但要把这套纸面的逻辑,变成能跑在普通电脑、手机上的可用程序,麻烦才刚刚开始。
最早的一批证明系统,生成一个验证证明需要的时间,比直接把所有原始数据发出去做验证的时间长几百倍。举个最直观的例子,你要证明自己的账户余额满足某个平台的交易门槛,用最早的系统生成证明,可能要花30秒,还要占用几百兆的内存,普通的网页端根本跑不动。用户点个按钮等半分钟,进度条转得一动不动,谁受得了?
后来的十几年里,密码学家搞出了十几套优化过的证明协议,每一套都在不同的维度做了权衡。比如有的协议证明生成速度快,验证成本也低,但需要一个公共的可信初始化过程——说白了就是要凑一群人,共同生成系统的初始参数,只要参与的人里有一个人把自己手里的参数碎片彻底销毁,整个系统的安全性就不会被破解。
 零知识证明可信初始化仪式多参与者交互现场图
没有哪套协议是完美的。不需要可信初始化的协议,往往证明生成的速度更慢,证明的体积也更大,要占更多的网络带宽。我之前帮朋友测过一个基于无初始化协议的身份验证demo,在骁龙888的手机上生成一个证明要花12秒,用户要是在地铁里信号不好,点进去转半天圈,早就退出去了。
很多人以为工程化的难点是把证明的速度提上去,其实不是。真正难的是怎么在速度、体积、安全性三者之间找一个适合具体场景的平衡点。你要是做金融机构的内部审计,哪怕生成证明要花几分钟也没关系,反正跑在服务器上,用户感知不到;但你要是做面向普通消费者的身份验证,那必须把生成时间压到2秒以内,不然体验根本过不了关。
被吹过头的应用边界,到底在哪
现在的宣传里,这个技术好像能解决所有的隐私问题——从匿名转账到身份验证,从供应链溯源到医疗数据共享,好像只要把它堆上去,所有的隐私漏洞就都补上了。真落地起来,才会发现它的边界比大家想象的窄得多。
它只能证明“你提交的信息符合某个既定规则”,根本不负责校验信息本身的真实性。比如你用这套技术申请低保,证明自己的月收入低于当地的门槛,但是你提交的收入数据是自己随便填的,哪怕证明生成得再完美,整个交互过程没有任何泄露,最后出来的结果还是假的。技术帮你藏住了数据的具体内容,但是它没法判断你录进去的数据是不是真的。之前看到有个创业公司的BP,说要用这个技术解决供应链溯源问题,让所有的商品来源不可篡改还匿名,我当时翻到第三页就关了——溯源的核心问题本来就是源头的数据录入是不是真实的,你就算用再强的加密,录进去的是假数据,最后生成的证明不还是假的?
哪怕技术本身的数学逻辑是安全的,只要工程实现上漏一个洞,所有的隐私保护就全白搭。之前有个主打匿名转账的项目,宣传说用了最先进的证明系统,没人能查到你的资金流向,结果最后因为开发者把用户的转账关联日志存在了没加密的服务器上,所有的匿名记录全被扒得一干二净。这不是技术的问题。是落地的问题。
还有一个很容易被忽略的边界,就是完全匿名的技术,天生就会和监管要求产生冲突。如果一套系统完全没法识别用户的真实身份,很容易被用来做洗钱、诈骗这些违法的事,最后肯定会被监管盯上。现在做落地的团队,其实都在找一个中间的平衡点:既要保护用户的隐私,不让无关的人看到用户的敏感信息,也要给监管留一个可追溯的口子,不能让系统变成法外之地。
上周跟一个做密码学研究的朋友吃饭,他说现在好多人把这套技术捧成下一代互联网的核心,好像只要把它堆上去,所有的隐私问题就都解决了。我倒觉得没那么玄乎。它本质上就是个工具。就像你手里的螺丝刀,能拧螺丝,能拆东西,但是你要是拿它去切菜,肯定不好用。没必要把它吹得无所不能,也没必要因为之前出过几个安全漏洞就把它贬得一无是处。毕竟从1985年那三个学者在论文里写下第一行公式开始,它走了快40年,才从学术圈的草稿纸走到普通人的手机里。后面的路还长。