跑大模型烧到心疼?异构算力调度才是被藏起来的提效绝招
上周帮做AI创业的师弟查云账单,他盯着后台的数字愣了三分钟——上个月光GPU实例的费用,比他给三个员工发的工资还多。我翻了两页调度日志,没忍住翻了个白眼。他手里攥着8张A10、4张国产NPU,还有2台跑老业务的CPU服务器,结果所有大模型推理任务全往GPU上堆,NPU闲置到落灰,CPU更是连个测试包都没跑过。
你以为的“算力闲置”,根本不是没活干
很多人觉得算力闲置,是因为买的硬件太多,没那么多任务可跑。根本不是。我见过太多企业的机房里,GPU、NPU、x86服务器混着摆,不同代际的硬件堆在一起,硬件采购的钱花了好几千万,实际跑起来的算力利用率连30%都不到。为啥?因为从一开始,大家就默认“所有算力都是一样的”。
哪能一样啊。GPU擅长并行算矩阵,跑大模型推理快,但成本是同规格CPU的十几倍;NPU针对特定AI算子优化,跑固定场景的视觉模型、文本生成模型,效率比GPU还高,成本却只有一半;CPU逻辑控制强,跑普通的web服务、数据库查询、定时报表生成,效率是GPU的几十倍。之前的调度系统是什么水平?就像个只会喊“大家一起上”的工头,根本不看每个人擅长啥,要么全把任务堆给最贵的GPU,要么随机把任务扔给空闲节点,最后就是最贵的资源干着最没必要的活,便宜的资源闲得发慌。
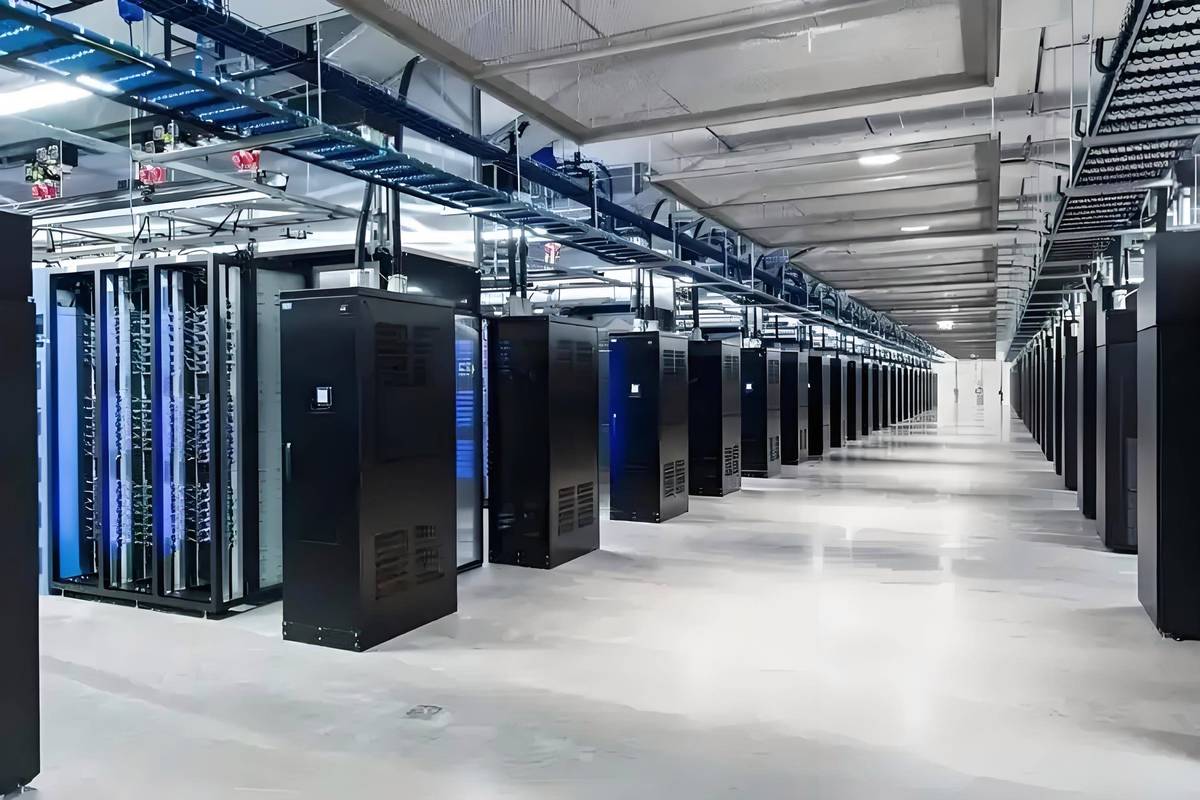 企业多架构异构算力集群机柜实拍图
说个真事。去年帮一个做智能安防的客户做算力盘点,他们机房里摆了20张GPU,全用来跑摄像头的实时画面检测——结果这些检测任务全是固定的行人识别、车辆识别,完全可以跑在更便宜的NPU上。当时算下来,要是把这些任务迁过去,每年光电费和硬件折旧就能省两百多万。客户的运维主管听完直拍大腿,说之前从来没人跟他算过这笔账。
调度系统到底在“调”什么?真不是简单的排队
很多人对调度的认知,还停留在“把任务排个队,谁有空就给谁”的阶段。错。真正能用的异构算力调度,从根上就不是这么干的。
第一步,得先给每个要跑的“任务”贴标签:这个任务是要算10亿参数的大模型实时对话?还是要跑个每天定时生成的销售报表?还是要做图像分割的批量训练?对延迟的要求是多少?能接受的成本阈值是多少?优先级是啥?第二步,要给每个算力节点打标签:这个节点是A10,适合跑70B以下的量化模型,每小时成本12块;那个是昇腾310,跑固定的视觉模型延迟能压到20ms以内,每小时成本4块;那台老x86服务器,跑个报表生成绰绰有余,每小时成本才3毛。
最核心的,是要带动态的成本核算逻辑。同样一个13B的量化模型,跑在A10上每小时12块,跑在昇腾310上每小时4块,性能差不到10%,那为啥要往GPU上堆?我之前见过最离谱的调度逻辑,是某公司的内部系统把所有用户的登录校验请求,全扔到了GPU集群上跑。那可是个纯逻辑判断的活啊,CPU一秒能处理几万次的事,GPU干这个的效率连CPU的1%都不到。相当于你请了个奥运冠军来帮你递快递,钱花了十倍,速度还慢。
而且现在的调度根本不是一锤子买卖。比如你正在跑的推理任务,本来在GPU上,突然GPU集群来了个优先级更高的模型训练任务,系统会自动把这个推理任务切到旁边闲置的NPU节点上,甚至在切换的时候做个上下文的序列化,用户那边根本感觉不到断连。上个月我们团队做的调度策略迭代,把原来全量跑在A10上的13B模型推理任务,按请求的类型拆分:对延迟要求极高的实时对话请求留10%的GPU节点兜底,剩下的批量文本生成请求全导到闲置的国产NPU上,当月的GPU云费用直接降了62%——说真的,看到账单的时候我差点在工位上喊出来。
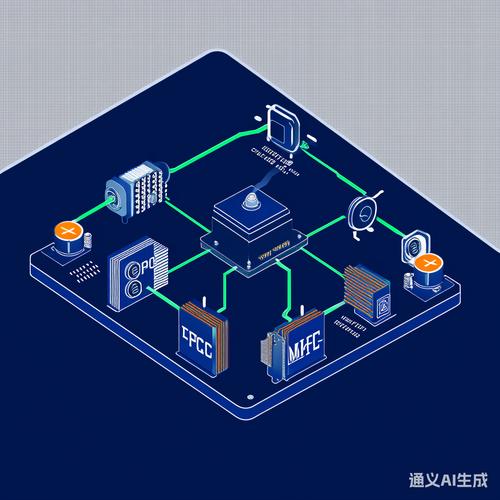 异构算力调度任务匹配逻辑示意图
不过话说回来,调度也不是越细越好。之前我们试过把推理任务拆成单算子粒度去调度,结果网络传输的开销比算力本身的开销还大,纯纯赔本买卖。粒度太粗的话,又容易出现某个节点负载拉满,其他节点闲得发慌的情况,这里面的平衡,全是一线工程师踩坑踩出来的,根本不是厂商宣传里那种“一键智能”的噱头。
别被厂商的宣传忽悠了,这几个坑踩一次亏几十万
说实话,我见过太多被厂商销售忽悠的企业,花了大价钱上系统,最后发现根本用不起来。这里面的坑,真的得提前打个预防针。
第一个坑,以为买了带“异构调度”标签的系统,就能自动跨架构跑任务。错。很多厂商卖的所谓“异构调度”,其实就是个简单的资源池监控面板,连最基础的跨架构的算子适配能力都没有。你把一个跑在CUDA上的模型直接扔到NPU节点上,根本跑不起来,系统连个报错提示都没有,光报个节点空闲有啥用?我之前碰过一个客户,花了三百万买的调度系统,最后发现连国产NPU的驱动都适配不好,所有任务还是只能跑在原来的GPU上,纯纯交了智商税。
第二个坑,觉得所有任务都要往最便宜的算力上塞。比如你要跑个需要高并发的实时交互,结果全导到性能弱的CPU上,用户发一句话等三秒才出结果,那点省下来的算力钱,全得赔到用户流失上。之前给一个做在线教育的客户做诊断,他们为了省算力,把实时的AI答疑任务全放到了闲置的老服务器上,高峰期的时候用户提问的平均响应时间到了8秒,当月的用户留存直接掉了15个百分点,算下来亏的钱够买三年的GPU资源。
第三个坑,把业务优先级和算力调度完全割裂开。比如电商大促的时候,订单系统的算力需求是最高优先级的,你要是把订单处理的任务扔到闲置的老服务器上,卡个几秒,那损失可比算力贵多了。之前有个做电商的客户,花了大价钱上了一套调度系统,结果把大促当天的用户画像分析任务,和订单支付的任务放在同一个优先级队列里,高峰期的时候两个任务抢资源,支付接口卡了整整40秒,后台统计的流失订单快有小十万。我看完他们的调度规则,真的想顺着网线过去拍他们运维的肩膀——这哪是调度,这是给自己找事故呢。
上次那个被账单吓傻的师弟,上周给我发了个截图,按照我们调整的调度规则跑了半个月,GPU的费用降了一半还多,剩下的预算刚好能给他的团队发个季度奖金。其实哪有什么魔法啊。就是把每一块算力,放到它最擅长的位置上而已。