近存计算:打破内存墙的务实选择,而非行业终局
上周帮实验室里的博士生调大模型推理的性能,跑了整整3天,发现GPU的算力利用率连15%都不到。他盯着监控屏骂了半小时。计算单元闲得能长出草来,数据还在显存和内存之间来回跑,真正花在计算上的时间,连总耗时的两成都不到。
被忽略的性能损耗:不是算不动,是喂不饱
传统冯诺依曼架构跑了快80年,核心逻辑从来没变过:计算单元和存储单元物理分离,所有要处理的数据,都要从存储端搬到计算端,算完的结果再搬回存储端。在数据密集型负载下,数据搬运带来的能耗占总系统能耗的60%以上,延迟占比超过70%。
举个最常见的例子,跑70B参数的大模型做推理,每次前向传播,要把所有权重从HBM显存搬到GPU计算核心旁边的高速SRAM里,整个过程计算单元的占用率从来没超过20%,大部分时间都在等数据通路的带宽跑满。过去十年,行业解决这个问题的思路很简单:把内存的带宽做的更高。从DDR4到DDR5,从HBM2到HBM3,带宽翻了好几倍,但GPU的计算峰值同期涨了15倍,两者的差距反而越拉越大,这就是卡了整个行业几十年的内存墙。
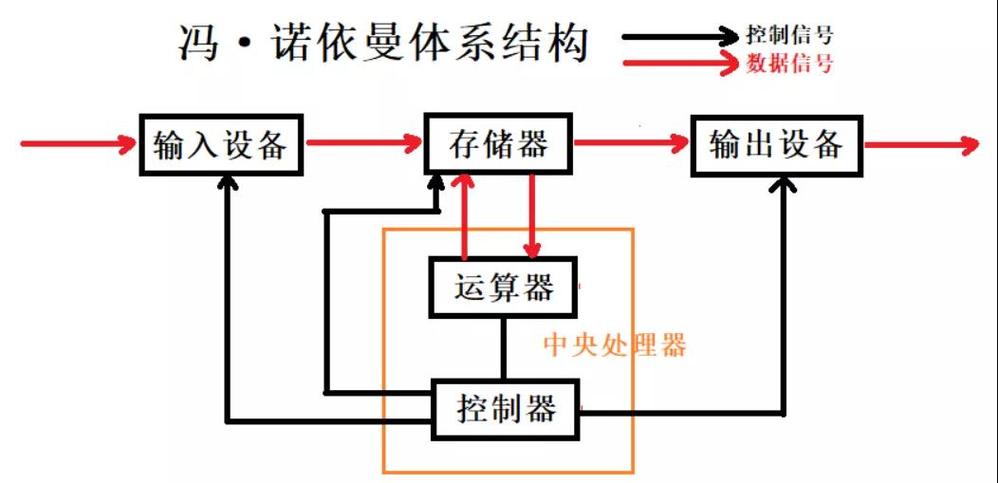 传统冯诺依曼架构数据搬运路径示意图
把计算单元搬到离存储最近的地方
近存计算的核心逻辑根本不复杂。就是打破计算和存储的物理距离,把计算单元直接集成在存储芯片旁边,或者和存储芯片做在同一个封装里,让数据不用跑那么远就能被处理到。这根本不是什么新发明,上世纪90年代的学术期刊上就有相关的研究论文,之前一直没落地,核心原因是工艺不兼容——逻辑电路和存储电路的制造流程差得太远,硬把两者做在同一块晶圆上,良率低到根本没法商用。
直到最近几年3D堆叠工艺成熟,这条路才真正走得通。现在主流商用近存计算芯片的实现路径,是把专门设计的计算die和多层存储die通过垂直硅通孔互连,堆叠在同一封装内部。这种结构下,计算单元和存储单元之间的互连带宽比传统板级互连高一个数量级,延迟能降低70%以上,长距离数据搬运的能耗能省80%。
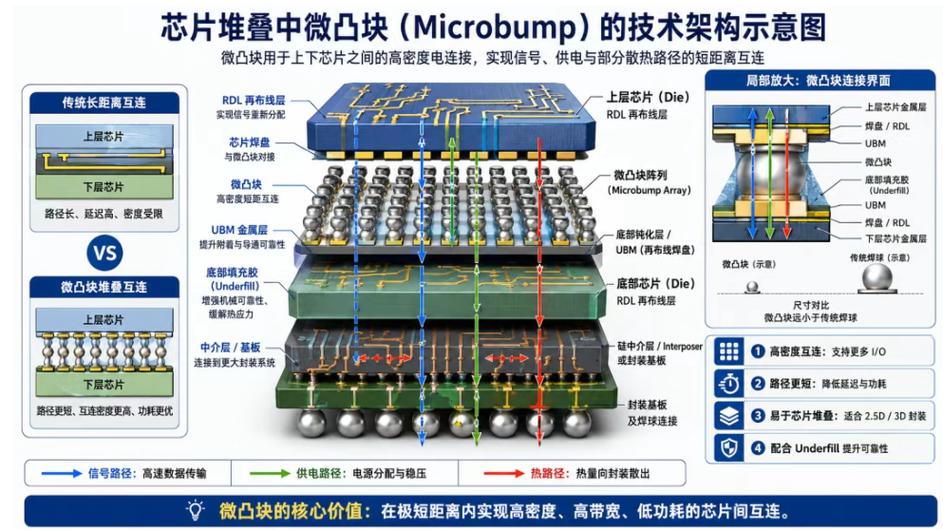 3D堆叠近存计算芯片封装结构示意图
但这从来不是什么万能解药。这种架构的优势只在特定场景下才能发挥:比如大模型推理、向量数据库的相似度检索、基因组序列比对这类负载,核心特点是计算逻辑简单,但是需要读取海量的静态数据,这时候减少数据搬运的收益最大。但要是跑需要高精度浮点计算的数值仿真,或者带复杂分支跳转的操作系统内核,它的优势就会完全消失——为了在存储旁边集成足够多的计算单元,一般会把计算单元做的结构更简单,牺牲一部分计算精度和灵活性,这时候性能反而不如传统的分离式架构。
落地绕不开的三道现实坎
 落地绕不开的三道现实坎
现在行业里对这类架构的宣传有点过了,好像只要用上这个技术,大模型的推理成本就能降90%,AI应用的落地门槛就能直接打对折。真到实际落地的时候,全是绕不开的坑。
第一个坑是软件栈的适配成本。现在所有的通用计算框架、编译器、操作系统,都是为计算和存储分离的架构设计的。这种架构下,计算单元是和固定的存储块绑定的,程序员要手动把数据放到对应计算单元旁边的存储区域,不然跨块搬运数据的损耗又会回来,之前吹的性能提升直接打对折。之前接触过一个做这类芯片的初创团队,硬件研发花了16个月,结果软件栈适配花了27个月,光改编译器的内存寻址逻辑就花了8个月。
第二个坑是良率和成本的平衡。3D堆叠的结构里,只要其中一层die有缺陷,整个芯片就会报废,叠的层数越多,良率越低。现在叠8层存储die的这类芯片,良率大概只有同工艺单片逻辑芯片的60%,成本是传统同算力GPU的1.6倍。要是想叠16层把存储容量做上去,良率可能掉到30%,根本没法大规模出货。
第三个坑是散热的问题。3D堆叠的结构是把好几层die压在一起,热量很难从封装内部散出去。之前有团队做过测试,满负载运行的这类芯片,核心温度能到92度,必须配专门的单面液冷才能稳定运行,这对数据中心来说又是额外的建设和运维成本,算下来整体的TCO根本没有大家想的那么低。
经常有人问,这种思路是不是过渡技术?等未来存内计算成熟了,是不是就会被完全替代。其实根本不是。存内计算是把计算电路直接做在存储单元的内部,带宽更高,能耗更低,但存内计算的灵活性极差,现在能实现的计算操作非常有限,根本没法跑复杂的控制逻辑,未来很长一段时间都只能作为这类架构的补充,在特定的简单计算场景里发挥作用,不可能完全替代近存计算。
上个月去南京参加集成电路产业的闭门会,碰到一个在存储行业做了22年的老工程师。他说过去几十年大家都在卷计算单元的频率、核心数,好像把计算能力做的越高,系统性能就越好,结果绕了一大圈,发现最朴素的道理反而最有效——数据不用跑远,系统自然就快了。
近存计算从来不是什么颠覆性的黑科技。它只是把之前被浪费在长距离数据搬运上的时间和功耗,一点点捡回来而已。没有万能的架构。适合的场景,才是最好的选择。