联邦学习中的非独立同分布:别被论文里的理想场景骗了
上周跟某城商行的算法团队吃饭,桌上的烤串都凉了没人动——他们跑了三周的联邦学习风控模型,离线测试集上准确率92%,一上线直接掉成67%。问题出在哪?全栽在联邦学习中的非独立同分布上了。
很多人对联邦学习的初始认知,都来自教科书里的理想假设:所有参与方持有的数据,跟全局数据集的分布完全一致,标签、特征、样本量都差不多。说白了就是A银行的客户画像跟B银行的没差,A医院的病例结构跟B医院的也对齐,这种情况下跑FedAvg,效果跟集中式训练差不了几个点。
你以为的“数据分布”,根本不存在
我自己读博的时候也被这种理想场景骗了快半年。当时切了MNIST数据集,给每个客户端分均匀的手写数字样本,跑出来的模型准确率跟集中式训练差了不到1个点,还以为自己摸到了联邦学习的核心。等接了第一个真实企业项目才被教育做人——哪有那么多整齐划一的分布?
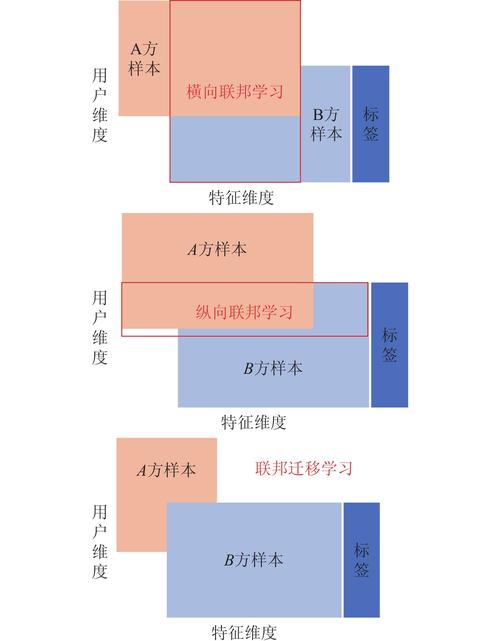 联邦学习独立同分布与非独立同分布数据分布对比示意图
真实世界里的非独立同分布,根本不是教科书里轻描淡写的“分布差异”,是完全不同维度的错位:
第一种是标签倾斜。比如参与方A的数据集里90%是肺癌病例,参与方B的数据集里90%是糖尿病病例,两边凑起来做全局多病种识别,要是按常规的FedAvg聚合,模型最后学到的东西全是两边标签的平均,对单病种的识别率能跌到30%以下。
第二种是特征倾斜。同样是做用户消费能力预测,线下零售品牌的用户大多是三四线城市的中老年群体,消费记录以生鲜、日用品为主;互联网平台的用户大多是一二线城市的年轻人,消费记录以潮玩、演出、数码产品为主。两边输入的特征分布差了十万八千里,全局模型根本没法同时适配两边的特征模式。
第三种是数量倾斜。参与方A有100万条有效数据,参与方B只有1万条,常规聚合的时候小参与方的梯度直接被大参与方的淹没,最后训出来的模型跟只用A方数据训的没区别,B方的参与价值约等于零。
去年某头部互联网公司跟线下连锁品牌做联合销量预测,就栽在特征倾斜上。一开始没做适配,模型对三四线门店的销量预测误差超过40%,团队蹲在门店跑了快三个月的特征对齐,才把误差压到15%以内。
别再拿“调聚合权重”当万能解法了
很多人刚碰到非独立同分布的问题,第一反应是偷懒:不就是分布不一样吗?给小参与方多加点聚合权重,给本地训练加个正则项约束一下,不就解决了?
我之前帮一个跨医院的医疗项目调优,一开始就抱着这种偷懒的心态,上来就用了FedProx的近端正则项,想把本地模型跟全局模型的距离约束住。结果跑了两周,模型收敛速度慢到离谱——本来30轮就能收敛的任务,跑了80轮准确率还在原地晃,最后拆了正则项才发现,因为不同医院的特征偏移太大,近端项直接把模型的个性化适配能力给锁死了。
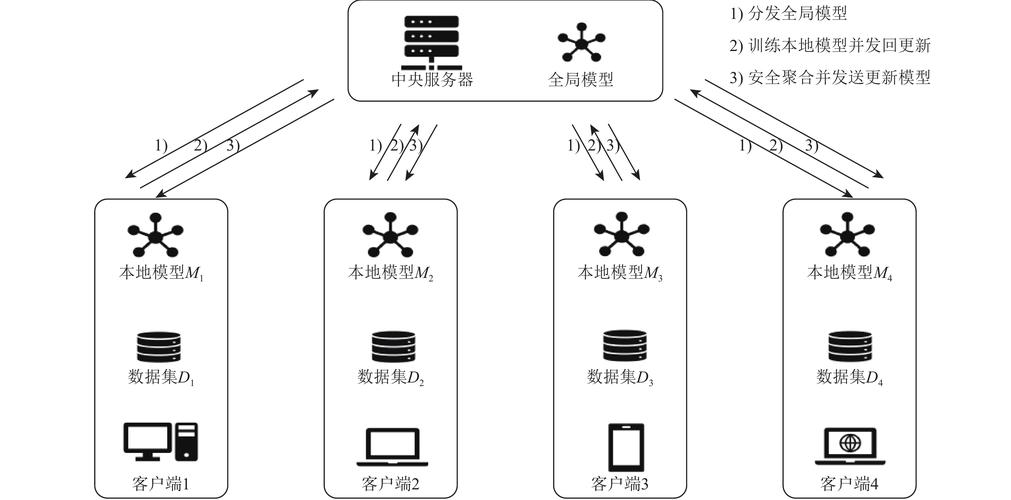 个性化联邦学习共享特征提取器与本地分类头结构示意图
这两年行业里的思路其实早就变了。大家慢慢意识到,非要让所有参与方最后拿到一个一模一样的全局模型,本身就是反常识的——不同参与方的数据分布本来就不一样,凭什么要求一个模型能适配所有场景?
现在落地效果比较好的方案,基本都是个性化联邦学习的思路:全局部分只共享通用的特征提取层,比如用户的通用行为模式、病例的通用症状特征,每个参与方自己留一个本地分类头,用自己的本地数据微调。之前给两个异地城商行做联合风控,一开始用纯FedAvg,A行的坏账识别率89%,B行只有62%,换成这种共享特征层+本地分类头的架构之后,两边的识别率都冲到了85%以上,才堪堪过了项目验收线。
那些论文不会主动说的落地坑
说个没人愿意在公开场合提的事:现在很多顶会论文里的非独立同分布实验,设置得极端到脱离现实。比如把MNIST的10个数字类,每个类单独分给一个客户端,也就是每个客户端只有1个类的样本,这种极端的标签倾斜,在真实业务里几乎碰不到。真实场景里的非独立同分布是连续的、渐进的偏移,不是完全的类别割裂。
我之前见过一个团队,把论文里针对极端标签倾斜设计的算法,直接套到只有轻微特征偏移的推荐场景里,结果模型收敛速度比原来的FedAvg还慢,准确率掉了5个点,白折腾了一个多月。
还有个更要命的坑:合规要求。很多时候你根本拿不到其他参与方的任何数据统计信息——你不知道对方的标签占比是多少,不知道对方的特征分布是什么样的,甚至连对方有多少条有效样本都只能拿到一个模糊的量级。上次参加行业沙龙,有个做合规的老师直接放了17种从梯度里反推数据分布的攻击方法,说但凡你上传的统计量里有一点能反推分布的信息,都过不了等保。
这两年大家摸出来的可行路径,是基于梯度相似度的动态调整。不用拿到原始数据,也不用拿到统计信息,就通过每轮上传的梯度向量的余弦相似度,判断参与方之间的分布偏移程度。要是两个参与方的梯度余弦相似度只有0.3,说明偏移很大,聚合的时候就别硬把两边的权重拉到一起,多给本地模型留一点调整空间。某做医疗联邦的团队用这个方法,在跨三个省的医院数据集上,模型平均准确率比纯FedAvg高了11个点,合规要求也全满足。
其实说白了。
联邦学习从实验室走到真实场景,最绕不开的坎从来不是什么算法精度提升0.1个点,而是你能不能真的接住现实里那些乱七八糟的分布偏移。
没有哪个真实世界的数据集,会乖乖按照你论文里的假设,整整齐齐排成独立同分布的样子。对吧?