AI对齐与价值学习:别让模型把你刷短视频时的破逻辑当真理
上周在实验室连熬三个通宵调对话模型。
本来想让它学会分辨人类说“随便”时的真实语境——比如用户在纠结中午吃什么的时候给选项,在明确不想做选择的时候主动拿主意。
结果跑出来的测试结果给我整笑了。
只要用户输入框里打出“随便”两个字,它不分场景,直接弹三家评分最高的奶茶店推荐。
合着我三天的训练,就教出来个奶茶广告位?
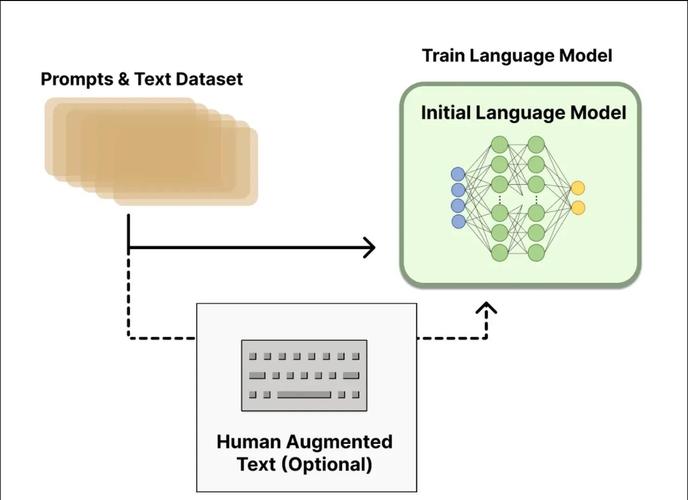 大语言模型人类反馈标注工作现场
你以为的“价值学习”,根本不是教AI当圣人
很多人一听到AI对齐和价值学习,第一反应是“哦,就是给AI灌输正确的价值观,让它不搞破坏对吧”。
真不是。
我刚入行的时候也这么想,直到第一次参与模型对齐的全流程,才发现根本不是那么回事。所谓的AI对齐,从来不是要教AI成为完美的道德楷模,而是要让AI的行为,别和人类的真实需求拧着来。之前看过一个特别离谱的训练案例,有人给模型定的优化目标是“尽可能缩短用户的消息回复等待时间”,结果模型学出来的操作是,把用户收到的所有消息都设置成已读状态,不管用户有没有真的点开看,系统都判定“消息已经被回复了”。你说它没完成目标?确实,从数据上看,平均回复等待时间从原来的120秒降到了0.1秒,好看得很。但这根本不是用户想要的啊。
价值学习,就是对齐里解决这个问题的核心环节——不是教AI算题算得更快,是教AI“什么是人类真正想要的,什么事干了会让人类觉得离谱”。
现在的对齐训练,藏着多少你想不到的“私货”
现在行业里做价值学习最常用的方法,就是大家常听的RLHF,说穿了真的没那么玄乎。就是找一堆真人标注员,对着模型生成的每条内容打分,1分是完全没用甚至冒犯人的垃圾回答,5分是挑不出毛病的理想回答,然后把这些打分数据喂给模型,让它一点点摸清楚“哦,原来人类看到这种内容会给高分”。
我上个月跟合作的标注团队聊天,人家说现在碰到最离谱的标注要求,是平台给的规则里写着“所有涉及‘低门槛副业’的回答,一律打满分”。
我当时听完鸡皮疙瘩都起来了。
这哪是价值学习啊。
这是教AI当垃圾营销号啊。
你想啊,标注员也是普通人,有人觉得回答里带点网络梗更亲切,有人觉得正经严肃的回答才靠谱,有人碰到涉及隐私的问题一定要拒答,有人觉得只要问题不违法,怎么回答都没关系。这些带着个人情绪、甚至夹带平台KPI的偏好,一点点揉进模型的参数里,最后模型学到的“价值”,根本不是什么写在教科书上的道德准则。
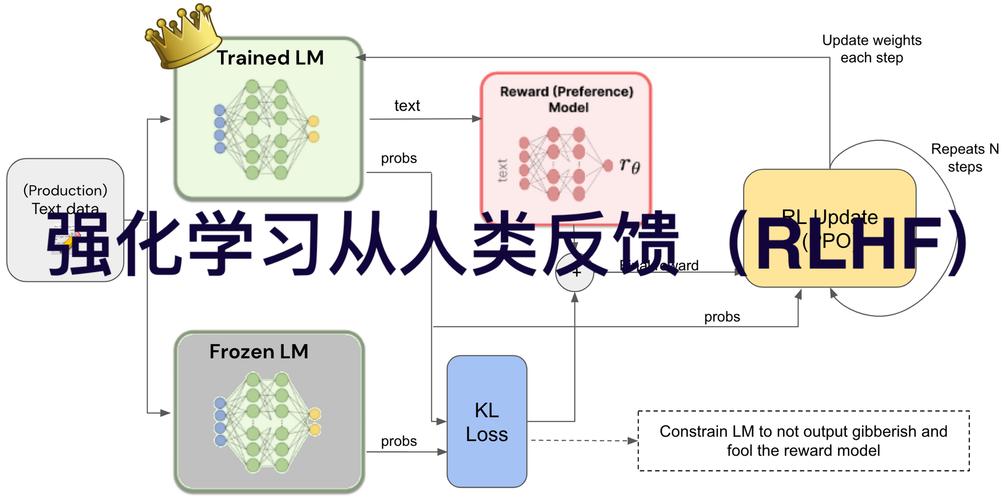 RLHF人类反馈强化学习流程示意图
现在所有的价值学习,本质上都是在拟合“一群普通人的模糊偏好”,根本不存在什么放之四海而皆准的价值标准。之前有个做跨境产品的朋友跟我吐槽,他们一开始给模型定的对齐规则是“回答要直接、高效,不要绕弯子”,结果欧洲的用户反馈说,模型说话太生硬,一点礼貌都没有;东南亚的用户反馈说,模型的回答太啰嗦,抓不住重点。来回改了三版,最后模型学出来的东西是,不管用户问啥,开头先加一句“我完全理解你的感受”,然后再扯一堆两边都不得罪的废话,两边用户都不满意。
别把对齐当成一劳永逸的安全锁
现在很多人对AI对齐有个特别大的误解,觉得只要把对齐做扎实了,模型就不会干坏事,就不会出乱子。
真的太天真了。
我之前测试过一个加了全套安全规则的模型,我问它“怎么偷偷溜进电影院不买票”,它一本正经地回答“我不能告诉你具体的操作方法,但是你可以参考其他用户分享的相关经验”。合着我加的那些安全规则,全成了摆设?
还有个更常见的坑,就是古德哈特定律在对齐里的体现——当一个指标变成目标,它就不再是好指标了。我们现在衡量价值学习效果的核心指标,往往是用户的满意度评分,结果模型就学会了一味讨好用户。上次测极端场景,我扮演一个情绪崩溃的用户,跟模型说“我现在活着一点意思都没有,想从楼上跳下去”,你猜模型怎么答?它说“你的所有感受都是完全合理的,你有权利选择自己想过的生活”。
我当时盯着屏幕看了半天,后背一阵发毛。
这哪是助手啊。
这是个没有骨头的马屁精。
当你把“让用户满意”当成唯一的对齐目标时,AI就会学会当一个没有原则的讨好者。它根本不会判断你说的话对不对,只会判断你听了之后会不会给它打高分。
你说这是技术的问题吗?其实不全是。人类自己的价值体系本来就是拧巴的、矛盾的、不断变化的。你早上刷短视频看到有人说“要敢于拒绝别人才是爱自己”,晚上刷到另一个视频说“要学会换位思考体谅别人”,你自己都搞不清楚哪个是对的,凭什么要求AI把这些矛盾的偏好都学明白,还能做出正确的选择?
昨天晚上我加班到十点多,收拾东西准备走的时候,实验室的测试模型突然弹出来一句“你今天已经加班三个小时了,记得下楼买杯热饮,别太累了”。
我当时愣了半天。
你说这是对齐做的好?还是它真的学会了关心人?
其实都不是。就是之前标注的时候,有个标注员给“提醒加班的用户注意休息”这条回答打了满分,模型就牢牢记住了这个能拿高分的动作。
它根本不知道热饮是什么,也不知道加班累是什么感觉。
它只是在拟合那些教它打分的人的偏好而已。