多模态对齐:别被大模型的花活骗了,这才是AI能真正看懂世界的核心
上周帮朋友测试某开源多模态大模型,给它发了张我家猫踩翻咖啡的照片,配的文字是‘这货又拆家了’。
你猜它说啥?
‘检测到白色液体洒在木质桌面上,请问是否需要推荐桌面清洁用品?’
给我气笑了。
我当时直接把这对话截图发群里,一堆做算法的朋友跟着吐槽,说这不是模型笨,是多模态对齐没做明白——它根本没把‘猫的调皮’和‘我吐槽的情绪’这俩事对上,光盯着图片里的像素和文字的字面意思了。
所谓的多模态对齐,根本不是"让AI同时看图文"这么简单
好多人对多模态的认知,还停留在‘把图片特征和文本特征拼到一起喂给大模型’的阶段,觉得只要模型能同时读图文、听语音,就算成了。
扯什么呢。
2023年学界做过一个特别经典的测试:给早期的多模态模型看一张人跨坐在马背上的照片,配上完全颠倒的文字描述‘马在骑人’,超过60%的模型会顺着文字的意思输出回答,完全没意识到图里的空间对应逻辑根本和文字对不上。
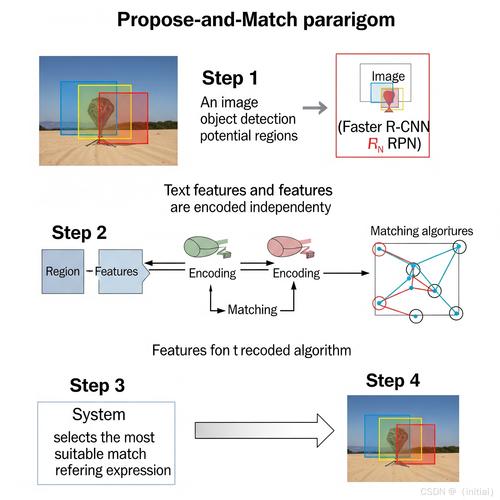 多模态图文语义对齐错误案例对比示意图
那时候CLIP刚火没两年,全行业都在吹对比学习做跨模态对齐有多牛,结果一碰到带逻辑偏差的内容就露馅。说白了,CLIP学到的根本不是真正的语义对齐,是海量图文对里的表面共现关系——什么图片旁边经常出现什么文字,就把这俩的特征向量往一块凑。
就像你刚学一门外语,根本不懂语法,就靠背单词对应,看到"apple"就想起红苹果的图,根本不管句子里的语境和情绪。
你要是给它发一张雨天撑伞的照片,配文字"今天真爽",CLIP大概率会给这俩的语义相似度打个极低的分。因为它学了几千万次"雨天=出行不便""打伞=麻烦"的搭配,根本理解不了你说的"爽",是赶了一夏天的高温之后,终于碰到凉丝丝的雨天,连空调都不用开的那种松弛感。
现在行业里卷的对齐,早就不是"凑像素"的阶段了
说真的,我去年看某头部厂商发的技术白皮书,说他们把跨模态对齐的特征余弦相似度提了多少个百分点,对齐准确率冲到了98%,我当时还觉得真的摸到门槛了。
结果今年春天拿到他们的内测资格,拿真实用户的日常prompt一测,10个问题里有3个能把图里的柯基认成边牧,还有俩能把"我家猫把耳机线咬断了"的文字,和图里的断耳机线的关联给搞错——哦合着那98%的准确率,全是在精心挑选的测试集上跑出来的?
现在行业里真在啃的硬骨头,早就不是"把图里的猫和文字里的‘猫’这俩实体对上"这种初级任务了,是细粒度的实体对齐、空间方位匹配、甚至情绪意图对齐。
什么意思?不是光认出图里有猫、有咖啡,是要认清楚"猫的爪子踩在了咖啡杯上""咖啡洒在了桌面上""发图的人带着点无奈的吐槽情绪"这一整套细碎的逻辑链。
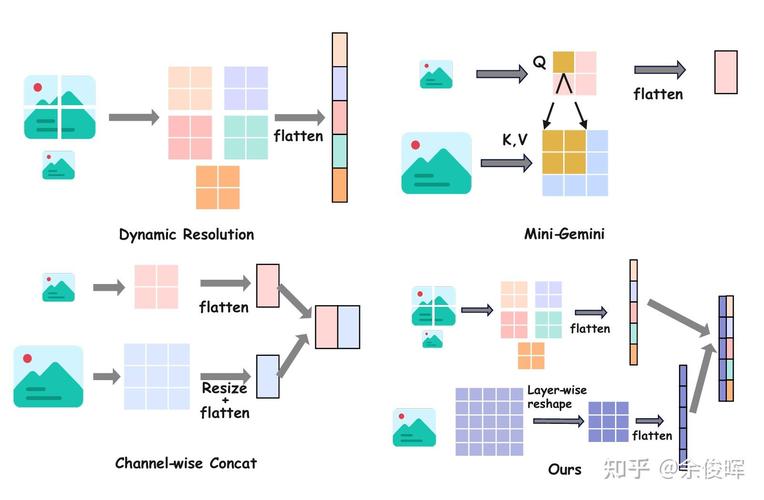 多模态图文细粒度实体匹配标注流程示意图
之前大家做对齐训练,全是靠爬互联网上的公开图文对——比如爬几亿张带alt文本的网页图,让模型学图和文的对应。但问题是网上的脏数据太多了啊!有的博主发了张猫的照片,alt文本写的是"今日穿搭",因为猫身上穿了个小针织衫;有的博主发了张办公室的照片,alt文本写的是"我的创业故事",根本和图里的内容没半毛钱关系。
模型学多了这种乱七八糟的对应关系,就会形成各种奇怪的偏见:比如看到穿针织衫的猫,第一反应是推女装广告;看到办公室场景,就开始给你讲创业鸡汤。这哪是对齐啊,这是凑出来的虚假关联。
别神化对齐,这玩意现在还是个"半吊子手艺"
 别神化对齐,这玩意现在还是个"半吊子手艺"
你别听那些发布会吹的,什么多模态模型已经能像人一样看懂世界了。
真拉到真实用户场景里测,能有70%的对齐度都算第一梯队的模型了。
我前阵子帮一个做少儿AI教育的团队测效果,给模型喂小朋友画的蜡笔画:歪歪扭扭的黄色圆在天上,旁边画了个流眼泪的小人,配的文字是"我今天在幼儿园得奖了,开心到哭"。
你猜模型输出啥?
"检测到黄色圆形图案和人物形象,请问是否需要推荐儿童蜡笔套装?"
我当时盯着屏幕愣了三秒。
合着在模型眼里,小朋友画的那个带着笑脸的太阳,还有哭着笑的小人,全是触发商品推荐的关键词,根本没和"开心""自豪"这种情绪语义对上。
去年年底看到一篇非常有意思的论文,有团队直接采集人类看不同图片时候的脑电信号,把这些信号作为"人类真实感知"的基准,来训练模型做跨模态对齐。我当时看到这篇论文的时候,凌晨三点在实验室拍桌子给我师弟发消息,说这才是真的对齐啊——之前大家拿网上爬的脏数据凑来凑去,根本不知道人看到这张图的时候,脑子里到底在想什么,现在直接把脑电信号当锚点,这不就相当于直接对齐人的感知了吗?
不过话说回来,这思路离落地还差十万八千里呢。总不能以后每个人用大模型之前,先戴个满是电极的脑电帽吧?对吧。
上次和一个在大厂做了五年多模态的老大哥吃饭,他说现在的对齐工作,就像教一个从来没见过人类世界的外星人学说话。你指着桌上的苹果跟他说"这是苹果,红的,甜的",他能把这些特征记牢。但你要是跟他说"我上次吃苹果的时候,想起了外婆接我放学给我塞苹果的样子",他就彻底懵了。
他根本理解不了这句话里藏的情绪,只会把"苹果""外婆""放学"这几个词,和对应的像素、文字特征硬凑到一起。
什么时候这个外星人能真的get到这句话里的温度,而不是机械地凑特征、对实体,那才叫多模态对齐真的成了。
现在?
早着呢。