被大模型幻觉坑到改了八版方案?聊聊检索增强生成的落地真相
上周三晚上十点,我刚泡好藤椒泡面,客户的电话就打过来了。小姑娘带着哭腔,说之前我们搭的大模型客服系统,把两年前的旧促销政策当成今年的念给了三个核心大客户,现在人家运营总监已经在群里发了火,要求第二天就给解决方案。
我当时脑子嗡的一声,拎着电脑包就往客户公司冲。等赶到的时候已经十一点半,会议室的白板上写满了投诉的记录——要么是把停售产品的参数当在售的讲,要么是把去年的渠道返点政策套到今年的代理商身上。
很多人遇到大模型瞎编的问题,第一反应是“这模型不行,得换个更大的”。真不是。
你想啊,大模型的所有知识,都是在预训练阶段就刻在参数里的。就像你高中考完高考,把所有课本都卖了,脑子里只留了点模糊的记忆——你能记得三角函数的公式,但你绝对记不清高三下学期第三次模考的最后一道大题是怎么解的。这时候你硬让它闭卷答你们公司去年改了八版的报销制度、今年刚更新的渠道返点规则,它不瞎编才怪。
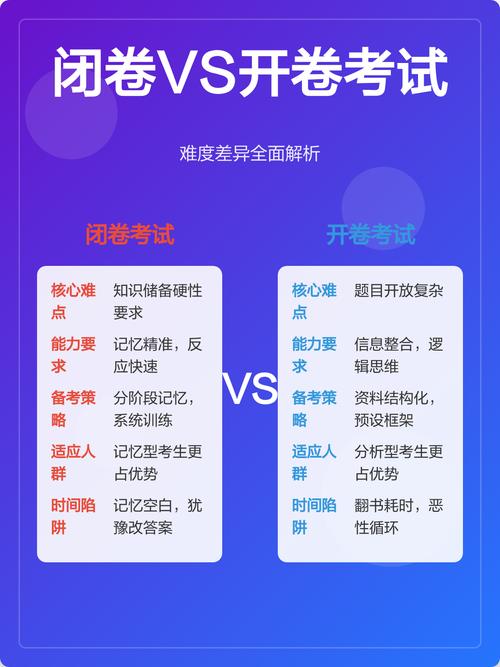 大模型闭卷推理与开卷检索对比示意图
检索增强生成说白了,就是给它把闭卷考试改成开卷。每次用户提问的时候,先从企业自己的知识库、产品文档、历史沟通记录里,把和问题强相关的内容全捞出来,塞到给大模型的提示词最前面,明明白白告诉它:你就照着这些材料答,材料里没有的就直接说不知道,别自己瞎发挥。
检索增强生成的核心从来不是让大模型变得更聪明,而是给它划好回答的边界,把最准确的实时信息递到它嘴边。
说实话,我刚接触这技术的时候,还觉得这路子是不是太“投机”了——不就是先搜一下,再让模型润色吗?直到那次客户的投诉事件之后,我才反应过来,那些砸进去几百万训专属大模型的企业,十有八九最后落地的效果,还不如把检索做扎实的检索增强生成系统。毕竟你再怎么调模型参数,等你们下个月新上了个产品,总不能停掉业务,花俩月重新训一遍模型吧?
我见过太多团队做检索增强生成,第一步就走歪了。
他们的所谓检索,就是搭个最基础的全文搜索框,用户输入“返点”,就把所有文档里带“返点”两个字的内容全捞出来,塞给大模型。结果呢?用户问“华东区今年三月签的代理商,满多少销售额能拿额外返点”,系统捞出来的全是去年华北区的返点政策,甚至还有十年前的老渠道规则,大模型照着念,不出错才怪。
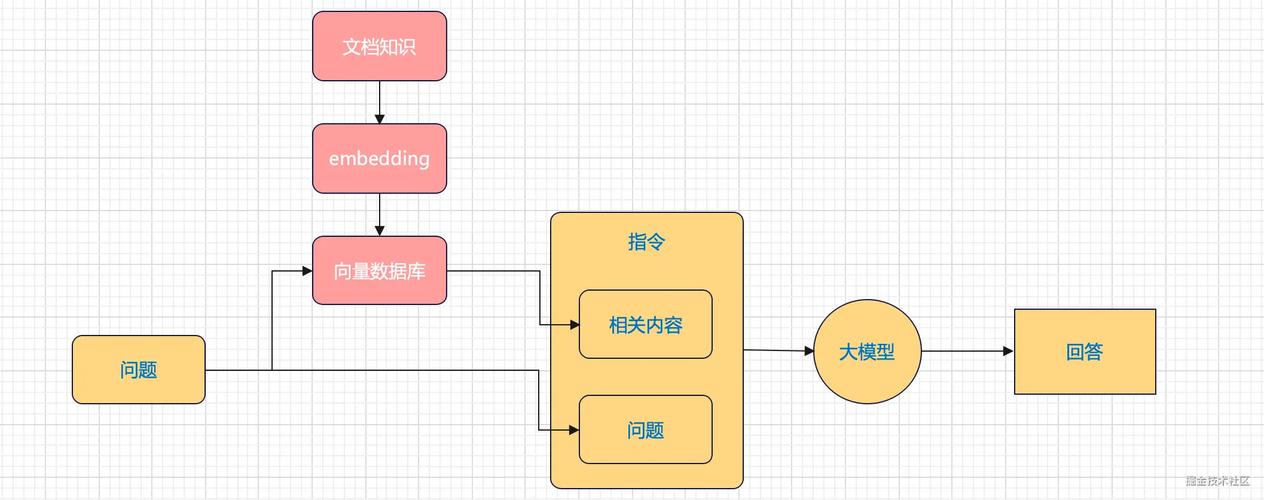 企业知识库语义分块与向量检索流程图
真正好用的检索,根本不是匹配关键词。
首先得把所有的文档拆成适合阅读的语义块——不是按文件的页码硬拆,是按内容的逻辑拆。比如讲华东区2024年Q1返点政策的那一段,不管它在PDF的第几页,拆出来的时候就给它打上明确的标签:所属区域是华东,生效时间是2024年1-3月,内容类型是代理商政策,关联产品是全品类建材。
等用户提问的时候,系统不是去匹配“返点”“华东”这些字,是先理解用户提问的真实语义,再从所有的语义块里找相似度最高的内容,还要结合权限、时间这些条件自动过滤。比如你是华东区的销售提问,系统就自动把华北区、华南区的政策过滤掉,把去年过期的政策也过滤掉,只把最相关的两三个语义块捞出来,递给大模型。
上个月我们给一家做建材的客户搭系统,一开始他们的IT部门直接拿开源的全文检索接了大模型,测试的时候问“防水卷材的耐温等级”,系统直接把十年前停售的老产品手册里的-10℃参数捞出来给了用户。后来我们把所有产品手册按SKU拆成独立的语义块,给每个块加上“在售/停售”的标签,现在再问,系统自动把停售的老文档过滤掉,捞出来在售款的-30℃参数,准确率直接从之前的52%涨到了94%。
说真的,当时客户的技术负责人看完测试结果,眼睛都直了,说之前花了十几万找外包做的系统,连个能看的准确率都没到。不过话说回来,好多团队连第一步的文档分块都做不好,就想着靠大模型解决所有问题,最后摔得鼻青脸肿,也不奇怪。
现在好多厂商吹检索增强生成,说这东西能解决大模型的所有问题,上了就万事大吉。真的太扯了。
我见过踩得最多的坑,就是知识库本身就没人维护。
你想啊,要是你们公司的知识库里面,挂着三个月前就过期的政策,放着已经停售半年的产品参数,就算你的检索系统做的再精准,捞出来的也是错的内容。大模型照着错的内容答,你怪谁?之前有个客户,知识库里面存了三个版本的报销制度:2022年的住宿标准是300一天,2023年是400,2024年刚改成500。结果检索的时候三个版本都被捞出来,大模型把三个版本揉了个答案,说住宿标准是800一天,最后全公司行政部加班改了三天,才把乱掉的回答纠正过来。
第二个坑,就是权限控制的缺失。
好多人觉得检索增强生成就是个内部工具,不用做权限过滤。我之前测一个开源的检索增强生成框架,没加权限控制的时候,普通员工问“公司去年的人力成本是多少”,系统直接把核心的薪酬核算文档捞出来,把每个高管的年薪都念了出来。当时我后背都凉了——这要是真上线,整个公司的人事机密不就全漏了?
还有啊,别觉得检索增强生成能搞定所有场景。
比如你问它“我现在要给华东区的核心大客户写个定制化的年度合作方案,应该怎么搭框架”,这种需要创意整合、结合大量业务上下文的问题,就算你把所有的历史方案都检索回来,它写出来的东西也大概率是个四不像。毕竟检索回来的是零散的片段,要把这些片段揉成有逻辑、有针对性的内容,对大模型的整合能力要求极高,遇到复杂的创意场景,还是容易卡壳。
别不信。我见过太多了。
前几天和一个做AI创业的朋友喝酒,他说现在好多厂商吹自己的大模型多厉害,能解决企业的所有问题,实际上呢?大部分企业真正需要的,根本不是什么能写诗、能写代码的超级大模型,就是个能老老实实照着自己公司的文档回答问题,不会瞎编,不会漏权限的靠谱工具。
检索增强生成这东西,说穿了一点都不高大上。它没有那些动辄几百亿参数的模型听起来酷炫,甚至本质上就是个“高级点的搜索+大模型润色”的组合。
但就是这么个不酷炫的技术,现在成了多少企业落地AI的救命稻草。
别总想着搞那些花里胡哨的。把自己的知识库整理干净,把检索的逻辑做细,把权限的篱笆扎牢,比啥都强。
我当时脑子嗡的一声,拎着电脑包就往客户公司冲。等赶到的时候已经十一点半,会议室的白板上写满了投诉的记录——要么是把停售产品的参数当在售的讲,要么是把去年的渠道返点政策套到今年的代理商身上。
别再怪大模型笨,它只是没带“开卷考试的小抄”
很多人遇到大模型瞎编的问题,第一反应是“这模型不行,得换个更大的”。真不是。
你想啊,大模型的所有知识,都是在预训练阶段就刻在参数里的。就像你高中考完高考,把所有课本都卖了,脑子里只留了点模糊的记忆——你能记得三角函数的公式,但你绝对记不清高三下学期第三次模考的最后一道大题是怎么解的。这时候你硬让它闭卷答你们公司去年改了八版的报销制度、今年刚更新的渠道返点规则,它不瞎编才怪。
大模型闭卷推理与开卷检索对比示意图
检索增强生成说白了,就是给它把闭卷考试改成开卷。每次用户提问的时候,先从企业自己的知识库、产品文档、历史沟通记录里,把和问题强相关的内容全捞出来,塞到给大模型的提示词最前面,明明白白告诉它:你就照着这些材料答,材料里没有的就直接说不知道,别自己瞎发挥。
检索增强生成的核心从来不是让大模型变得更聪明,而是给它划好回答的边界,把最准确的实时信息递到它嘴边。
说实话,我刚接触这技术的时候,还觉得这路子是不是太“投机”了——不就是先搜一下,再让模型润色吗?直到那次客户的投诉事件之后,我才反应过来,那些砸进去几百万训专属大模型的企业,十有八九最后落地的效果,还不如把检索做扎实的检索增强生成系统。毕竟你再怎么调模型参数,等你们下个月新上了个产品,总不能停掉业务,花俩月重新训一遍模型吧?
你以为的检索是搜关键词,实际上差了十万八千里
我见过太多团队做检索增强生成,第一步就走歪了。
他们的所谓检索,就是搭个最基础的全文搜索框,用户输入“返点”,就把所有文档里带“返点”两个字的内容全捞出来,塞给大模型。结果呢?用户问“华东区今年三月签的代理商,满多少销售额能拿额外返点”,系统捞出来的全是去年华北区的返点政策,甚至还有十年前的老渠道规则,大模型照着念,不出错才怪。
企业知识库语义分块与向量检索流程图
真正好用的检索,根本不是匹配关键词。
首先得把所有的文档拆成适合阅读的语义块——不是按文件的页码硬拆,是按内容的逻辑拆。比如讲华东区2024年Q1返点政策的那一段,不管它在PDF的第几页,拆出来的时候就给它打上明确的标签:所属区域是华东,生效时间是2024年1-3月,内容类型是代理商政策,关联产品是全品类建材。
等用户提问的时候,系统不是去匹配“返点”“华东”这些字,是先理解用户提问的真实语义,再从所有的语义块里找相似度最高的内容,还要结合权限、时间这些条件自动过滤。比如你是华东区的销售提问,系统就自动把华北区、华南区的政策过滤掉,把去年过期的政策也过滤掉,只把最相关的两三个语义块捞出来,递给大模型。
上个月我们给一家做建材的客户搭系统,一开始他们的IT部门直接拿开源的全文检索接了大模型,测试的时候问“防水卷材的耐温等级”,系统直接把十年前停售的老产品手册里的-10℃参数捞出来给了用户。后来我们把所有产品手册按SKU拆成独立的语义块,给每个块加上“在售/停售”的标签,现在再问,系统自动把停售的老文档过滤掉,捞出来在售款的-30℃参数,准确率直接从之前的52%涨到了94%。
说真的,当时客户的技术负责人看完测试结果,眼睛都直了,说之前花了十几万找外包做的系统,连个能看的准确率都没到。不过话说回来,好多团队连第一步的文档分块都做不好,就想着靠大模型解决所有问题,最后摔得鼻青脸肿,也不奇怪。
别把检索增强生成吹成神,它的坑比你想的多得多
现在好多厂商吹检索增强生成,说这东西能解决大模型的所有问题,上了就万事大吉。真的太扯了。
我见过踩得最多的坑,就是知识库本身就没人维护。
你想啊,要是你们公司的知识库里面,挂着三个月前就过期的政策,放着已经停售半年的产品参数,就算你的检索系统做的再精准,捞出来的也是错的内容。大模型照着错的内容答,你怪谁?之前有个客户,知识库里面存了三个版本的报销制度:2022年的住宿标准是300一天,2023年是400,2024年刚改成500。结果检索的时候三个版本都被捞出来,大模型把三个版本揉了个答案,说住宿标准是800一天,最后全公司行政部加班改了三天,才把乱掉的回答纠正过来。
第二个坑,就是权限控制的缺失。
好多人觉得检索增强生成就是个内部工具,不用做权限过滤。我之前测一个开源的检索增强生成框架,没加权限控制的时候,普通员工问“公司去年的人力成本是多少”,系统直接把核心的薪酬核算文档捞出来,把每个高管的年薪都念了出来。当时我后背都凉了——这要是真上线,整个公司的人事机密不就全漏了?
还有啊,别觉得检索增强生成能搞定所有场景。
比如你问它“我现在要给华东区的核心大客户写个定制化的年度合作方案,应该怎么搭框架”,这种需要创意整合、结合大量业务上下文的问题,就算你把所有的历史方案都检索回来,它写出来的东西也大概率是个四不像。毕竟检索回来的是零散的片段,要把这些片段揉成有逻辑、有针对性的内容,对大模型的整合能力要求极高,遇到复杂的创意场景,还是容易卡壳。
别不信。我见过太多了。
前几天和一个做AI创业的朋友喝酒,他说现在好多厂商吹自己的大模型多厉害,能解决企业的所有问题,实际上呢?大部分企业真正需要的,根本不是什么能写诗、能写代码的超级大模型,就是个能老老实实照着自己公司的文档回答问题,不会瞎编,不会漏权限的靠谱工具。
检索增强生成这东西,说穿了一点都不高大上。它没有那些动辄几百亿参数的模型听起来酷炫,甚至本质上就是个“高级点的搜索+大模型润色”的组合。
但就是这么个不酷炫的技术,现在成了多少企业落地AI的救命稻草。
别总想着搞那些花里胡哨的。把自己的知识库整理干净,把检索的逻辑做细,把权限的篱笆扎牢,比啥都强。