大模型推理优化:跳出显存陷阱,那些被算错的成本账
上周在南京的行业交流会上,几位做推理引擎的工程师聊起一个刚踩过的坑:给客户部署的70B模型,一开始团队光盯着把模型量化到4bit塞进单卡A100,觉得方案天衣无缝。结果上线第一天就出现严重问题。并发上来之后,单请求延迟从200ms直接飙到3s,客户对上线效果非常不满。
真的,太多人对大模型推理优化的理解,还停留在“把模型塞进显存”的层面。
被显存占用掩盖的隐性成本
很多人第一次做推理部署的时候,拿着显存计算器对着模型参数表算来算去,把权重、KV缓存、临时缓冲的显存加起来,刚好卡着显卡的总显存容量定参数,连10%的冗余都不留。错了。
你算过显存碎片率吗?算过显存控制器的带宽利用率吗?算过每个算子单独启动的kernel开销吗?
就拿70B的模型举例,4bit量化之后权重占35GB,单卡80G的A100看起来剩了45G的空间,好像够支撑batch size到32的KV缓存。但实际部署的时候,因为显存分配的不连续,碎片率往往能到20%以上,真正能用来存KV缓存的空间可能只剩30G。更别说当显存占用超过90%的时候,显卡的内存访问效率会直接掉30%,哪怕你塞进去了,跑起来的速度也会慢得离谱。
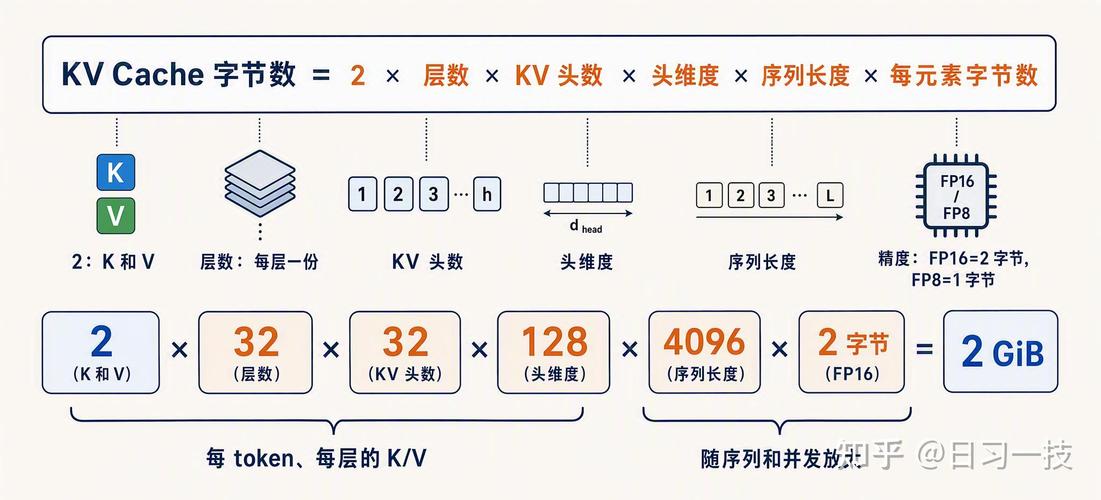 大模型推理显存占用构成实测对比图
很多人容易忽略的另一块成本,是kernel launch开销。此前我们见过某团队用原生PyTorch eager模式跑70B模型,没有做任何算子融合,每个小算子比如逐元素加、层归一化都要单独启动一次CUDA kernel。一次kernel launch在A100上的固定开销大概是10us,模型每一层有十几个这样的小算子,光启动kernel的时间就占了单token生成总延迟的40%。这种状态下,生成100个token需要2.8秒。用户发送请求后等待3秒才看到输出,体验远低于实时交互的基本要求。
这种性能问题并非模型本身的算力需求导致。只要把相邻的小算子融合成一个大的CUDA kernel,减少launch次数,同样的硬件上速度能直接翻一倍。但就这一步,很多人做部署的时候根本想不到,满脑子都是怎么把模型量化得更小。
动态batch不是万能解,错配的调度比不优化还糟
现在做推理优化的人,没人不知道连续批处理(continuous batching)的好处——把不同用户的请求动态拼到同一个batch里算,能把GPU的利用率从20%拉到80%以上,吞吐直接翻几倍。但太多人把这个技术用错了。
最常见的错法,就是为了凑够目标batch size,故意把请求在队列里等几十毫秒。比如把动态batch的等待阈值设成50ms,哪怕只来了一个请求,也要等50ms凑够数再一起算。单看GPU利用率确实好看了,但是对C端用户来说,本来200ms就能出第一个token,现在硬生生多等50ms,整体P99延迟直接涨了25%。
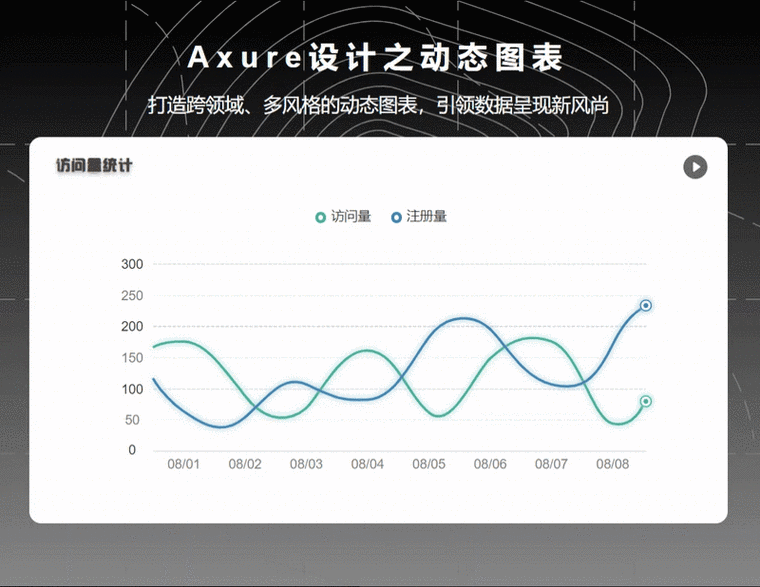 大模型推理动态batch调度延迟对比曲线图
这里根本没有通用的最优参数,全得对着业务场景调。如果是做离线批量处理,比如把几十万篇文档批量生成摘要,那把等待阈值设成100ms完全没问题,等的时间换回来的是吞吐的大幅提升,成本能降一半。但如果是面向C端的实时聊天场景,用户发完消息就盯着屏幕等回复,你让他多等哪怕30ms,感知都很强。此前我们为某AI客服团队做性能调优时,他们一开始把等待阈值设成了50ms,最大batch size拉到32,我们让团队把阈值降到5ms,最大batch size降到16,结果整体吞吐只掉了8%,但是P99延迟直接从1.2s降到了350ms,客户的满意度涨了快20%。
跟动态batch绑定的KV缓存管理,也是重灾区。很多人图省事,给每个进来的请求直接分一块固定大小的显存,不管用户的上下文是100token还是8000token,都按最长上下文的长度留空间。结果显存浪费得一塌糊涂,batch size根本上不去。现在行业里常用的分页式KV缓存,就是把KV缓存切成固定大小的块,需要的时候再申请,跟操作系统的虚拟内存分页逻辑差不多。但这里也没有万能参数:块切得太小,比如32token一块,地址映射的开销会上来;块切得太大,比如1024token一块,显存碎片又会变多。得对着自己平台的用户请求长度分布测——如果用户平均上下文是200token,64token一块就够;如果是做长文档处理,平均上下文32k,256token一块的效率更高。
别为了极致压缩,把模型的能力丢了
现在的量化技术已经卷到很离谱的程度了,从FP16到INT8,再到4bit、2bit,甚至1.58bit的三值量化,好像bit数越低,技术越先进。但很少有人提量化的精度边界。
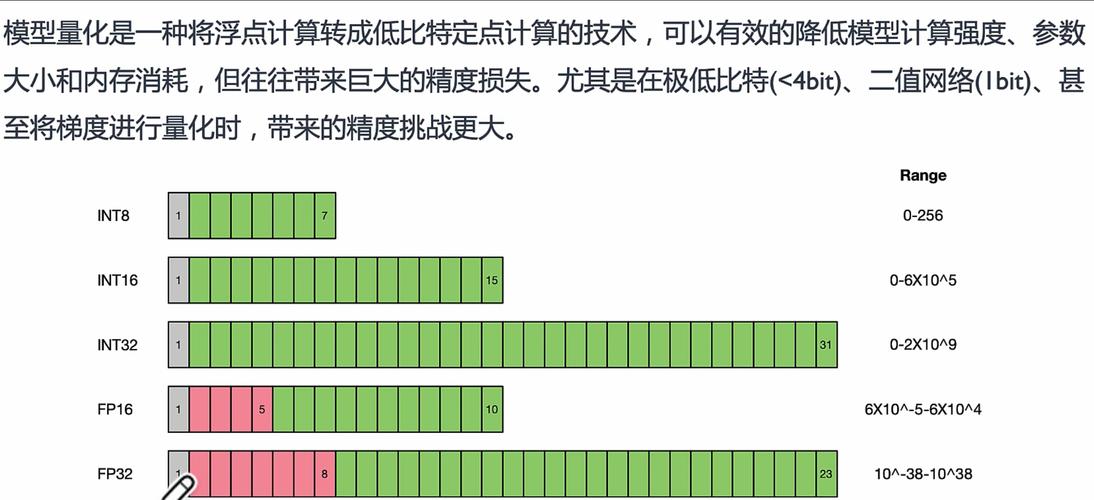 不同量化精度下大模型代码生成任务精度损失实测图
之前接触过一个团队,把一个代码大模型硬压到2bit,算出来的显存占用确实低,单卡能跑batch size到64。结果上线之后发现,本来FP16版本能正确生成带异常处理的Python函数,量化之后生成的代码满是语法错误,客户用了两天就全部回滚到FP16版本,之前花两周做的优化全白费。
这就是典型的为了优化而优化。量化的精度损失是有阈值的:对于通用聊天场景,4bit量化的整体感知损失大概在1%以内,用户基本察觉不到;但对于代码生成、数学推理这类对精度敏感的场景,4bit量化的损失可能就到5%以上,要是硬上2bit,损失能到20%。你省下来的那点显存成本,根本抵不上用户因为结果错而产生的流失。
其他的热门技术也是一样的适用边界。比如投机采样,用一个小模型提前猜大模型的输出token,猜对了就直接跳过计算,命中率高的时候确实能把速度提两三倍。但如果小模型跟大模型的能力差太多,命中率掉到30%以下,那验证猜测的额外开销反而会让速度变慢。再比如稀疏注意力,对于4k以下的短文本,计算开销的优势根本体现不出来,只有当上下文长度超过8k的时候,稀疏注意力的收益才会盖过实现的复杂度成本。花几个月时间把模型改成稀疏结构,结果跑短文本的时候速度跟原来的稠密版本差不多,投入的开发成本完全无法覆盖实际收益。
很多人现在聊推理优化,张口就是谁的吞吐高,谁的延迟低,谁用的技术新。但很少有人回头问一句,你做的这些优化,到底是解决了什么实际问题?
是把边缘端的模型跑起来了?是把C端用户的等待时间降下来了?还是把离线处理的成本打下来了?
没有放之四海而皆准的优化方案。所有的参数、所有的技术,都得对着具体的业务场景调。毕竟,能让用户觉得好用的优化,才是真的优化。