别再吹"算力堆料"了,真正好用的高效能计算平台,其实是在给科研人省命
上次跟做蛋白质结构预测的师弟在食堂拼桌吃饭,他扒拉着餐盘里的青菜,脸垮的像被霜打了。
他吐槽说之前组里攒的那套所谓算力集群,跑个AlphaFold3的推理,卡了整整14个小时,中间还因为节点调度崩了,前功尽弃。他在实验室蹲到凌晨三点,最后在楼梯间啃冷包子的时候,差点哭出来。
冷包子咬开的时候,馅都结了油渣。
他算的那个跨膜蛋白结构,本来要赶下个月的冷冻电镜样本质控节点,就因为集群上谁占了满卡跑无关的小任务,排队排了三天才轮到,结果跑一半调度系统跳了个错,所有存在本地缓存的中间文件全没了。
全白搭。
很多人对高效能计算平台的误解,从"买最贵的卡"就开始错了
我之前跟不少做算力建设的人聊过,发现大家对高效能计算平台的认知,还停留在"算力堆料"的阶段。总觉得只要把最贵的GPU买回来,往机柜里一插,就算建成了。去年某西部985投了两千万建的算力中心,刚上线的时候开了盛大的发布会,报的总峰值算力能排进全国高校前十,结果真用了半年,运维团队自己报的数据是平均卡利用率不到22%。
不是卡不好。是调度太烂了。
之前的调度逻辑特别简单,谁提交的早谁先上,不管你任务多大,不管你占多少资源,一占就是一整张卡。我见过一个研一的学生,写了个脚本跑文献计量分析,总共只需要1G显存,结果直接占了一整张A100,从早上跑到晚上,剩下的78G显存全空着,后面排了一堆要跑大模型的任务,急的直跳脚。还有的节点之间连的是普通以太网,跑跨节点的大模型训练,数据传半天,GPU在那空转等数据,电都交了,算力一点没出。
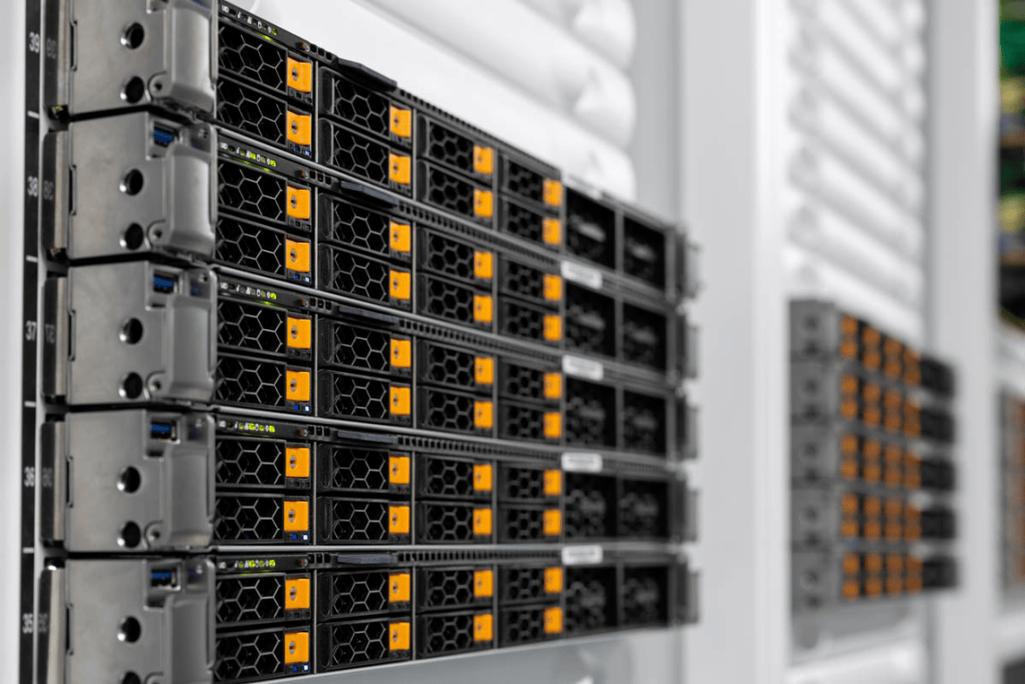 高校科研机房GPU集群节点实拍
去年我去参观某生物信息研究所的高效能计算平台,人家根本没追着买最新的H100,反而把一半的预算花在了看不见的地方。
第一块是搭了智能调度层,能自动把不同大小的任务拆碎了,拼到同一张卡上跑,不会让1G显存的任务占满一整张80G的卡;第二块是搭了存算分离的架构,所有任务的中间文件都存在并行存储上,就算节点崩了,系统直接从断点续跑,不用从头再来。当时跟他们的运维工程师聊天,人家说之前最头疼的事,就是学生提工单说"我的任务崩了",查半天发现是任务写的时候没做容错,跑了10个小时的结果没存,现在平台层面把这个兜底了,平均每个科研人员每周能省出至少12个小时的无效等待时间。
12个小时是什么概念?够你把一周的实验记录写完,够你陪家里人吃三顿晚饭,够你不用在实验室熬到凌晨两点等任务跑完。
高效能计算平台最值钱的能力,从来不是"跑的快",而是"不添乱"
说实话,我之前对高效能计算平台的期待也很低,只要能比自己电脑跑的快就行。直到我见过太多科研人在算力上踩的坑,才反应过来——大家要的根本不是"快到飞起来"的算力,是"不添乱"的平台。
之前做气候模拟的朋友跟我吐槽,他们之前用通用的云平台跑百年尺度的气候情景模拟,得先自己搭环境,装一堆依赖,跟平台的内核版本不兼容,调环境调了三天,跑了四个小时,结果因为平台的存储配额不够,中间结果存到一半满了,整个任务直接终止。那种崩溃感,做过科研的都懂。
现在真正好用的高效能计算平台,根本不会把这些破事甩给用户。针对不同的科研场景做了预置镜像,你要跑分子动力学,要跑大模型微调,要做地震波反演,直接点一下就能拉起来环境,不用自己调依赖;存储是按任务动态分配配额,不会跑一半给你弹个"磁盘不足"的提示;甚至会在你提交任务之前,自动检测你写的脚本里有没有可能导致崩溃的问题——比如有没有写对文件路径,有没有设置超时自动重启,有没有把中间文件存在本地节点上。
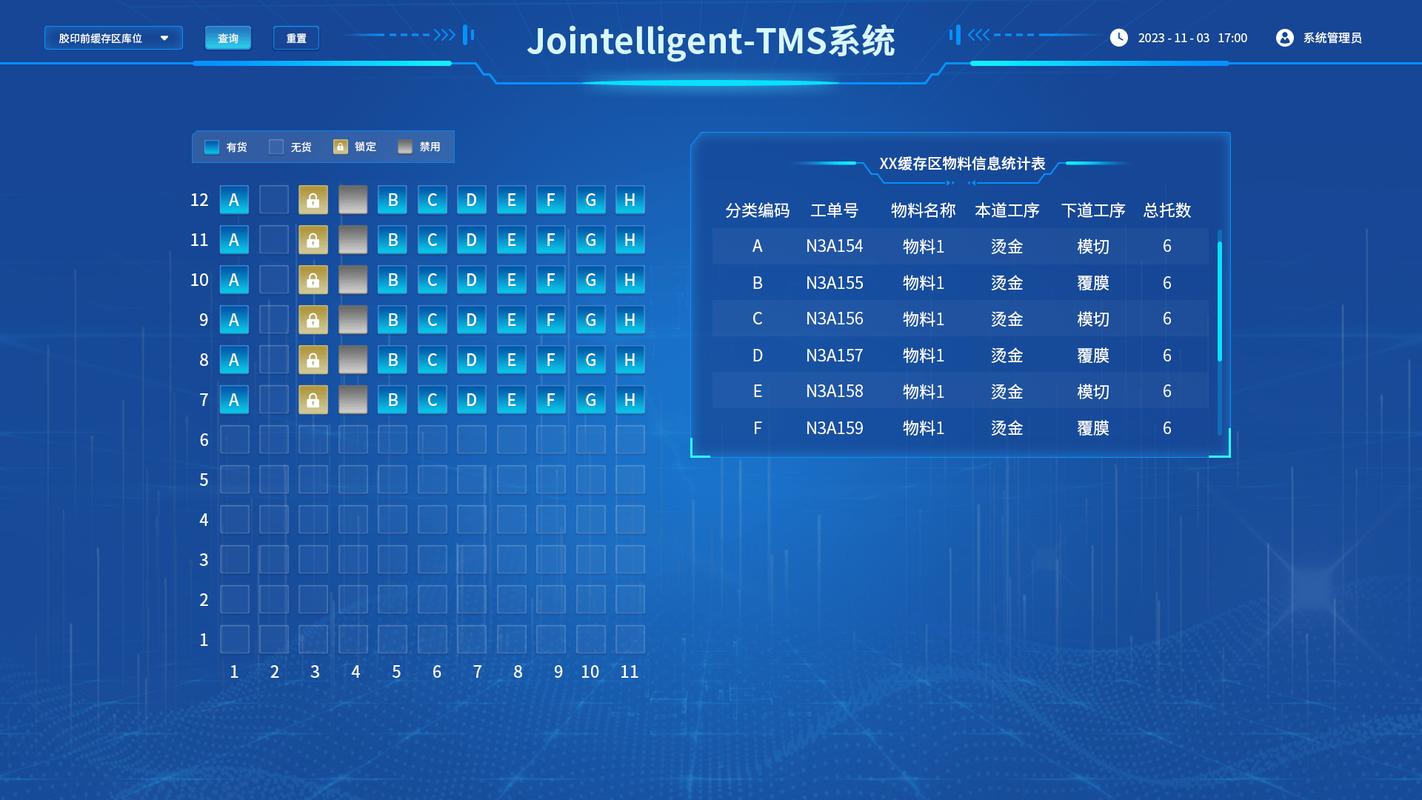 高效能计算平台任务调度界面可视化截图
说真的,我见过太多科研人,花在跟平台斗智斗勇的时间,比真正做科研的时间还多。调环境调一周,跑任务跑俩小时,这叫什么高效能?纯纯的内耗。
上个月跟做可控核聚变模拟的团队吃饭,他们换了新的高效能计算平台之后,最直观的感受根本不是"原来跑3天的模拟现在3小时就跑完了"——当然速度确实提了,但最让他们惊喜的是,平台能自动识别不同模拟任务的通信需求,把跨节点通信量大的任务,自动调度到带高速InfiniBand互联的节点池里,那些通信量小的小任务,就放到普通的节点上,不占高速网络的资源。之前他们跑等离子体模拟,经常因为网络拥塞,任务跑一半通信超时,现在这种问题的发生率降到了0.1%以下。
他们的首席科学家说,之前算一次等离子体不稳定性的演化,要花一周时间排期,跑24小时,现在从提交任务到拿到结果,总共不超过4个小时。等于之前一个月能做1次的模拟实验,现在一周就能做3次,科研进度直接翻了好几倍。
这才是真的提效。
别等着平台完美了再用,高效能计算平台从来不是"交钥匙"的工程
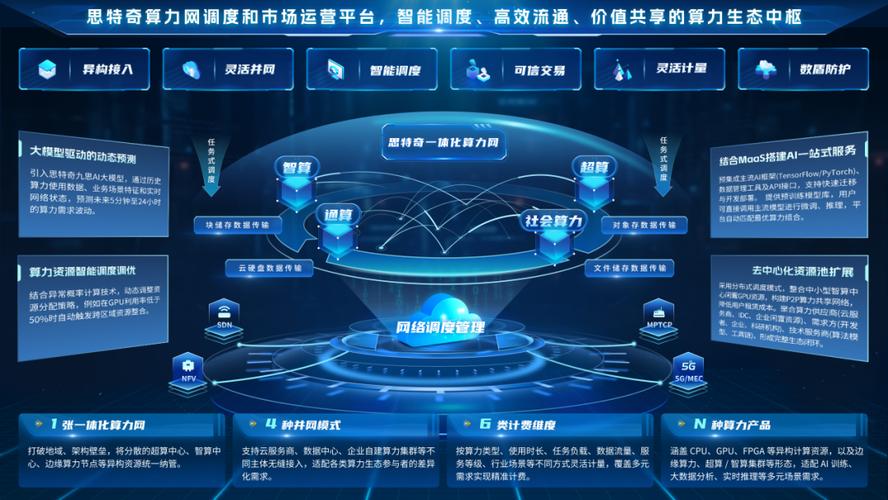 别等着平台完美了再用,高效能计算平台从来不是"交钥匙"的工程
我见过太多单位建高效能计算平台的误区,总想着一步到位,买最好的硬件,找最贵的集成商,做个看起来特别fancy的控制台,结果上线之后发现根本不符合科研人员的使用习惯。比如有的平台要求所有任务必须通过网页端提交,不能用命令行,搞的那些天天跟Linux打交道的科研人特别难受,本来敲个三行命令就能提交的任务,要点十几下鼠标,填一堆没用的表单。还有的管理员为了防止学生乱装软件,把所有的sudo权限都收了,连个python的依赖包都装不了,最后学生只能把所有的代码都塞在自己的用户目录下,运行的时候加一堆环境变量,折腾的人满头汗。
现在做的好的高效能计算平台,根本不是集成商交付完就完事的。人家有专门的运维团队,每周跟不同课题组的人开半小时的会,收集大家的吐槽。比如做量子计算模拟的人说,我需要特定版本的编译器,平台就花两天时间把环境配好;做深度学习的学生说,我希望能在提交任务的时候自动关联我的代码仓库,平台就花一周时间把Git的集成做上;甚至有人说,我跑任务的时候希望能收到微信提醒,不用一直盯着网页看,平台就给加个通知的小功能。
说实话,我最烦那种把高效能计算平台吹成"万能神器"的宣传,好像只要上了这个平台,所有科研难题都能迎刃而解。根本不是。它就是个工具。跟你实验室里的移液器、离心机没区别——好用的工具,就是能帮你把那些无意义的杂事都挡在外面,让你把精力真的放在你要解决的科学问题上,而不是天天跟破系统较劲。
现在国内的高效能计算平台,其实已经过了比峰值算力的阶段了。之前大家比的是我买了多少卡,总共有多少PFLOPS,能拿出去宣传就行;现在大家比的是硬件利用率,是对不同科研场景的适配度,是能不能真的让科研人少踩坑。之前看到一组行业数据,国内现在上线的面向科研的高效能计算平台,平均硬件利用率已经从三年前的不到20%,涨到了现在的45%。看起来好像不算高,但要知道,之前很多平台的利用率连10%都不到——一堆昂贵的GPU在机柜里吃灰,电交了,机房租金付了,就是没给科研产出做贡献。
上次跟那个蹲在楼梯间啃冷包子的师弟聊天,他现在换了新的高效能计算平台,上次跑那个跨膜蛋白的结构,从提交任务到拿到完整的结构文件,总共花了3个小时,中间系统自动给续了两次断点,根本没崩。
他说那天他没在实验室熬夜,六点就下班了,去校门口的馆子吃了一碗热乎的牛肉面,加了俩煎蛋。
你看,这才是高效能计算平台该有的样子。