别把神经形态计算当科幻:这颗指甲盖大的芯片已经在啃传统算力的饭碗了
上周去中关村参加那个小范围的算力闭门会,我刚坐下就被邻座搞芯片的哥们塞了块指甲盖大的芯片——不是新出的消费级CPU,是英特尔Loihi 2神经形态芯片的工程样片。我当时第一反应是:这玩意儿居然不是实验室里落灰的展品?
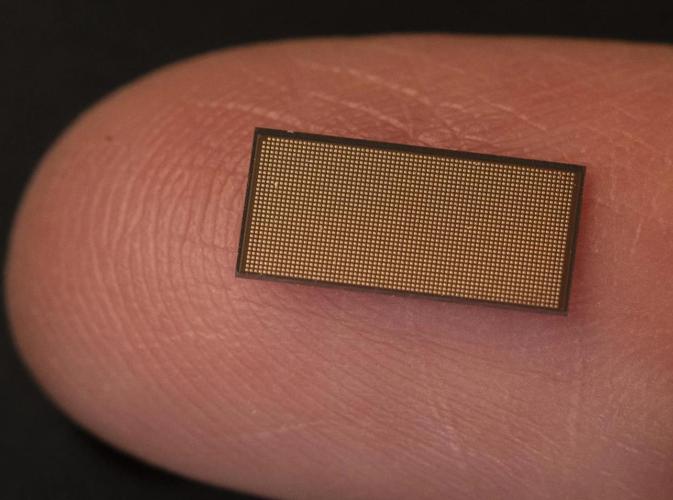 英特尔Loihi 2神经形态芯片实物对比图
你敢信?
我上次用笔记本跑个本地的7B参数大模型,半小时风扇转得像要起飞,摸起来壳子温热能煎鸡蛋。这玩意儿满负荷跑,摸上去只有一点点温度,连个主动散热的风扇都不用装。
真的离谱。
之前大家总觉得仿人脑的计算架构是学术圈自嗨的老路,毕竟从1980年加州理工的Carver Mead第一次提出神经形态这个概念,到现在快40年了,大部分成果都停留在论文里,离能落地的产品差着十万八千里。没人想到,现在的芯片已经把功耗压到了这个水平——靠的就是和传统冯诺依曼架构完全反过来的思路:脉冲触发、事件驱动,没有冗余的搬运,没有固定频率的无效计算,只有当外界输入的信号真的产生变化的时候,芯片才会被唤醒开始算。
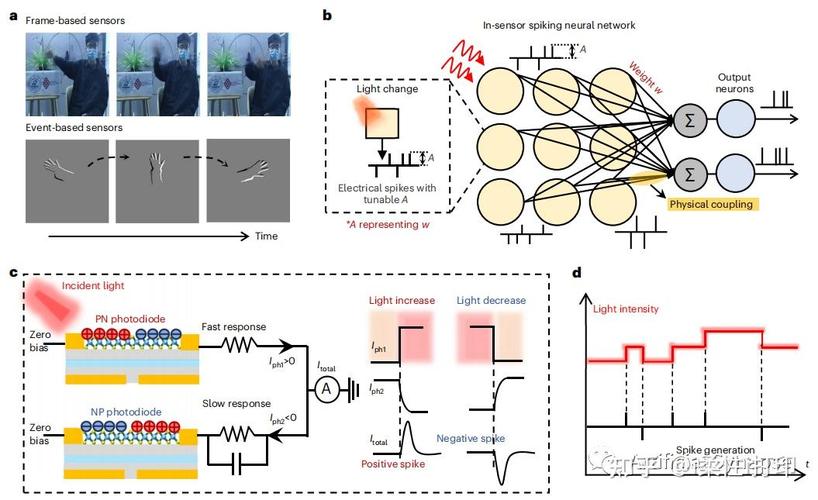 神经形态芯片事件驱动视觉检测示意图
为啥效果这么好?因为传统的视觉系统是按固定频率拍照片,不管画面里有没有变化,都要把整帧的像素数据从传感器搬到计算单元,再挨个算一遍。光搬数据的能耗,就比实际做检测的计算高两个数量级。神经形态的视觉系统不一样,每个像素是独立触发的,只有当某个位置的亮度变化超过阈值,才会发个脉冲信号给芯片,没变化的地方直接当背景忽略。
现在特斯拉的车载事件相机,背后配套的就是这类神经形态处理芯片。雨雾天里跑高速,传统的视觉系统要逐帧算静态图像,等算完前面的障碍物距离,车都快贴上去了;神经形态的系统能直接捕捉到动态目标的运动轨迹,延迟压到毫秒级,反应速度比人眼还快。
 离普通人能用,还差最后那层窗户纸
当然,现在的神经形态计算离大规模民用,还远没到吹得天花乱坠的程度。
最大的坎是软件生态。
我上次试着给Loihi 2写了个简单的声音识别程序,折腾了整整三天,才让它能准确识别“开门”“关门”两个词的指令——换作普通的8位单片机,我可能半小时就搞定了。现在的神经形态芯片不支持CUDA,不支持常规的Python机器学习框架,你要跑个应用,得从头写脉冲神经网络的仿真代码,门槛高到能把90%的普通开发者挡在门外。
不过话说回来,这个门槛正在快速降下来。2025年年初英特尔刚更新的Loihi 2软件工具包,已经能把常用的卷积神经网络模型自动转换成脉冲神经网络的格式,不用程序员从零开始搭模型。国内的进展也不慢,清华类脑计算中心的“天机芯”已经迭代到第三代,专门针对物联网边缘端场景做优化,单芯片的成本已经压到了和普通工业MCU差不多的水平。
上周散会的时候,邻座那哥们跟我说,再过个三五年,你家里的智能门锁、烟雾报警器、智能音箱,里面的核心芯片说不定都是神经形态架构的——不用频繁换电池,反应比现在快好几倍,你说句话它马上就响应,不会像现在的智能音箱那样,喊半天没反应。
我当时没接话。
但手里攥着那块温温的小芯片,突然就觉得,之前总觉得未来的算力革命是堆更多的机柜、拉更粗的电缆、耗更多的电,现在才发现,原来真正的变革,是从模仿我们自己大脑的工作方式开始的。
毕竟我们的大脑,满负荷跑的时候功耗才20瓦,比你家的卧室灯泡还低。
这事儿,细想真的挺吓人的。
别拿它当“仿人脑噱头”,真省能省到离谱
我之前对神经形态计算的印象,还停留在十几年前杂志上的科幻配图:一个像人脑的透明容器,插满线路,旁边配着“未来算力新方向”的标题,看完就忘。 直到那次拿到样片,哥们给我算了笔账。 2024年《自然·机器智能》上发过一组对照实验:用128块Loihi 2组成的阵列跑动态视觉目标追踪任务,匹配同精度、同延迟下的GPU方案,总功耗差了800多倍。英特尔Loihi 2神经形态芯片实物对比图
你敢信?
我上次用笔记本跑个本地的7B参数大模型,半小时风扇转得像要起飞,摸起来壳子温热能煎鸡蛋。这玩意儿满负荷跑,摸上去只有一点点温度,连个主动散热的风扇都不用装。
真的离谱。
之前大家总觉得仿人脑的计算架构是学术圈自嗨的老路,毕竟从1980年加州理工的Carver Mead第一次提出神经形态这个概念,到现在快40年了,大部分成果都停留在论文里,离能落地的产品差着十万八千里。没人想到,现在的芯片已经把功耗压到了这个水平——靠的就是和传统冯诺依曼架构完全反过来的思路:脉冲触发、事件驱动,没有冗余的搬运,没有固定频率的无效计算,只有当外界输入的信号真的产生变化的时候,芯片才会被唤醒开始算。
现在的落地场景,根本不是你想的“跑大模型”
每次我跟人提神经形态计算,十个人有八个会追着问:这玩意儿什么时候能取代GPU跑大模型? 我每次都得翻个白眼。 真不是。 现在的神经形态芯片,根本不是冲着堆算力跑大模型去的。它的优势场景,全是那些传统算力解决起来特别费劲的边缘端场景。 说个我去年踩过的坑。之前给一个锂电池生产线上的质检项目做方案选型,一开始选了常规的GPU视觉盒子,装上去才发现问题:车间里的光线稍微晃一下,检测系统就误报个不停,24小时开机的功耗快赶上车间里一台小型风机的耗电量,一年的电费都快赶上设备采购价了。后来换了基于神经形态芯片的检测模块,误报率直接降了90%,待机的时候功耗只有毫瓦级,连单独的供电线都不用拉,直接从生产线的传感器上取电就够。神经形态芯片事件驱动视觉检测示意图
为啥效果这么好?因为传统的视觉系统是按固定频率拍照片,不管画面里有没有变化,都要把整帧的像素数据从传感器搬到计算单元,再挨个算一遍。光搬数据的能耗,就比实际做检测的计算高两个数量级。神经形态的视觉系统不一样,每个像素是独立触发的,只有当某个位置的亮度变化超过阈值,才会发个脉冲信号给芯片,没变化的地方直接当背景忽略。
现在特斯拉的车载事件相机,背后配套的就是这类神经形态处理芯片。雨雾天里跑高速,传统的视觉系统要逐帧算静态图像,等算完前面的障碍物距离,车都快贴上去了;神经形态的系统能直接捕捉到动态目标的运动轨迹,延迟压到毫秒级,反应速度比人眼还快。
离普通人能用,还差最后那层窗户纸
离普通人能用,还差最后那层窗户纸
当然,现在的神经形态计算离大规模民用,还远没到吹得天花乱坠的程度。
最大的坎是软件生态。
我上次试着给Loihi 2写了个简单的声音识别程序,折腾了整整三天,才让它能准确识别“开门”“关门”两个词的指令——换作普通的8位单片机,我可能半小时就搞定了。现在的神经形态芯片不支持CUDA,不支持常规的Python机器学习框架,你要跑个应用,得从头写脉冲神经网络的仿真代码,门槛高到能把90%的普通开发者挡在门外。
不过话说回来,这个门槛正在快速降下来。2025年年初英特尔刚更新的Loihi 2软件工具包,已经能把常用的卷积神经网络模型自动转换成脉冲神经网络的格式,不用程序员从零开始搭模型。国内的进展也不慢,清华类脑计算中心的“天机芯”已经迭代到第三代,专门针对物联网边缘端场景做优化,单芯片的成本已经压到了和普通工业MCU差不多的水平。
上周散会的时候,邻座那哥们跟我说,再过个三五年,你家里的智能门锁、烟雾报警器、智能音箱,里面的核心芯片说不定都是神经形态架构的——不用频繁换电池,反应比现在快好几倍,你说句话它马上就响应,不会像现在的智能音箱那样,喊半天没反应。
我当时没接话。
但手里攥着那块温温的小芯片,突然就觉得,之前总觉得未来的算力革命是堆更多的机柜、拉更粗的电缆、耗更多的电,现在才发现,原来真正的变革,是从模仿我们自己大脑的工作方式开始的。
毕竟我们的大脑,满负荷跑的时候功耗才20瓦,比你家的卧室灯泡还低。
这事儿,细想真的挺吓人的。