别再等硅基芯片挤牙膏了,光学计算技术真的能把算力‘亮’出来?
去年9月23号,我在南京栖霞山边上的产学研实验室熬到三点。服务器风扇转得像要把天花板掀了,我攥着便利店刚买的冰美式,盯着屏幕上跑了47秒还没出结果的大模型注意力层矩阵运算,差点把键盘砸了。旁边坐了一下午的导师突然扔过来个巴掌大的黑盒子,壳子上还留着烙铁烫的印子。“插上去试试。”
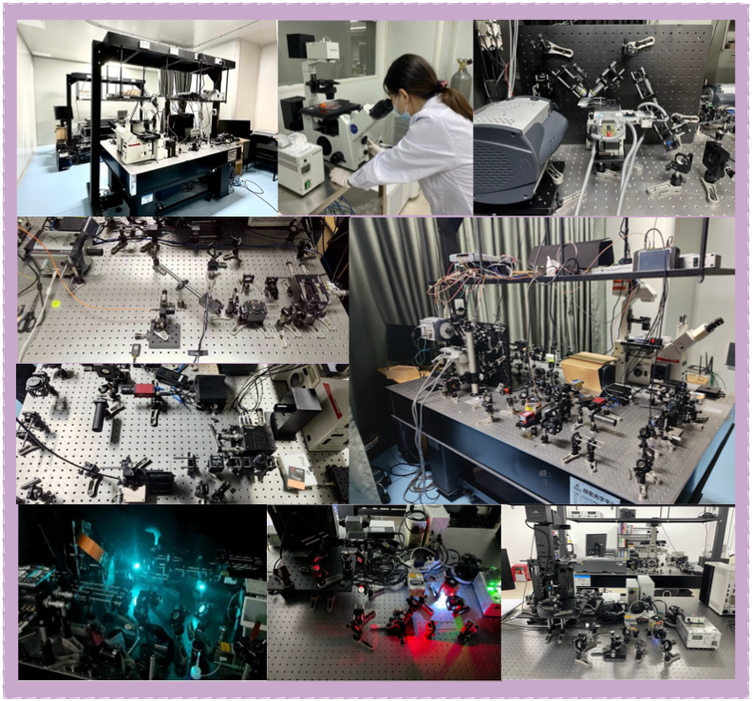 南京产学研实验室光学计算原型板实测场景
我半信半疑把黑盒子接在服务器的PCIe口上,重新跑了一遍同样的运算。0.08秒。结果直接弹了出来。
我当时懵了。咖啡洒在工装裤上都没察觉。
硅基芯片的墙,我去年在南京实验室撞了个正着
之前总听人说硅基芯片要摸到物理墙了,我没什么实感。直到那天跑的矩阵运算,是个4096乘4096的浮点矩阵乘加,用的是当时最顶级的GPU,功耗拉到了700瓦,风扇转得耳朵疼,结果还不如这个巴掌大的黑盒子跑得快。
说穿了,现在硅基芯片的算力瓶颈,根本不是晶体管密度不够,是数据搬不动。你想啊,矩阵运算要把几十亿个数字从内存搬到计算单元,再把结果搬回去,光这个搬运过程耗的电,就占了总功耗的90%。真正用来算数的电,还不到10%。就像你要算个账,大部分时间都在翻抽屉找账本,真正提笔算的时间没多少。
现在的光学计算定位是协处理器,而非通用计算芯片。它根本不跟CPU、GPU抢通用计算的饭碗,就是专门啃矩阵乘加这块硬骨头的。只要是大模型推理、图像识别、信号处理这类需要大量矩阵运算的场景,把这些任务甩给它,剩下的逻辑运算还是交给原来的硅基芯片就行。
光怎么算矩阵?说穿了就是拿透镜当“乘法器”
很多人第一次听光学计算,以为是拿光在芯片里跑逻辑门,跟原来的硅基芯片换个载流子而已。完全不是。
它的原理说穿了特别朴素。矩阵乘加运算是什么?就是一堆数乘上对应的系数,再加起来对吧?光学计算用的就是这个逻辑:把输入的数字转成不同亮度的光,射到一个定制的透镜阵列上。每个透镜的折射率是预先调好的,光穿过去的时候,亮度就会被乘以对应的系数——这不就是完成了乘法吗?然后后面放一排光电探测器,把所有穿过来的光的亮度加起来,就是最终的结果。整个过程没有任何电信号的来回搬运,光在波导或者空气里跑的速度就是光速,能不快吗?
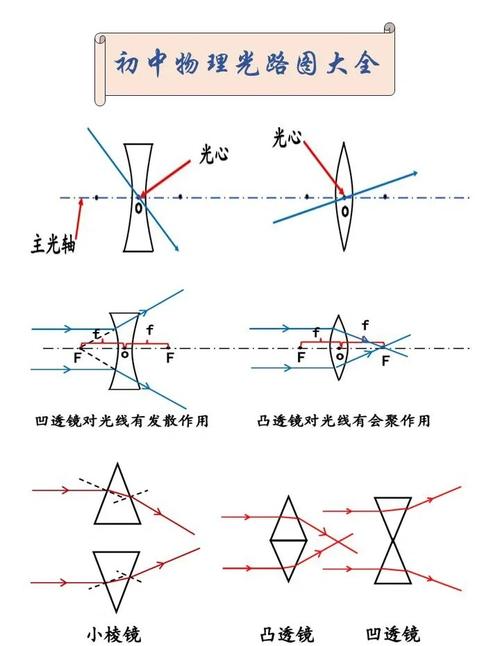 光学矩阵运算透镜阵列工作原理示意图
我第一次听导师讲这个原理的时候,第一反应是这也太简单了?像高中物理实验。但就是这个看起来像高中实验的东西,矩阵乘加运算的能效比是硅基GPU的10到100倍。原来跑一次要耗700瓦的运算,用光学模块只要3瓦。相当于你开个空调的电,现在换成个小台灯就够了。
别吹得太神,它现在连个简单加减法都算不利索
说实话,我刚接触这东西的时候,也觉得是个能颠覆行业的黑科技。直到后来跟着做了三个月的精度测试,才知道它的边界有多明显。
你要让它算个1+1,或者判断个数字是不是大于10?不行。因为光的衰减很难控制得特别精准,差个零点几纳米的透镜加工误差,或者实验室温度变个两三度,算出来的结果就会飘。比如你输入个1,它可能给你输出1.0002,这种误差对于需要精确逻辑判断的场景,比如跑操作系统、数据库事务,完全是灾难。
我们现在做的原型板,只能处理8位到16位的浮点运算,刚好够大模型推理的精度要求,要是你想拿它跑个高精度的科学计算,比如模拟天体运行,那误差大到能把行星轨道算飞了。
还有更现实的问题。现在的透镜阵列加工良率特别低,一片晶圆上能出3个合格的模块就不错了,成本是同算力硅基芯片的五六倍。要是你把它装在手机里,摔一下,透镜稍微歪个微米级的角度,整个计算结果就全错了。现在根本没法往消费电子里装。
不过话说回来,这东西也不是完全没用。去年我们跟南京的一家自动驾驶公司合作,把光学模块装在他们的测试车上,跑BEV感知的矩阵运算,原来的车载芯片跑一次要12毫秒,装了之后只要3毫秒,功耗还砍了三分之二。现在他们已经在做下一轮的原型验证了,只是因为良率太低,还没敢往量产车上装。
上周我回那个实验室,导师的新原型板已经做到指甲盖大小了,用的是集成波导,不是原来那种裸露的透镜阵列。我拿着那个小薄片看了半天,想到三年前大家还在愁硅基芯片挤牙膏挤不动,现在光已经摸到算力的门槛了。
不急。总会来的。