别再吹隐私计算了:联邦学习技术真能解决医院跨院调数据的糟心事?
上周三在南京珠江路的咖啡馆等客户。
对面坐的是鼓楼医院信息科的张工,攥着半杯冰美式,说这两年为了攒肺癌随访的数据集,跑了不下10家兄弟医院,每次刚把需求递过去,对方信息安全岗的人就直接把邮件打回来——不是不信任,是这几年个人信息保护的要求卡得太死,哪怕是去标识化的病历,跨院传出去万一漏了,谁都担不起那个责任。
我听着他吐槽,手里的冰美式化了半杯。
这不就是当年我帮甲方踩了无数坑的那个场景?
当年为了凑数据集,我帮甲方踩过的坑
最早做医疗AI项目的时候,我们团队想训一个能早期识别肺结节的模型,一开始想的很简单——把合作医院的CT影像都导到我们的中心服务器,标完注就开训。结果跑了三个月,模型在我们合作的那家医院测精度能到92%,拿到隔壁市的医院一测,直接掉到61%。
为什么?因为不同医院的CT机参数不一样,拍出来的影像层厚、灰度值差得能有十万八千里。更麻烦的是,等我们想找更多医院补数据的时候,全被打回来。没人敢把患者的原始数据往外传。
那时候我们就想,能不能有个办法,大家不用把数据拿出来,还能一起把模型训好?
后来接触到联邦学习技术才反应过来——这不就是我们找了半天的解决方案?
说白了逻辑特别简单。你医院有100个确诊肺癌患者的CT特征,省人医有另外200个,市第一医院有300个。以前要凑一起训模型,得把所有数据拷到一个中心节点。现在呢,每个院在自己的本地服务器上,用自己手里的数据算一轮模型更新的方向(行话叫梯度),把这个方向用同态加密加了密,传到一个聚合服务器上,大家把所有加密的方向拼到一起,调整出一个通用的模型参数,再把更新后的参数发回给每个院。
整个过程,原始数据从来不出本地。
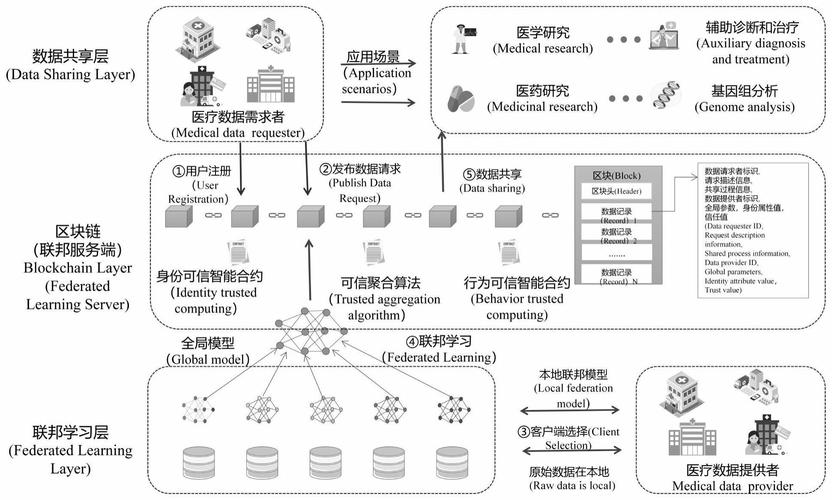 联邦学习跨医院数据协同流程示意图
我第一次把这个逻辑给张工讲完的时候,他眼睛都亮了。说合着我们之前费那么大劲跟各个院磨合规流程,原来根本不用传数据?
对,理论上是这样。
别被厂商吹上天,这技术落地哪有那么顺
理想很丰满,现实全是坑。
我们去年接了个跨三家医院的联邦学习项目,一开始拍胸脯说三个月就能出能达到临床要求的模型,结果硬生生拖了八个月。
第一个坑就是数据异构。就像之前说的,每家医院的CT机品牌不一样,影像的标注规则不一样,甚至连患者随访的记录格式都不一样。联邦学习本身只负责传加密的梯度,根本不会帮你把各家的数据对齐。我们当时派了两个工程师,天天泡在各个医院的影像科机房,调影像灰度值的映射表,统一标注的规则,光前置的数据预处理就花了三个多月。
第二个坑是梯度的通信成本。三家院的影像数据量加起来有2个T,每一轮模型训练要传的梯度数据有好几个G,一开始我们用普通的云专线传,每次传完都要等半个多小时,一轮训练下来光传数据的时间就占了40%。后来不得不专门拉了点对点的加密专线,成本又涨了一大截。
还有最容易被忽略的精度损失。因为我们为了防梯度泄露,给每个传出去的梯度加了差分隐私的噪声,最后测出来的模型精度,比集中式训练的结果低了11个百分点。就这,还是我们调了十几次噪声参数调出来的最优结果。
那段时间我天天在各个医院之间跑,从鼓楼到仙林,再到江宁,地铁坐的腿都肿,回新街口的时候拐去南京大排档喝一碗美龄粥,累的连粥的甜味都尝不出来。
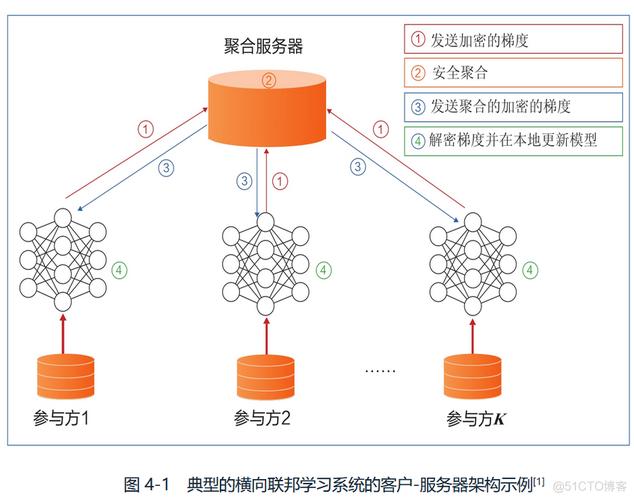 横向联邦学习梯度加密传输架构图
不过话说回来,就算坑这么多,这技术也是真的解决了之前解决不了的问题。之前大家想跨院做科研,要么靠人情换数据,要么就冒着合规的风险传出去,现在有了联邦学习,至少从流程上把合规的坎迈过去了。
真正的应用边界,从来不是什么“隐私万能药”
现在很多厂商吹联邦学习技术,说这是能解决所有数据隐私问题的万能药,我每次听到都想笑。
上次跟某金融机构的科技负责人聊天,对方说他们上了联邦学习之后,跨两个分行做反欺诈模型,精度比之前单独做高了20%。我问他,那你们有没有测过梯度泄露的风险?对方愣了一下,说他们安全团队测过,说加密之后没人能破解。
我给他看了去年一篇顶会的论文——有团队做了实验,哪怕是加了同态加密的梯度,只要攻击者拿到足够多轮次的梯度值,就能反推出一部分原始的用户手机号、消费记录。不是百分百能破解,但只要有泄露的可能,在金融场景就是天大的风险。
还有更现实的边界。比如你想做罕见病的模型,每个医院手里可能就三五例确诊病例,就算把全省所有医院的病例凑起来,加起来也就几十例,样本量根本达不到训练模型的要求,就算你用联邦学习把所有数据的价值都挖出来,也训不出来能用的模型。
我之前见过一个项目,某区域的零售品牌想跟银行合作做用户画像,两边上了联邦学习,花了快两百万,最后发现,品牌的用户标签和银行的用户标签重合度不到10%,传了半天梯度,模型的提升还不如他们自己在本地调参的效果好。
说白了,联邦学习技术从来不是什么放之四海而皆准的技术。它适合的场景,是多个参与方手里有同类型、同格式的数据,大家有共同的模型训练需求,又因为合规要求不能把原始数据拿出来的情况。
要是数据本身就不对齐,样本量不够,那就算把加密技术吹得再神,最后也只是花了冤枉钱。
没人敢拍胸脯说这技术未来能解决所有问题。
但至少现在,它给了我们一个不用在合规和技术效果之间二选一的选项。