边缘智能技术:跳出云端算力陷阱的落地路径
去年在苏州相城的汽车零部件车间蹲点时,见过他们最初的检测方案:把所有产线工业相机采集的图像,通过厂区5G专网传到一公里外的边缘数据中心跑缺陷检测模型。算下来单条产线上行带宽要占100Mbps,光网络建设成本就摊了十几万。遇到网络波动,推理任务排队时,延迟能冲到500毫秒以上。
漏检率压到1.2%就再也上不去了。
后来换了本地网关部署的推理方案,延迟直接降到17毫秒,漏检率掉到0.1%。没有什么黑科技,就是把之前全靠远端的任务,拆成了本地能处理的部分。
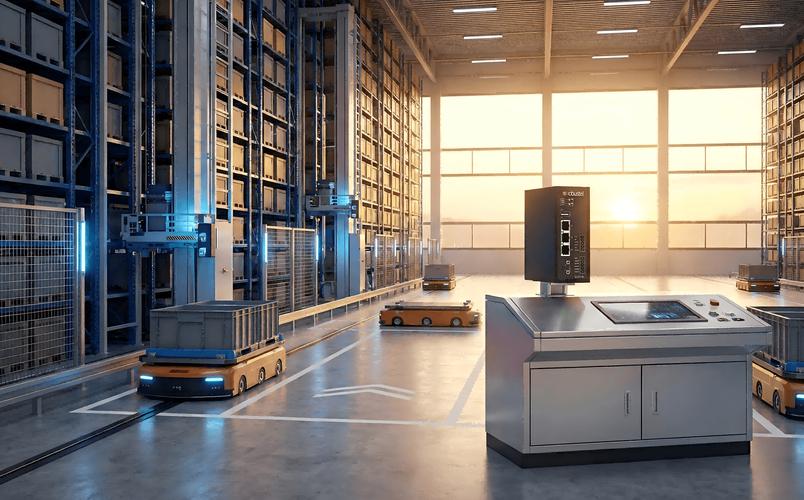 工业产线边缘网关部署位置实景图
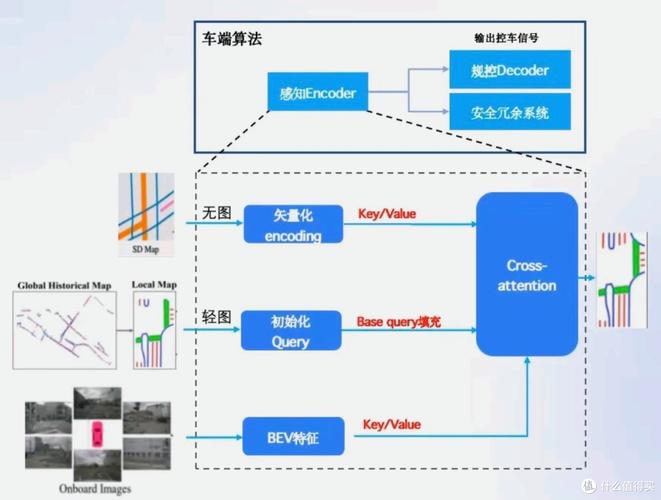 车端自动驾驶边缘计算模块拆解图
不是把模型缩小就行的算力账
很多人对这类方案的认知,还停留在“把云端的大模型剪枝、量化,塞到小盒子里”的阶段。真的不是。 现在主流的工业边缘网关,CPU算力大概8TOPS,内存普遍8GB。要是硬把量化后的ViT-Large模型塞进去,单帧推理就要120毫秒,根本跟不上产线的运转节奏。这里的核心不是模型越小越好,是要算清楚每一份算力的投入产出比。很多在项目一线踩过坑的工程师都知道,当初为了赶项目进度,把边缘侧的模型精度从99%压到95%的时候,就该想到后续要花多少时间去补那些漏判、误判的窟窿,毕竟产线上的一个漏检,流到客户端带来的售后成本,可能比整个边缘硬件的采购成本还高。 端云协同的动态推理调度机制,才是这套方案能跑通的核心。简单说,就是把样本按照历史置信度分档:特征明显的划痕、变形类缺陷,在边缘侧的轻量化ResNet18模型上直接判定,这类样本能占到总采集量的92%;剩下8%的模糊样本——比如沾了切削液反光、光线角度偏斜的难判样本,再传到云端的大模型做二次复核。整个调度过程不是固定阈值卡着,是要根据当时的网络带宽、云端任务排队时长动态调整的。 算下来这套系统的平均延迟是22毫秒,比全云端方案的效率高11倍,还省了70%的上行带宽。工业产线边缘网关部署位置实景图
被厂商宣传忽略的应用边界
别被宣传稿带偏。边缘智能不是万能解药,有明确的适用范围。 什么场景不适用?需要跨地域全局优化的任务。比如省级电网的全网潮流调度,总不能让每个台区的边缘节点自己算调度方案吧?各个节点的策略一旦冲突,轻则局部断电,重则引发全网的连锁故障。这类任务的核心是全局协同,单节点的局部优化再精准,也解决不了系统层面的问题。 还有个容易踩的坑:硬把超出算力阈值的任务往边缘塞。之前接触过一个智慧城市的项目,想把路口的摄像头全部换成本地推理盒子,要单盒跑16路实时视频的交通行为分析。结果选的盒子算力不够,每到早高峰视频解码就开始丢帧,原来的闯红灯检测功能直接失效,反而比原来的云端方案错漏更多。 这里有个很实在的判断标准:边缘智能的适用前提是,推理任务的延迟敏感度高于全局协同需求,且单节点的推理负载控制在硬件算力的60%阈值以内。留足够的冗余应对突发场景——比如强光、雨雾导致的图像质量下降,不然本来想靠边缘省成本,最后反而要花更多钱补漏洞。 对比来看,自动驾驶车端的推理为啥能落地?因为车的感知决策要100毫秒以内出结果,等数据传到云端再把指令传回来,车都撞了。而且单帧的感知推理负载,刚好匹配车端芯片的算力,留了40%的冗余应对复杂天气场景,完全符合适用边界。车端自动驾驶边缘计算模块拆解图