被误读的语音识别技术:从实验室降噪到日常场景的落地边界
上周在新街口那家开了十二年的旧书店待了一下午。老板趴在柜台上对着麦克风念新收古籍的提要,旁边的转写设备跳出来一行字:“陶庵梦艺,一卷,明张代著。”
他盯着屏幕愣了三秒,伸手把麦克风拔了。
折腾了快半小时,换了三个不同厂商的转写接口,还是把“陶庵梦忆”识别成“陶庵梦艺”,把“张岱”认成“张代”。窗外的梧桐叶被风刮得沙沙响,邻桌的客人在聊晚上去哪个馆子吃盐水鸭,这些混杂的声响,直接把实验室里测出来的99%识别率砸得稀碎。
被简化的原理:不是“听懂”,是“猜中”
很多人对这项技术的想象,还停留在“机器能听懂人说话”的层面。真的不是。
现在主流的商用方案,核心逻辑是端到端的概率映射:把输入的音频切分成10毫秒左右的短帧,提取每一帧的频谱特征,再通过预训练好的大模型,匹配出最可能出现的文字token序列。没有所谓的语义理解,没有逻辑判断,就是算概率。
那些看起来能自动修正同音字、自动补全断句的功能,本质是模型在预训练阶段见过了上千万小时的中文语料,知道“陶庵”后面接“梦忆”的概率比“梦艺”高一千多倍,才做出的选择。一旦遇到训练集里没见过的发音、没接触过的场景噪音,概率计算就会直接偏航。
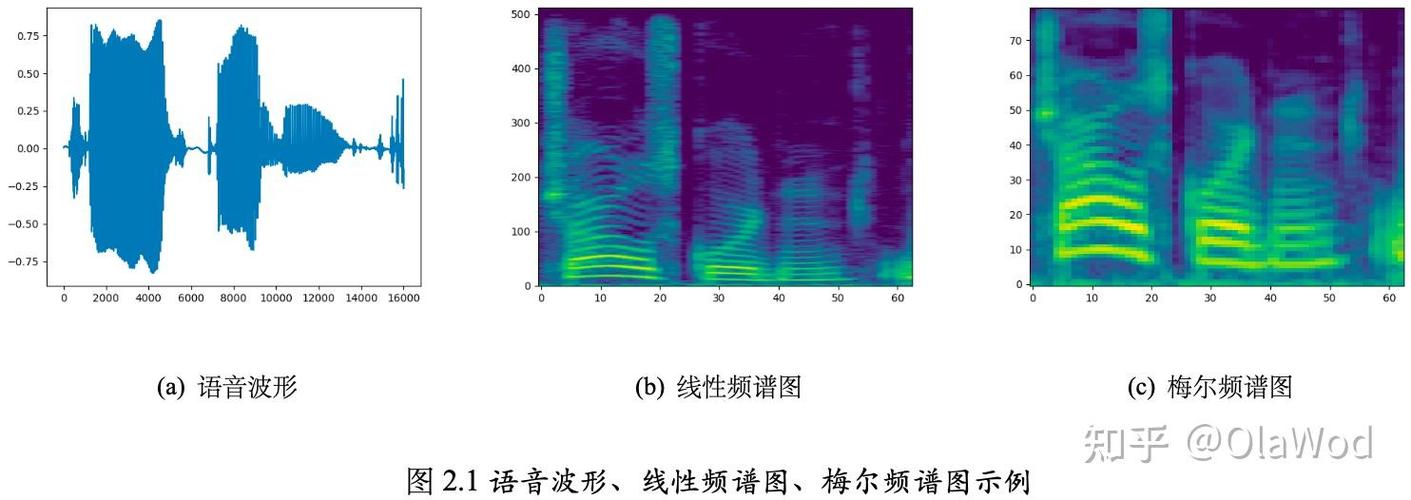 端到端语音识别频谱特征映射示意图
安静的消音室里,标准普通话对着近场麦克风,识别率自然能冲到99%。但你要是在地铁口、在广场舞的音响旁边、在老人带着沙哑嗓音说话的时候用,这个数字能掉到70%都算超常发挥。我上次帮书店老板调试设备的时候,把临街的窗户开了一条缝,外面电动车的喇叭声飘进来半秒,直接把“古籍善本”识别成“古籍善奔”,笑到我手里的雨花茶都洒了半杯。
卡脖子的不是模型,是没人愿意做的脏活
现在行业里的风气很奇怪。大家都在堆参数,从10B堆到100B,从单语言堆到多语言,发布会的PPT上全是刷出来的SOTA指标,但是没人愿意停下来看看,真实场景里的用户到底在说什么话。
公开的语音训练集里,90%以上的样本都是20到30岁的标准普通话使用者,发音清晰,语速适中,录音环境干净。但真实世界里,有带着江淮官话口音的南京老人,会把“我要去医院”说成“我啊要去医院”;有戴着厚重口罩的外卖员,说话闷得像隔着一层棉絮;有在工厂车间里上班的工人,说话的时候旁边是机床的持续轰鸣。这些样本,在公开训练集里占比连5%都不到。
 带江淮官话口音的语音样本标注场景图
去年我参与过一个面向南京社区独居老人的呼叫设备项目,一开始用的是头部厂商的商用模型,测试的时候直接把老人说的“我要喝热水”识别成“我要喝谁”,吓得社区的工作人员赶紧上门排查。后来没办法,团队花了三周时间,跑了三个主城区的老旧小区,录了120小时的老人日常对话,逐字逐句标注,再用小参数微调,才把识别率拉到能正常使用的水平。
没人愿意做这种事。
费时间,没重磅论文可以发,参数涨不上去,连发布会都没法吹。但这才是真的落地啊。你在实验室里刷再高的指标,到了真实场景里识别不准,对用户来说就是一堆没用的代码。
被吹过头的应用边界:它不是万能的录写工具
 被吹过头的应用边界:它不是万能的录写工具
现在很多人把这项技术当成了万能的“懒人工具”。开会的时候开着转写,以为能完全替代人工记录;跟客户打电话的时候开着转写,以为能自动整理成纪要;甚至有人在跟朋友私下聊天的时候也开着,以为能把所有对话都存成文字。
太乐观了。
最先撞上的是领域适配的硬门槛。你要是在普通的闲聊场景里用,识别错几个字没关系,大不了自己改。但要是在法学庭审记录、医疗病例转写、工程交底会议这种专业场景里,错一个字就可能出大问题。上次帮一个做工程的朋友测试转写,把“焊缝探伤检测”识别成“焊缝探商检测”,就差一个字,要是照着这个记录走流程,后续的质量检查根本过不了。
还有隐私的边界问题。现在很多免费的转写工具,会把用户上传的音频片段回传至服务器,哪怕厂商承诺“不会用于训练”,你也没法真的核实。去年就有个做教培的机构,给所有上课的老师装了转写系统监控课堂内容,结果系统把老师课上随口吐槽的“这届学生真难带”转写出来,被截图发到家长群里,闹得最后机构直接跟老师解除了合同。你以为是工具在帮你记录,其实你说的每一句话,都可能变成别人手里的素材。
更重要的是,技术本身是没有判断能力的。它能把你说的话转成文字,但它不知道哪些话是重要的,哪些话是无关的,哪些话是你不想被别人看到的。所有的边界,从来都是人给划的,不是技术自己能定的。
前几天再去那家旧书店,老板已经把转写设备收进了柜台的抽屉里。还是拿着钢笔在宣纸上写古籍的提要,字歪歪扭扭的,但是没错过字。
他说,反正识别出来的东西还要花半小时改,还不如自己写得快。
也是。