计算机视觉技术:从实验室刷榜到现实里“磨细节”的这三年
上周跟浙大做CV的朋友吃烤串,他吐槽说组里刚投出去的ICCV论文,被审稿人挑了个离谱的毛病——测试集里拿真实工地拍的扬尘画面测,他们做的小目标检测模型,把远处飞的塑料布认成了无人机。
别再吹ImageNet刷榜了,落地卡壳的地方全是硬骨头
说实话,搁十年前提计算机视觉技术,大家的印象还停留在实验室里追着ImageNet竞赛刷榜的阶段。那时候谁的模型在标准测试集上的错误率低0.1个百分点,能在圈子里吹小半年。现在呢?ImageNet竞赛的错误率已经从2010年的28.2%降到了2023年的1.4%,比人眼的识别错误率还低。按说技术已经牛到没边了对吧?
真不是。
我前两年陪做工业检测的朋友跑客户,那场面现在想起来都头疼。客户是做汽车焊接车间的,要找焊缝里0.1毫米的裂纹,一开始拿实验室训好的模型去测,实验室环境里准确率92%,听着还行对吧?结果拉到车间现场,车间里焊花飘的,工人戴的防护面罩反光,旁边的机械臂晃来晃去挡镜头,当天测了200张图,错了72个。92%的实验室准确率,到了真实场景直接掉成64%。
脸都绿了。
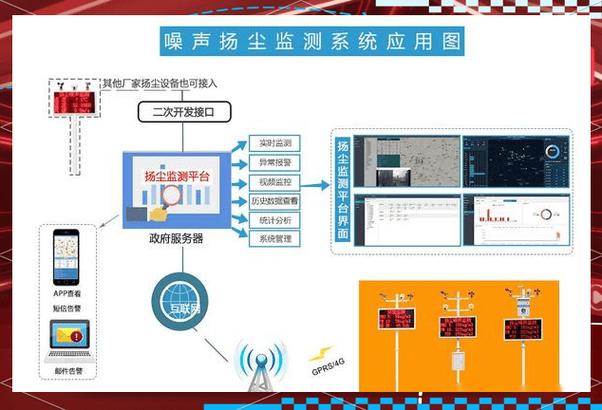 计算机视觉小目标检测扬尘工地误判示意图
后来折腾了快俩月,专门针对车间的场景采了3万多张图,做了上百种数据增强——给图加焊花的动态模糊、加烟尘的半透明遮挡、加不同角度的反光斑块,才把准确率拉到99.2%。说穿了,之前实验室里训的模型,根本没见过这种乱糟糟的真实世界。
去年CVPR上拿了最佳学生论文提名的那个域泛化工作,本质上就是在解决这个问题:不用在目标场景采一大堆标注数据,靠风格迁移把源域的干净图自动转成带噪声、带特殊光照、带遮挡的目标域风格,就能把跨场景的检测准确率提32%。听着简单对吧?之前多少人卡在这里卡了五六年。
现在好多厂商吹自己的CV模型准确率99%,你追着问一句测的是哪个数据集,他立马支支吾吾。全是在自己挑的干净测试集上测的,真拉到大马路上跑,能把路边的路牌认成外卖柜,把天上飞的塑料袋认成无人机。
现在的计算机视觉技术,早就开始“管闲事”了
很多人对CV的印象还停留在早年的人脸识别、车牌识别,就是你过收费站的时候摄像头认你的车牌,进小区的时候刷脸开门。真不是,现在的CV早就扎到了你根本想不到的场景里。
我去年去浙江丽水的茶园调研,茶农说现在不用雇人蹲在山上数茶芽了。架个带边缘计算端侧推理的相机,每天早上自动扫一遍整片茶园,哪个区域的茶芽到了可以采的标准,直接给采茶工发导航定位。算下来一年省了十几万的人工钱。一开始这模型也闹笑话,把茶树上长的小蚜虫当茶芽报,给茶农整得哭笑不得,后来补了两千多张带虫的标注图,才把这个误判率压下去。
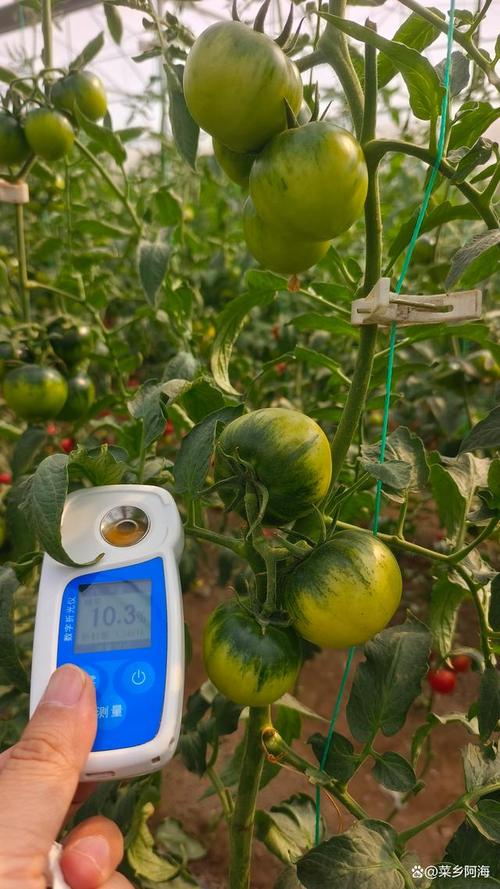 计算机视觉技术无接触测番茄糖度田间场景图
还有更绝的。以前农业科研人员要测番茄的糖度,得把果子摘下来,用仪器刺破果皮测汁液,一上午测不了20个果。现在拿相机在番茄前面30厘米的位置拍一张,靠高光谱的视觉分析,不用碰果子就能算出糖度,误差不到0.5度。去年Nature Plants上发的那个作物表型研究更狠,拿无人机绕着试验田飞一圈,用多视角视觉重建,两个小时就能测完之前科研队一个月的工作量——小麦的株高、穗数、每穗的籽粒数,甚至叶片上的病虫害斑点大小,算得一清二楚,还不会把麦子踩坏。
医疗领域的应用就更不用说了。现在很多基层卫生院没有专门的眼科医生,拿个眼底相机拍一张患者的视网膜照片,CV模型能自动判断有没有糖尿病视网膜病变,准确率比工作了三五年的基层医生还高。之前有个云南的村医跟我说,靠这个技术,他们村的糖尿病患者早发现了17个,要是等患者自己感觉到视力模糊再去县医院,说不定已经失明了。
别神化大模型,CV的未来根本不是全知全能
 别神化大模型,CV的未来根本不是全知全能
最近一两年大家都在吹多模态大模型,好像只要把视觉模型接到大语言模型上,CV就直接升级成通用智能了,啥都能认,啥都能分析。多模态通用大模型的落地瓶颈从来不是“认得出”,而是“算得准、跑得快、不泄密”。
举个最简单的例子,你要做工业里的焊缝检测,需要模型把0.1毫米的裂纹都抓出来,多模态大模型给你输出一句“这里有个焊缝,看起来结构挺完整的”,根本顶不了用。你要算的是毫米级的精度,大模型给你的是泛化的语义描述,差着十万八千里。
还有隐私的问题。现在好多CV模型都是拿网上爬的几千万张人脸照片训的,根本没经过本人授权。真要是全知全能的摄像头装在每个角落,能把你每天几点出门、买了什么、跟谁聊了多久全记下来,给你推对应的广告,甚至卖给出价高的营销公司,你乐意啊?去年欧盟AI法案把公共场景下的人脸识别划成了高风险应用,没经过用户同意随便拿摄像头拍人、识别身份,最高能罚全球营收的6%。国内现在也在推相关的规范,以后公共场景的摄像头,不能随便把人脸数据传到云端存着。
其实现在圈子里真正在闷头做的方向,根本不是什么全知全能的通用视觉大模型。是那种指甲盖大小的端侧芯片,上面跑的轻量化CV模型,一张图的推理时间不到10毫秒,功耗只有几毫瓦。相机拍了图直接在本地算,根本不用把原图传到云端,既快又不会泄露隐私。比如你家楼下的智能摄像头,能识别是自家猫跑出去了还是陌生人进来了,不用把你家客厅的画面全传到厂家的服务器上。
上周跟那个浙大的朋友再吃烤串,他说之前被审稿人挑的那个误判问题,现在加了个小的语义分支,把不同材质的反光特征单独抽出来,已经把那个塑料布误判的问题解决了,新的论文投了ECCV。
他说其实做CV久了就知道,哪有什么一劳永逸的技术。
无非是一个误判一个误判地改,一个场景一个场景地磨。
就像烤串要一串一串翻,火大了糊,火小了不熟。