看不见的折旧:重新理解资产性能管理的落地边界
上个月去南京江宁的智能制造产业园跑调研,在冲压车间门口撞见一个蹲在路边抽烟的厂长,烟灰落了一裤脚也没弹。问起怎么了,他说头天夜里一条主力线停了11个小时,主轴轴承磨坏了,之前只按规程换润滑油,没人盯着振动数据盯性能变化,那一下订单拖期加废料损失,亏了小二十万。
很多人听到这个,第一反应就是上系统装传感器,好像把数据连上网问题就解决了。真不是这么回事。
被颠倒的逻辑:从“修坏的”到“防坏的”
国内大部分制造类企业,这么多年走下来无非两种维护逻辑:一种是坏了再修,能转就绝不拆,省钱,但一碰到核心资产出问题,就是停线的大损失;另一种是定期大修,到点就拆就换,图个安稳,可大多时候换下来的部件还有大把剩余寿命,纯纯的浪费。
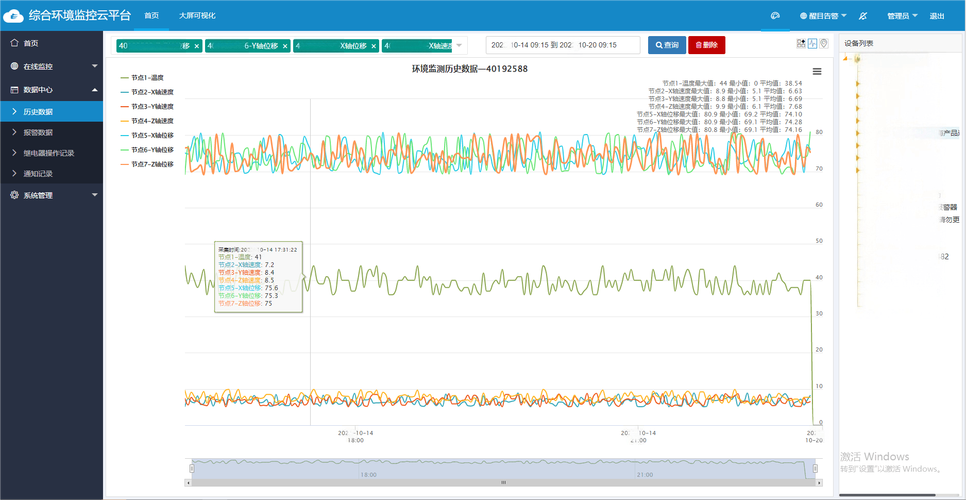 工业冲压线主轴振动监测性能趋势图
南方有家中型水泥厂,前几年按行业标准搞三个月一换辊,每次换下来的磨辊送去检测,大多还有六成以上的剩余使用寿命,一年算下来浪费了近三百万的采购成本。这就是看不见的折旧,你没摸清楚性能衰减的规律,要么亏停机,要么亏过度维护,两头不讨好。
核心逻辑其实很简单:把对资产的管理,从“盯着有没有坏”转到“盯着性能掉没掉”。性能衰减是个连续过程,不是某天突然坏掉的,早从三个月前数据就有苗头了,只是没人抓而已。
落地的正确路径:分层锚定,而非全网覆盖
说实话,现在市面上大部分吹出来的方案,都是给企业挖坑。上来就说要给所有资产装传感器联网,全采集全分析,一套下来几百万扔进去,最后攒了一服务器没用的数据,啥结论也出不来。
真正能落地的做法,第一步永远是先给资产分优先级,锚定瓶颈约束资产。这类资产的特点就是,只要它停了,整条生产线甚至整个工厂都得停,比如化工企业的裂解炉、汽车厂的主力冲压线、风电场的风电机组主轴,这些才是值得花高成本装高频传感器盯着的核心。
第二层是重要影响资产,比如辅助泵、备用电机、输送皮带这类,坏了不会立刻停线,但会影响产品质量或者拖慢生产节奏,这类不需要高频采样,一周抽一次数据看性能趋势就足够,没必要花那个冤枉钱。
第三层就是低价值通用资产,比如车间的通风扇、办公楼的空调,坏了直接换个新的也花不了几个钱,根本没必要管什么性能,真要联网监测,成本比换个新资产还贵,得不偿失。
 工业资产性能分层管理优先级矩阵图
还有个90%的项目都会踩的坑:把寿命预测做成了黑箱。算法模型给出来一个剩余90天寿命的结论,没人说清楚这个结论是从哪个参数、哪个变化趋势算出来的,现场的维护工程师不敢信。之前碰过一个东部的风电项目,算法对外宣称准确率超过80%,但现场运维就是不用,因为错一次就是几十万的叶片更换损失,没人敢拿自己的饭碗赌模型的准确率。所以在这里,可解释性永远比模型准确率更重要,你得让干活的人信服,才用得起来。
别神化:讲清楚应用边界和隐藏风险
 别神化:讲清楚应用边界和隐藏风险
这件事不是万能药,有清晰的应用边界,不是所有行业所有资产都适合搞。
轻资产行业本身就没多少固定资产,犯不上折腾。重资产行业里也分,比如露天矿山的挖掘机,天天在不同硬度的岩层作业,荷载波动完全没有固定规律,现有的疲劳衰减模型根本摸不准规律,目前还没有特别成熟的落地方案,别听厂商忽悠着早早交钱当小白鼠。
还有两个隐藏风险,很少有人提。第一个是数据安全,核心资产的运行数据,比如电厂的机组参数、化工厂的主反应炉温度压力参数,都是企业的核心机密,很多企业为了省成本把数据传到公有云做分析,万一泄露,损失根本没法估计。第二个是人员能力的断层,上了智能系统之后,原来干了二三十年的老维修师傅不会用,年轻的运维只会看系统报警,不会自己上手摸故障,系统没报警就觉得没问题,最后硬生生拖出大事故。去年在山东一个电厂就碰到过这类事,老师傅退休,年轻人看系统显示瓦温正常,没摸到温度缓慢爬升的趋势,最后烧了轴瓦,亏了上百万。
不过话说回来,现在行业里慢慢出来一个很有意思的方向,就是把性能和能耗绑定。资产性能下降之后,能耗一定会涨,比如磨损的电机,能耗会比正常状态高10%到15%,把性能调好,本身就是降碳降能耗,刚好贴合现在的需求,只是很多企业现在只是拿这个当概念拿补贴,没真沉下心落地。
说白了,这件事本质上就是把原来老师傅凭经验摸出来的性能规律,变成可量化可追踪的数据决策,没那么神,也没用那么不堪。找对自己该管的资产,摸准该盯的数据,比攒一堆花里胡哨的概念有用多了。