刨开问题表层:根本原因分析为什么总能帮你避开重复踩坑
上个月跟一个做制造的老朋友在南京老门东喝茶,他吐槽说今年生产线同一个故障出了三回,罚了工人罚组长,钱扣了不少,问题该来还是来。说白了,就是没挖到最底下那层。
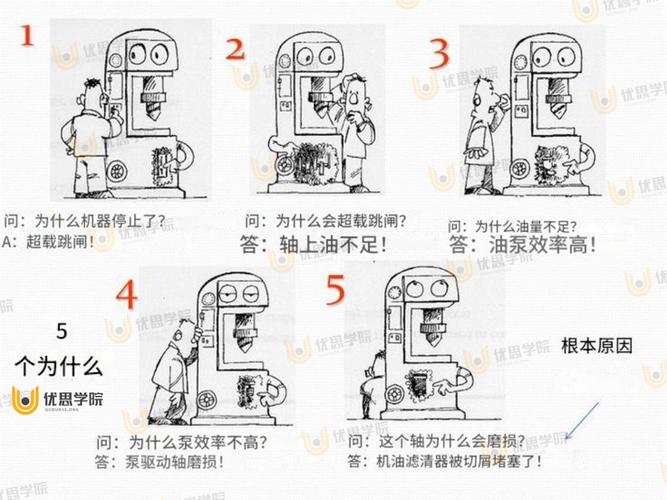 根本原因分析五层追问工厂停机案例图
很多人会说,我哪有那么多时间一层层追?小问题当然不用,可那种 recurring 的问题,影响大的问题,不挖透就是给自己埋雷。
太常见了。
直接诱因是触发问题的最后一块多米诺,它摆在最显眼的地方,可它从来不是根源。根源是那个一直藏在系统里,只要不拿掉,就一定会推倒第一块多米诺的那个隐形支点。
很多人搞反了。
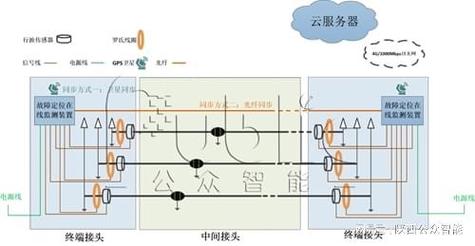 互联网线上故障根因系统定位示意图
真正的核心问题,永远出在规则、流程和底层设计里,从来不是某一个人的错误。有人粗心是难免的,只要流程里加一道双人审核,加一道自动化测试,就能挡住百分之九十的粗心错误。要是把所有问题都归给某个人的失误,那永远解决不了问题,下次换个人,该错还是错。
不过话说回来,老板其实就爱找背锅侠, quick win 交差快,大家都懂。可要是你真的想把事情做好,就得跳出这个陷阱,别跟着一起甩锅,往系统层面挖。
 符合实践的操作逻辑,以及应用边界
很多人一提这个方法,第一反应就是五个为什么,好像只要连着问五个为什么,自然就能挖到根。哪有这么教条的事。
追问错了方向,问一百个为什么也没用。举个例子,你发现产品新用户留存掉了十个点,追问:为什么留存掉?因为新用户七天没打开。为什么没打开?因为没用到核心功能。为什么没用到?因为找不到入口。为什么找不到?因为入口放第三屏。好了,你得出结论根因是入口太深,改完放首页,结果留存一点没涨——因为真实原因是竞品直接免费开放了核心功能,用户直接转过去用了,你改入口有什么用?
所以正确的第一步,从来不是上来就追问,而是先验证你拿到的每一个事实。你说留存掉是因为入口太深,那先拉个数据看看,那些找不到入口的用户是不是真的流失了,做个小范围测试,把入口挪到首页看留存涨不涨,验证对了再往下挖,不对就赶紧换方向,别在错的路上死磕。
还有很重要的一点,就是要清楚应用边界。不是什么问题都值得挖根。你今天出门被共享单车刮了一下,这是偶然事件,没必要挖什么根因,下次走路注意就行。只有满足这几个条件的问题,才值得花时间精力深挖:重复发生的问题、影响范围超过一个人的问题、会带来长期损失的问题。上来什么问题都搞全套分析,那就是过度设计,浪费所有人的时间。
挖到根因也不是结束,很多人搞错了,挖完根因写个报告就完事了。不对,核心是改系统。你挖到根因是供应商偷换材质,不能只换个密封圈就完事,你得改供应商质检规则,加一道材料进厂抽检环节,不然下次还会有人偷换。你挖到根因是上线前没做限流测试,那你就得把限流测试加到上线的强制流程里,不通过就不能发版,不然下次还会崩。
当然,也不是所有根因都能立刻完美解决。比如你挖到根因是用了十年的老架构性能不够,要全重构,可现在公司没钱没人,排不上期,那怎么办?先加临时方案,比如加预警,加限流,把损失降到最低,等有资源了再动,这不丢人。接受有限条件下的解决,比非要一口吃成胖子最后拖到项目黄了强得多。
很多人怕麻烦,觉得挖根因太费时间,凑活解决完眼前就行,可一次次凑活,Same problem 换个 skin 一次次出来折腾你,攒到最后就是炸不开的大坑。你多花一天挖到根因,改完系统,接下来一两年都不用再为同一个问题折腾,算下来反而省了不知道多少力气。
别把直接诱因当成核心根源
遇到问题,大多数人的第一反应是解决眼前的麻烦,机器停了先换保险丝,网站崩了先重启服务,销量掉了先加推广,麻烦消了就万事大吉。没人会往下多挖一层。 就说那台停机的机器,所有人都看到保险丝烧断了,换完就能转,可没人想为什么保险丝会好好的烧断。追一层,是齿轮轴承磨损卡住了,再追,是杂质进去磨坏了轴,再追,是过滤器的密封圈老化漏了杂质,再追,是供应商为了压成本偷偷换了密封圈的材质,原来用耐油橡胶,换成了普通塑料。 你看,停在哪一层,决定了你能不能彻底解决问题。停在保险丝那层,过三个月还会烧。停在齿轮那层,换完齿轮还会磨坏。只有挖到供应商材质偷换这一层,改了准入规则,才能彻底断掉问题的根。根本原因分析五层追问工厂停机案例图
很多人会说,我哪有那么多时间一层层追?小问题当然不用,可那种 recurring 的问题,影响大的问题,不挖透就是给自己埋雷。
太常见了。
直接诱因是触发问题的最后一块多米诺,它摆在最显眼的地方,可它从来不是根源。根源是那个一直藏在系统里,只要不拿掉,就一定会推倒第一块多米诺的那个隐形支点。
很多人搞反了。
常见的陷阱:把找人背锅当分析
说实话,我见过八成以上的所谓分析,最后都变成了甩锅大会。线上出了故障,怪开发粗心大意,怪运维没盯紧监控,怪产品没说清楚需求,反正找个具体的人背锅,处罚一顿,报告交上去,万事大吉。 这哪是找根源,这是给老板交差。 之前认识一个电商公司的运营负责人,他说去年大促崩了一次,复盘的时候全组骂运维没做好扩容,结果第二年大促,流量比上年还低十万,照样崩了。后来静下心挖才发现,根因根本不是运维没扩容,是他们的支付接口根本没做降级,只要流量一超过阈值就全堵死,就算扩容十倍,该崩还是崩。互联网线上故障根因系统定位示意图
真正的核心问题,永远出在规则、流程和底层设计里,从来不是某一个人的错误。有人粗心是难免的,只要流程里加一道双人审核,加一道自动化测试,就能挡住百分之九十的粗心错误。要是把所有问题都归给某个人的失误,那永远解决不了问题,下次换个人,该错还是错。
不过话说回来,老板其实就爱找背锅侠, quick win 交差快,大家都懂。可要是你真的想把事情做好,就得跳出这个陷阱,别跟着一起甩锅,往系统层面挖。
符合实践的操作逻辑,以及应用边界
符合实践的操作逻辑,以及应用边界
很多人一提这个方法,第一反应就是五个为什么,好像只要连着问五个为什么,自然就能挖到根。哪有这么教条的事。
追问错了方向,问一百个为什么也没用。举个例子,你发现产品新用户留存掉了十个点,追问:为什么留存掉?因为新用户七天没打开。为什么没打开?因为没用到核心功能。为什么没用到?因为找不到入口。为什么找不到?因为入口放第三屏。好了,你得出结论根因是入口太深,改完放首页,结果留存一点没涨——因为真实原因是竞品直接免费开放了核心功能,用户直接转过去用了,你改入口有什么用?
所以正确的第一步,从来不是上来就追问,而是先验证你拿到的每一个事实。你说留存掉是因为入口太深,那先拉个数据看看,那些找不到入口的用户是不是真的流失了,做个小范围测试,把入口挪到首页看留存涨不涨,验证对了再往下挖,不对就赶紧换方向,别在错的路上死磕。
还有很重要的一点,就是要清楚应用边界。不是什么问题都值得挖根。你今天出门被共享单车刮了一下,这是偶然事件,没必要挖什么根因,下次走路注意就行。只有满足这几个条件的问题,才值得花时间精力深挖:重复发生的问题、影响范围超过一个人的问题、会带来长期损失的问题。上来什么问题都搞全套分析,那就是过度设计,浪费所有人的时间。
挖到根因也不是结束,很多人搞错了,挖完根因写个报告就完事了。不对,核心是改系统。你挖到根因是供应商偷换材质,不能只换个密封圈就完事,你得改供应商质检规则,加一道材料进厂抽检环节,不然下次还会有人偷换。你挖到根因是上线前没做限流测试,那你就得把限流测试加到上线的强制流程里,不通过就不能发版,不然下次还会崩。
当然,也不是所有根因都能立刻完美解决。比如你挖到根因是用了十年的老架构性能不够,要全重构,可现在公司没钱没人,排不上期,那怎么办?先加临时方案,比如加预警,加限流,把损失降到最低,等有资源了再动,这不丢人。接受有限条件下的解决,比非要一口吃成胖子最后拖到项目黄了强得多。
很多人怕麻烦,觉得挖根因太费时间,凑活解决完眼前就行,可一次次凑活,Same problem 换个 skin 一次次出来折腾你,攒到最后就是炸不开的大坑。你多花一天挖到根因,改完系统,接下来一两年都不用再为同一个问题折腾,算下来反而省了不知道多少力气。