从零件到报废场:全生命周期管理为什么能重构产业逻辑
很多企业喊了好几年的降本,结果算来算去,大头都扔在后期维护和报废处置上了。
没人会在买新设备的时候,把未来二十年的换件、维修、拆解成本算进采购价里,更别说因为产品失效带来的连锁赔偿。
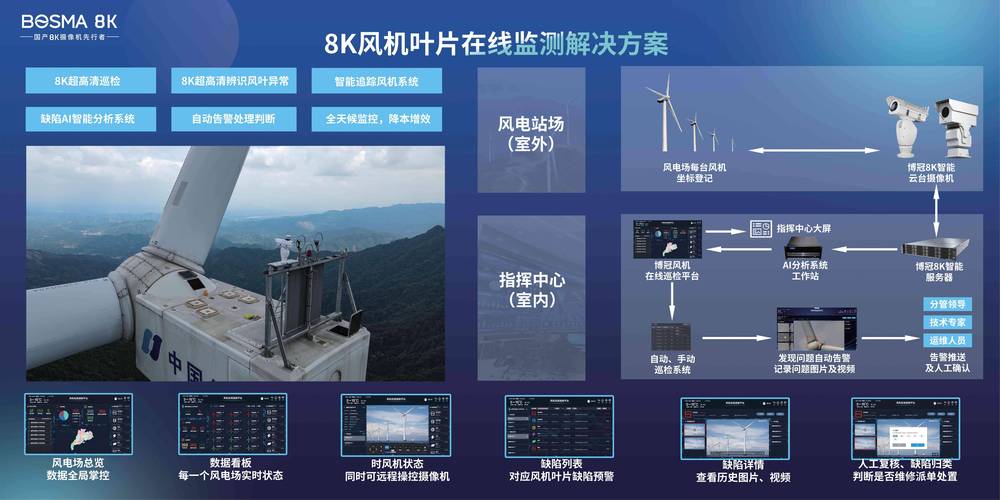 风电叶片全流程数据追踪看板
不少工厂花了大价钱上系统,最后做成了应付审核的电子台账。说白了就是给监管看的,自己用不了。
这是最常见的坑。
台账是死的,只记录“发生了什么”。而这套体系要活的,要回答“为什么会发生,下次怎么改”。
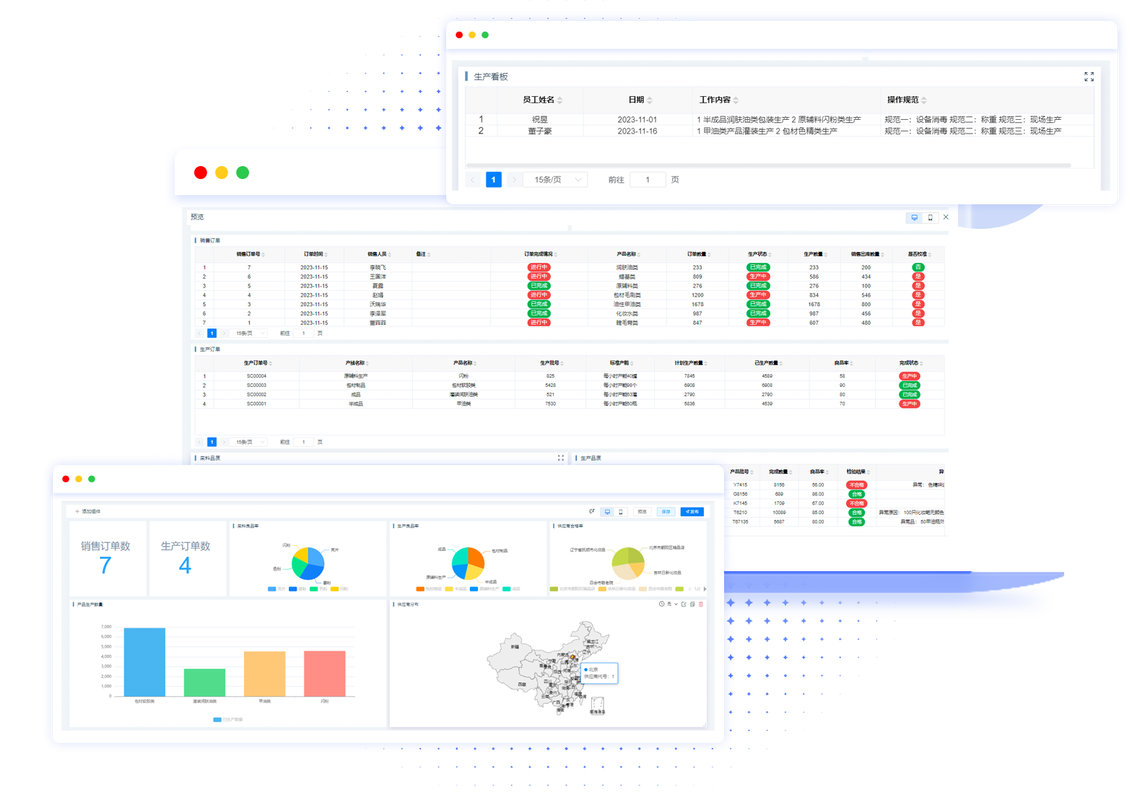 新能源汽车配件批次数据追溯系统界面
绕不开的问题是部门墙。
设计部只管能不能过性能测试,不管十年后材料会不会腐蚀;生产部只管合格率,不管售后好不好拆;售后只管修坏了的,不会把问题反馈回去改设计。大家各扫门前雪,数据自然就是一块一块的孤岛,串不起来。
不过话说回来,哪有什么天生的数据孤岛,都是利益孤岛。
所以实现路径的第一步,从来不是买系统找服务商,而是先把跨节点的责任绑到一起。让做设计的工程师,跟着售后去拆三台用坏报废的产品,亲眼看看自己当年选的便宜材料,在用户手里风吹日晒十年是什么样子,比开十次需求会都有用。
硬上划不来。
 应用边界和看不见的风险
不是所有产品都适合做这套体系,硬上就是交智商税。
比如一次性快消品,像路边摊卖的矿泉水瓶、一次性口罩,单产品成本才几毛几分钱,你给每一个瓶身都做从原油开采到回收降解的全数据追踪,成本比产品本身还高。
边界其实很好算:当后期维护、处置成本占产品全周期总成本的30%以上,做这件事才有明确的收益,低于这个比例,不如把钱花在别的地方。
就算符合边界条件,也有两个看不见的风险要提防。
第一个是数据安全。所有核心数据,从最开始的设计参数、原材料配方,到中间的生产数据,再到末端的用户使用数据,全部存在同一个中台里,相当于把企业的全部核心家底摆在一处,一旦出现数据泄露或者黑客攻击,损失根本没法估量。前几年就有一家做高端医疗设备的企业,因为系统漏洞泄露了上千台设备的运行数据,最后赔了大几千万。
第二个是合规风险。尤其是面向C端的产品,你采集了太多用户的使用数据,哪怕做了匿名化处理,也可能触碰个人信息保护的红线,之前有家智能家电企业就栽过这个跟头。
现在双碳目标下,全产业链要算产品碳足迹,刚好这套体系天然就能对接碳足迹核算,从原料开采的碳排放,到生产运输,再到最终报废回收的碳排放,每一段都能算得清清楚楚,需求涨得很快。
可市场上的方案鱼龙混杂,很多服务商就是换了个新包装,卖十年前的老系统,还是换汤不换药。
真正能落地的,从来都不是买一套系统摆在那就完事了。是盯着自己的真问题,一点点把打断的数据链接起来,让每个环节的人都能拿到对自己有用的信息,这才是真的有用。
被误解的“从生到死”
大多数人对这套体系的第一印象,就是给产品做一份从设计诞生到报废销毁的“人生档案”。 错得离谱。 它从来不是走个流程的记录工具,而是把每个节点的变量串联起来,反过来优化前端决策的逻辑框架。 举个很实在的例子,陆上风电的叶片,出厂标称寿命二十年,实际运行到第十到十五年,就会陆续出现表面腐蚀、叶片开裂的问题。如果从生产环节开始,就把原材料的批次、纤维的铺层角度、出厂的应力测试数据、后续每一次巡检的损伤记录全部串起来,就能提前一两年预判哪个叶片会出问题,提前安排维护,不用等到出故障停机再抢修——一次大风电停机一天,损失就是几十万。风电叶片全流程数据追踪看板
不少工厂花了大价钱上系统,最后做成了应付审核的电子台账。说白了就是给监管看的,自己用不了。
这是最常见的坑。
台账是死的,只记录“发生了什么”。而这套体系要活的,要回答“为什么会发生,下次怎么改”。
核心是数据反向流动,不是流程闭环
说实话,技术原理一点都不复杂。可九成企业都做错了方向。 大家都忙着把每个环节的流程卡死,要求每个岗位必须录入数据,却忘了最关键的一步:让售后、报废端的数据,流回设计和生产端。 国内某新势力车企的做法值得提,他们给每一个核心配件都打上了可追溯的二维码,从钢材冶炼的炉号,到冲压车间的机床参数,到总装的焊接工人ID,再到4S店每次保养的记录,全部联网。用户换配件的时候,如果发现同一批次的配件都出现了过早老化的问题,设计部能在三天内拿到所有相关数据,直接改下一款车型的材料标准,召回也能精准到具体批次,不用大面积撒网。 反例就摆在眼前,前几年某传统车企召回十几万台车,其实真正有隐患的只有三个批次一万多台,就是因为出厂数据断档,没法精准定位,只能全范围召回,平白多花了几十亿的冤枉钱。新能源汽车配件批次数据追溯系统界面
绕不开的问题是部门墙。
设计部只管能不能过性能测试,不管十年后材料会不会腐蚀;生产部只管合格率,不管售后好不好拆;售后只管修坏了的,不会把问题反馈回去改设计。大家各扫门前雪,数据自然就是一块一块的孤岛,串不起来。
不过话说回来,哪有什么天生的数据孤岛,都是利益孤岛。
所以实现路径的第一步,从来不是买系统找服务商,而是先把跨节点的责任绑到一起。让做设计的工程师,跟着售后去拆三台用坏报废的产品,亲眼看看自己当年选的便宜材料,在用户手里风吹日晒十年是什么样子,比开十次需求会都有用。
硬上划不来。
应用边界和看不见的风险
应用边界和看不见的风险
不是所有产品都适合做这套体系,硬上就是交智商税。
比如一次性快消品,像路边摊卖的矿泉水瓶、一次性口罩,单产品成本才几毛几分钱,你给每一个瓶身都做从原油开采到回收降解的全数据追踪,成本比产品本身还高。
边界其实很好算:当后期维护、处置成本占产品全周期总成本的30%以上,做这件事才有明确的收益,低于这个比例,不如把钱花在别的地方。
就算符合边界条件,也有两个看不见的风险要提防。
第一个是数据安全。所有核心数据,从最开始的设计参数、原材料配方,到中间的生产数据,再到末端的用户使用数据,全部存在同一个中台里,相当于把企业的全部核心家底摆在一处,一旦出现数据泄露或者黑客攻击,损失根本没法估量。前几年就有一家做高端医疗设备的企业,因为系统漏洞泄露了上千台设备的运行数据,最后赔了大几千万。
第二个是合规风险。尤其是面向C端的产品,你采集了太多用户的使用数据,哪怕做了匿名化处理,也可能触碰个人信息保护的红线,之前有家智能家电企业就栽过这个跟头。
现在双碳目标下,全产业链要算产品碳足迹,刚好这套体系天然就能对接碳足迹核算,从原料开采的碳排放,到生产运输,再到最终报废回收的碳排放,每一段都能算得清清楚楚,需求涨得很快。
可市场上的方案鱼龙混杂,很多服务商就是换了个新包装,卖十年前的老系统,还是换汤不换药。
真正能落地的,从来都不是买一套系统摆在那就完事了。是盯着自己的真问题,一点点把打断的数据链接起来,让每个环节的人都能拿到对自己有用的信息,这才是真的有用。