看不见的剪刀错痕:基因编辑脱靶检测的真问题
CRISPR就像一把分子剪刀,这个比喻大家都熟。但很少有人问,剪错的痕迹,我们真的能全部找到吗?
很多论文里写的“未检测到脱靶”,翻译过来其实是“用我们现有的方法,没有找到脱靶”,对吧?
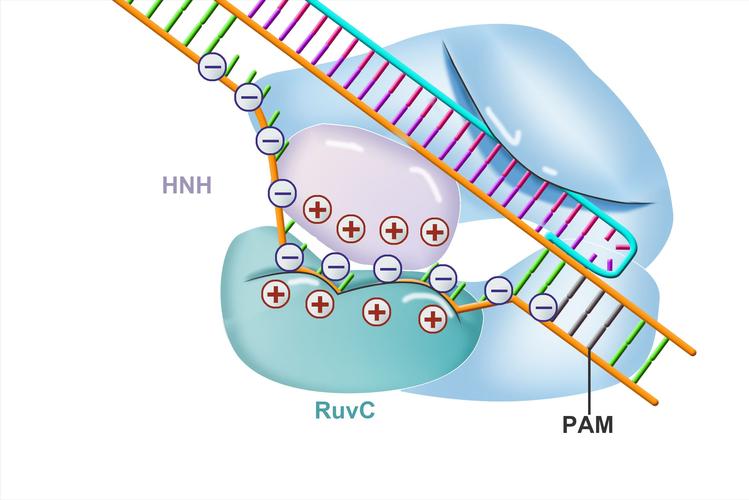 CRISPR基因编辑错配切割位点示意图
很多早期的研究,就是吃了定义不清的亏,把脱靶局限在同源错配的切割,漏掉了大量其他类型的非预期变异。直到现在,不少临床申报里的脱靶检测,还是只测同源位点的错切,结构性变异和全基因组范围的单碱基突变,根本不碰。
 GUIDE-seq脱靶捕获reads丰度对比图
不过话说回来,也不能怪技术不行,是成本卡在那里。你要测0.1%频率的变异,WGS深度至少要1000×,一个样本的测序成本就要几万块,放到临床批量检测里,根本不可能承担。很多时候不是测不出来,是不敢测,测不起。
还有一个更大的盲区,就是结构性变异。现在已经有研究证明,CRISPR编辑后,有超过10%的概率会出现兆碱基级的染色体缺失或者易位,这些变异比单点脱靶的危害大得多,因为往往会影响几十个基因的表达,甚至直接导致细胞癌变。但大部分现有的检测方法,都是针对点变异的,对这种大片段结构变异,检出率不到30%。
 跳出精度陷阱,走向全范围覆盖
现在整个领域都在往哪个方向走?不是追求更高的精度抓更低频率的点脱靶,而是要把之前漏掉的各类非预期变异,都纳入检测范围。
第一个路径是长读长测序的普及。短读长测序拼出来的基因组,本来就有很多重复区域拼不对,而这些重复区域恰恰是CRISPR容易脱靶的地方。长读长测序能直接读出几十kb甚至Mb级的序列,不管是大片段结构变异,还是重复区域的脱靶,都能轻松抓到。现在已经有团队用长读长测序,在原来认为完全安全的CRISPR靶点里,检出了三个兆碱基级的染色体缺失,这在之前用短读长测序根本做不到。
第二个路径是分层检测。不用每个样本都做全基因组高深度测序,而是先在靶点筛选阶段,就用高深度全基因组检测把所有可能的脱靶位点找出来,之后进入临床阶段,只需要检测这些提前发现的风险位点就可以,这样成本能降下来,也能覆盖大部分风险。这个思路现在已经被不少临床团队采用,毕竟,完全无盲区的检测,现阶段根本不现实,找到大部分风险,已经比之前完全漏掉强太多了。
应用边界其实很清晰:哪怕是最先进的技术,也没法做到100%覆盖所有脱靶。尤其是体内基因编辑,编辑后不同细胞的嵌合情况非常复杂,有些脱靶要经过好几次细胞分裂才会显现出来,单次测序还是有可能漏掉。风险依然存在,只是比十年前好太多了。
没人敢拍胸脯说,现在的方法已经能完全保证编辑的安全性。但至少我们已经开始知道,问题出在哪里,不再像以前那样,拿着半吊子的检测结果就说“安全无脱靶”。
技术的进步永远都是走一步,解决一个问题,再发现新的问题。我们不用急着吹什么“突破脱靶检测”,能把现在已经发现的盲区补上,就已经是很大的进步了。
被过度简化的“错配问题”
大众甚至不少初入领域的研究者,都默认脱靶就是Cas蛋白结合到和向导RNA序列相似的位点,切错了DNA双链。这个理解没错,但太浅了。 错切不等于脱靶。 有些位点错切了,但细胞自己修复了,没有留下可遗传的变异,这种脱靶其实对临床没有影响。反过来,有些我们认为是“对的”切割,反而会引发相邻区域的染色体大片段缺失或者重排,这种有害的结构变异,很多时候根本不算在“脱靶”的统计里。 脱靶的本质,是编辑后出现了所有预设之外的基因组变异,不是只有错配的切割才叫脱靶。 举个例子,单碱基编辑技术,不需要断裂双链DNA,只是改变单个碱基,之前很多人认为单碱基编辑脱靶率低,后来才发现,整个基因组里都会出现大量非预期的单碱基突变,这些突变不在向导RNA的同源位点上,原来的检测方法根本抓不住。CRISPR基因编辑错配切割位点示意图
很多早期的研究,就是吃了定义不清的亏,把脱靶局限在同源错配的切割,漏掉了大量其他类型的非预期变异。直到现在,不少临床申报里的脱靶检测,还是只测同源位点的错切,结构性变异和全基因组范围的单碱基突变,根本不碰。
现有技术的隐形盲区
说实话,现在市面上用的大部分检测技术,都有自己的盲区,没有一种方法能覆盖所有情况。 最常用的GUIDE-seq,原理是给断裂的双链DNA末端加接头,然后富集测序。优点是灵敏度够,成本也不算太高,但问题是,它只能捕获能留下双链断裂的脱靶,单碱基编辑的单核苷酸变异,缺口编辑的单链断裂,全都抓不到。 还有WGS也就是全基因组测序,听起来全,其实问题更多。大部分研究用的WGS深度只有30×,这种深度下,频率低于5%的低丰度嵌合脱靶,根本call不出来。而编辑后的细胞,本身就是嵌合的,早期胚胎编辑或者体内编辑中,很多有害脱靶的频率甚至不到1%,30×WGS扫过去,就是一片噪音,根本看不到。 之前有团队做过测试,把已知频率0.1%的人工嵌合脱靶样本,送给三个不同的第三方检测机构,用常用的方法测,结果没有一个机构检测出来这个位点。 你说可怕不可怕?GUIDE-seq脱靶捕获reads丰度对比图
不过话说回来,也不能怪技术不行,是成本卡在那里。你要测0.1%频率的变异,WGS深度至少要1000×,一个样本的测序成本就要几万块,放到临床批量检测里,根本不可能承担。很多时候不是测不出来,是不敢测,测不起。
还有一个更大的盲区,就是结构性变异。现在已经有研究证明,CRISPR编辑后,有超过10%的概率会出现兆碱基级的染色体缺失或者易位,这些变异比单点脱靶的危害大得多,因为往往会影响几十个基因的表达,甚至直接导致细胞癌变。但大部分现有的检测方法,都是针对点变异的,对这种大片段结构变异,检出率不到30%。
跳出精度陷阱,走向全范围覆盖
跳出精度陷阱,走向全范围覆盖
现在整个领域都在往哪个方向走?不是追求更高的精度抓更低频率的点脱靶,而是要把之前漏掉的各类非预期变异,都纳入检测范围。
第一个路径是长读长测序的普及。短读长测序拼出来的基因组,本来就有很多重复区域拼不对,而这些重复区域恰恰是CRISPR容易脱靶的地方。长读长测序能直接读出几十kb甚至Mb级的序列,不管是大片段结构变异,还是重复区域的脱靶,都能轻松抓到。现在已经有团队用长读长测序,在原来认为完全安全的CRISPR靶点里,检出了三个兆碱基级的染色体缺失,这在之前用短读长测序根本做不到。
第二个路径是分层检测。不用每个样本都做全基因组高深度测序,而是先在靶点筛选阶段,就用高深度全基因组检测把所有可能的脱靶位点找出来,之后进入临床阶段,只需要检测这些提前发现的风险位点就可以,这样成本能降下来,也能覆盖大部分风险。这个思路现在已经被不少临床团队采用,毕竟,完全无盲区的检测,现阶段根本不现实,找到大部分风险,已经比之前完全漏掉强太多了。
应用边界其实很清晰:哪怕是最先进的技术,也没法做到100%覆盖所有脱靶。尤其是体内基因编辑,编辑后不同细胞的嵌合情况非常复杂,有些脱靶要经过好几次细胞分裂才会显现出来,单次测序还是有可能漏掉。风险依然存在,只是比十年前好太多了。
没人敢拍胸脯说,现在的方法已经能完全保证编辑的安全性。但至少我们已经开始知道,问题出在哪里,不再像以前那样,拿着半吊子的检测结果就说“安全无脱靶”。
技术的进步永远都是走一步,解决一个问题,再发现新的问题。我们不用急着吹什么“突破脱靶检测”,能把现在已经发现的盲区补上,就已经是很大的进步了。