技术风险识别:我在南京软件园修了五年bug,才懂它不是找错这么简单
去年9月23号,南京软件园的桂香飘到我工位的时候,我正对着终端滚出来的一堆日志挠头。项目后天就要上线,运维甩过来一个截图,第三方支付接口的调用成功率已经波动到95%了。产品在群里@了我八遍,说用户付不了钱,大促第一天就能把客服线挤爆。找了整整三天,所有核心代码都走了一遍,啥问题都没发现。
那时候天已经黑透了,我下楼买了一碗鸭血粉丝,吹着晚风突然反应过来:我找的是已经出问题的bug,但这根本不是bug,是藏在那没炸的技术风险。
别把技术风险识别当成找bug
很多人刚入行都会搞错这个概念。觉得不就是上线前测功能,找出写崩的代码改了不就行了?
不对。bug是已经发生的错误,你能复现,能定位,能改。技术风险呢?是潜在的可能性——现在用着好好的,什么错都没有,只要某个条件触发,马上就炸给你看。
那天我回到工位,重新捋了一遍支付流程,最后发现问题出在哪?第三方给的限流阈值写的是单小时一万次调用,我们算并发的时候,只算了正常的用户下单请求,把用户网不好触发的重试请求给漏了。大促峰值的时候,加上重试能冲到一万二千次,刚好超过阈值,就会被限流卡单。
你说这是bug吗?平时测试流量只有几千次,根本碰不到阈值,代码逻辑也没写错,换谁测都觉得没问题。但它就是一颗拉了引线的雷,就等大促那天炸。
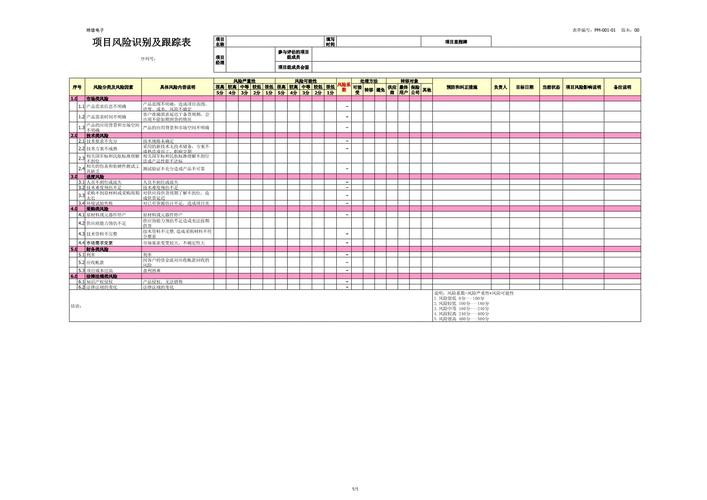 软件项目上线前技术风险排查手写记录表
说实话,我刚工作那两年也对这东西不上心。觉得就是流程上走个形式,反正功能跑通了就能上。直到踩了三四次大坑,半夜三点被运维电话叫起来回滚代码,冻得要死在打车去公司的路上才明白:技术风险识别,本质就是给你的项目买一份意外险。你现在嫌麻烦不做,真出事了赔的底掉。
它的核心从来不是找错,是提前问一句:如果这个地方出问题,会怎么样?
做技术风险识别,最容易踩的三个坑
我见过太多团队,要么把这事做成了应付老板的形式主义,要么就是抓不住重点瞎忙活,绕了半天啥风险都没找出来。总结下来,最多人踩的就是三个坑。
第一个坑,只查自己写的代码,不看所有外部依赖。现在哪有项目是从零堆出来的?前端要装十几个npm包,后端要用云服务的数据库缓存,还要对接七八个第三方接口,你自己写的代码可能才几千行,依赖的东西加起来几十万行。很多人排查风险,就查自己那几千行,别人的东西默认不会出问题。
前两年我碰过一个真实的事,一个创业团队用了一款免费的图片压缩开源包,用了大半年都好好的,没任何问题,结果作者把仓库卖给了广告公司,新版本悄悄加了挖矿脚本,用户安装依赖的时候自动带上,半个月后服务器CPU一直跑满,他们查了整整一周才查到问题,耽误了上线不说,还多付了好几万的服务器费用。
第二个坑,过度相信测试环境的数据。你测试环境的机器配置、流量大小、用户操作习惯,和线上真的不一样。我之前那个限流的例子,就是栽在这,测试环境根本跑不出峰值流量,你怎么测都没问题。
第三个坑,拍脑袋定风险等级。张口就是“这个风险不大,不用管”,全凭感觉,根本不考虑概率和影响。
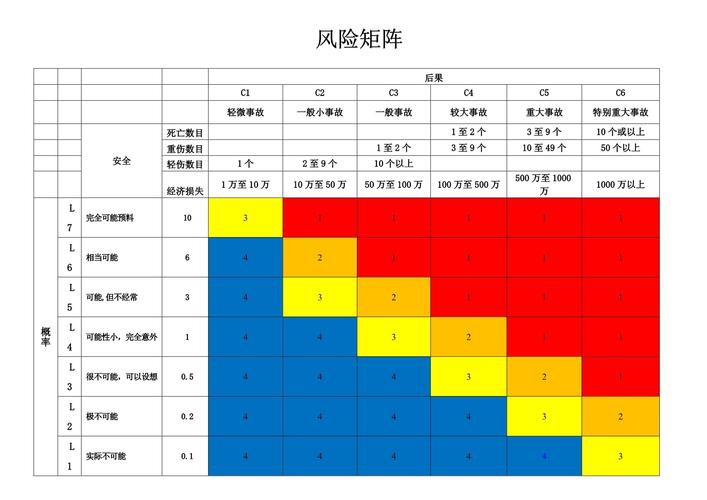 技术风险发生概率影响评估矩阵图
不过话说回来,很多中小团队没那么多人力物力,搞那种大型的风险评估体系也不现实,能不能有简单好用的方法?当然有。我做了五六年一线开发,攒了一套半小时就能做完的极简方法,够用。
一线工程师够用的极简识别法
 一线工程师够用的极简识别法
我现在不管带什么项目,上线前一定做四件事,不用写几十页的报告,也不会耽误太多时间。
第一件事,拉上所有关联角色开半小时“翻车头脑风暴”。别只叫开发,产品、运维、客服都拉进来,每个人说一个你最怕上线后出的事。开发怕数据库崩,产品怕核心流程出错,运维怕带宽不够机器炸,客服最怕一堆用户投诉没方案。你别说,很多风险真的只有一线接触用户的人才能想到,之前我做一个养老相关的项目,开发都觉得验证码流程没问题,客服一句“老人眼神不好,看不清图形验证码输错三次会不会锁账号”,直接点出了一个大风险,提前改了,不然上线真的要出大事。
第二件事,从用户点击到最终返回,捋一遍完整的数据流,每个节点停下来问一句:这个环节挂了怎么办?从用户点下单按钮开始,前端→后端接口→缓存→数据库→支付回调→短信通知,每一步都停下来,想清楚如果这个环节挂了,能不能降级?会不会影响整个流程?比如短信通知挂了,能不能让用户先看到订单状态,后台慢慢补发,别把订单卡着,这一下就把风险点找出来了。
第三件事,查一遍所有外部依赖的健康状态。开源组件看看最近半年有没有更新,有没有未修复的高危漏洞,第三方接口问问对方最近有没有切域名、更阈值、停服的计划,云服务看看你的配额够不够峰值用。就花十几分钟,能筛掉一大半潜在风险。
第四件事,压测别停在达标线。要求峰值QPS一千,你就压到两千,看看系统到底崩在哪,崩的那个点就是你要提前处理的风险。很多人压到一千刚好达标就停,真到峰值来了,直接崩给你看。
当然,我也得说清楚,技术风险识别不是万能的。你不可能把所有风险都找出来,总有不可控的黑天鹅,比如云厂商整个区域故障,比如第三方服务商直接倒闭停服,这种你再怎么排查也防不住,只能提前做容灾预案,降低影响。
今年9月23号我又回南京软件园,桂香还是和去年一样,飘得满楼道都是。帮一个刚创业的小朋友看项目,我提醒他先做风险排查,他说现在敏捷开发,快上线快速迭代不就行了,搞这个耽误时间。
我没跟他争辩,毕竟我也是踩过坑才懂的。技术这行,从来不是比谁上线快,是比谁能睡得安稳。你提前把能找的雷都挖了,上线该吃吃该睡睡,总比半夜被电话叫起来,冻得哆哆嗦嗦在高速上打车去公司强,对吧?