写字楼机房里的暗战:我亲历的大数据技术研发
去年9月23号,我在南京雨花软件谷的产业园,跟做大数据研发的老陈蹲在机房走廊的台阶上啃荠菜包子。刚咬了一口,运维的电话就打过来,说他们跑了一整夜的用户行为分析任务又挂了。老陈把包子往塑料袋里一塞,抹了抹嘴就往机房走,那背影我到现在都记得——像去上战场的。
不是所有攒出来的数据,都叫大数据技术研发
很多人对这个行当的误解太深。觉得买几十台服务器,存个几十上百TB的数据,把开源工具搭一遍,就算做大数据研发了。
老陈他们公司之前就是这么干的。做电商,老板说我们要搞大数据,砸钱买了集群,招了三个人的团队,结果不到三个月,全乱了。
原始日志全堆在一个库,埋点错了没人改,用户ID和用户名乱拼,点击事件和曝光事件混在一起,跑出来的报表一天一个数,运营拿着报表去找老板吵架,说你这大数据给的结果,还不如我凭经验拍的准。
说白了,脏数据再多,也出不来干净的结论。大数据技术研发,第一步根本不是什么建模、算法,是先把乱糟糟的数据理清楚,从埋点采集就开始抠细节。
就说埋点这件小事,一个按钮的点击,你要带什么参数?页面ID、用户标识、触发时间、网络环境,少一个,后面拼接的时候就是缺一块,补都补不回来。很多创业图快,埋点随便做,到后面清洗脏数据要花掉团队七成的时间,根本腾不出手做真正有价值的事。
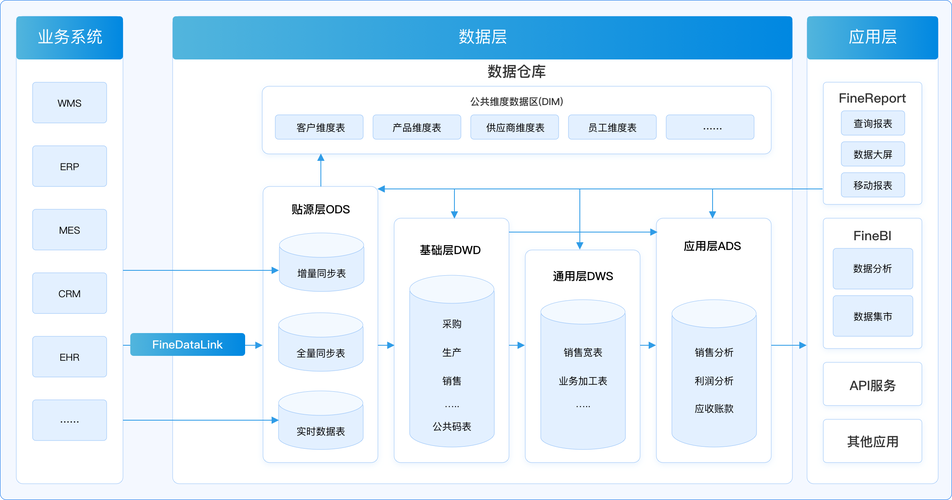 大数据研发离线数仓分层架构图
我见过好几个小团队,一共三个数据研发,两个天天写正则匹配脏数据,写了大半年,数仓还没搭完,老板就说大数据没用,把团队砍了。冤不冤?从根上第一步就走错了。
跑通一个任务,比你想的难一百倍
外人看大数据研发,觉得就是敲几行代码,集群自己就跑了,结果就出来了。哪有这么轻松。
你要做一个推荐系统的训练数据集,得从业务数据库同步原始数据,到数仓的ODS层,再清洗到DWD层做明细,再汇总到DWS层做主题,最后出宽表给算法团队,中间哪一步掉链子,全功尽弃。
上个月老陈找我帮忙查一个bug,任务一连失败了五天,后台显示全绿,就是跑出来的宽表全是空值。我们翻了三个小时的日志,最后才发现,业务库前几天改了一个字段的名字,数仓的同步任务没更新配置,拉回来的全是null,自动重试还次次显示成功,你说气人不气人?
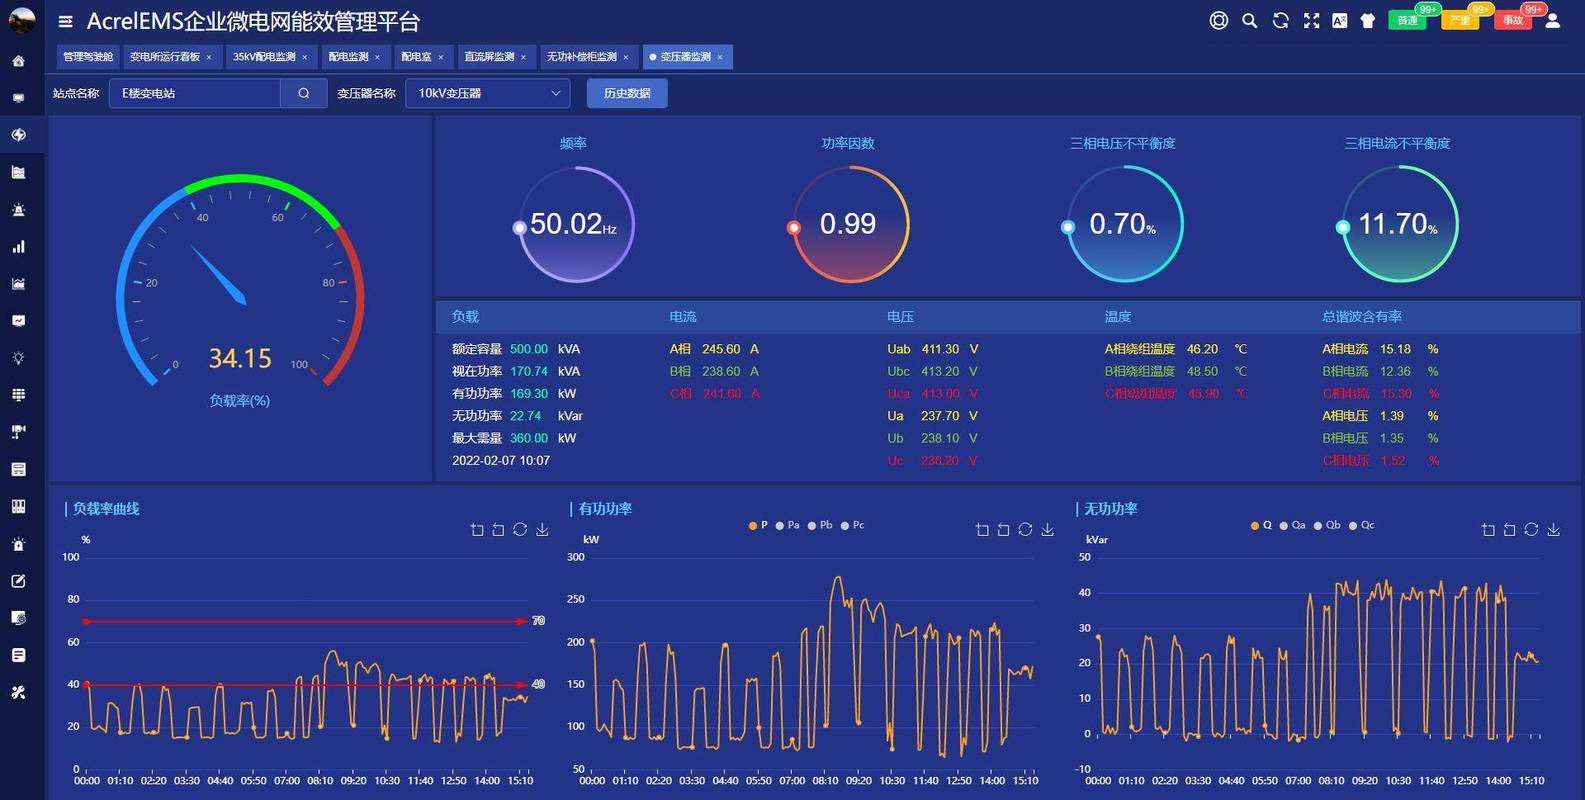 大数据研发任务调度失败监控面板
说实话,现在开源工具一大堆,看起来开箱即用,真要用到自己的业务里,全是坑。小公司没那么多服务器,就得砍组件,调参数,把本来给大公司做的工具硬塞进自己的集群里。大公司数据量太大,就得自己改源码,做分区裁剪,做存储优化,每一个参数都是熬好几个夜试出来的。
我刚入行的时候,为了调一个Spark任务的并发数,连续三天下班蹲在公司看日志,从128调到200,还是慢,从200调到256,一下子就快了三倍。那时候我盯着跑完的绿对勾,真想把键盘摔了,就差这么一点,熬了我三个通宵。
不过话说回来,跑出结果那一秒的爽,真的难忘。一堆乱麻一样的数字,终于理出了脉络,那种成就感,外行体会不到。对吧?
大多数人都踩过的研发误区
 大多数人都踩过的研发误区
干这行久了,见了太多没必要的坑,很多都是老板拍脑袋拍出来的。
第一个误区,什么数据都要存,追求所谓的全量数据。我见过一家公司,把用户五秒内连续点击同一个按钮的重复日志都存着,存了三年,光存储成本每年花几十万,一次都没用到。真要用到的核心数据,反而因为存储空间不够被清了,上哪说理去?大数据研发不是收集癖,有用的数据才值得留。
第二个误区,上来就要搞实时计算,好像不做实时就不够高级。其实绝大多数业务,T+1的离线计算完全够用。你做月度经营分析,做用户画像标签,要什么秒级延迟?白白多花几百万买服务器,撑那个面子,最后扛不住成本又砍回去,折腾一圈,钱花了,进度没了。
还有一个最大的误区,觉得大数据技术研发能解决一切问题。业务做不起来,说我们搞个大数据就好了,用户增长遇到瓶颈,说搞个大数据就好了。不对的。它只是个工具,只能把你业务里已经存在的规律挖出来,不能变魔术把烂业务变成好业务。要是你的用户都是刷来的假数据,再牛的研发也挖不出真结论。
还有现在越来越重要的风险,数据合规。很多团队研发的时候不注意权限管控,导出数据不做脱敏,一不小心把用户隐私泄露出去,那可是要吃官司的。我之前认识一个研发负责人,他们公司就是因为导出用户数据没脱敏,几百万条手机号流出去,整个团队都被请去喝茶,公司罚了一大笔钱,差点倒闭。那事儿闹得真不小!
那天跟老陈处理完任务,已经是傍晚了,我们又蹲回走廊台阶上啃剩下的包子。夕阳从机房的小窗户斜进来,落在监控屏上,满屏都是跳动的绿线,那就是大数据技术研发最真实的样子。
不是网上吹的什么改变世界,也不是PPT上画的高大上流程图,就是一群人,一个bug一个bug踩,一块数据一块数据理,把乱七八糟的数字,变成能帮业务往前走的东西。就够了。