抗风险技术设计:别等出事了才想起补窟窿
上个月跟一个做金融系统架构的老伙计喝酒,他拍着桌子骂,说去年赶项目为了省成本把异地多活砍了,结果今年IDC停电停了三小时,赔了快两千万。
亏到吐血。
谁都知道抗风险重要,可真到做项目的时候,永远是功能优先、进度优先、成本优先,抗风险设计永远是那个被砍掉的部分。
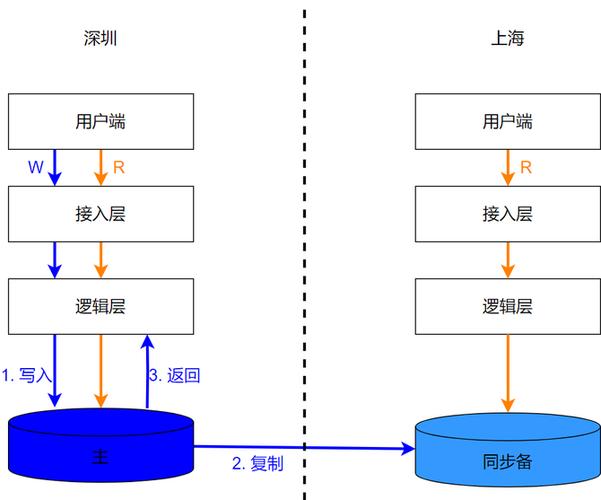 企业系统异地多活抗风险部署示意图
这两年科研领域提的抗脆性系统设计,核心逻辑其实很简单:风险从来不是“小概率意外”,是未来一定发生的必然事件。
你的系统从设计第一天起,就要接受“部分组件一定会坏”“局部一定会出问题”这个前提,而不是假设“一切都会正常运行”。
说白了,就是设计的时候就给自己留好后手,不是等塌了再去补承重墙。
我见过太多创业公司,老板拍板“先上线跑起来,活下去再说,抗风险以后考虑”,可真等风险来了,哪还有什么以后?活不到那一天啊。
 混沌工程抗风险测试流程图
去年我接触过一家做分布式光伏电站的企业,他们就把这个思路用到了工业控制上。每个季度都会主动触发一次小规模的电网故障,测试电站的脱网保护和孤岛运行能力。去年夏天南方极端高温导致区域电网跳闸,他们旗下一百二十多座并网电站,只有两座出了小故障,其余全部自动切换到孤岛模式给周边用户供电,不仅拿到了电网的应急补贴,还拿下了三个大订单,这就是抗风险设计带来的实实在在的收益。
你说香不香?
 中小团队不用烧钱,也能做好抗风险设计
很多人一提到抗风险技术设计,就觉得这是大公司烧钱玩的东西,中小团队没预算,搞不起。
说实话,真不是这样。抗风险不是堆钱,是选对方法,匹配你自己的业务阶段。
我给两个实用的思路,你拿去就能用。
第一,分等级做设计,别搞一刀切。核心链路,比如支付、用户核心数据、核心生产系统,你砸钱做多冗余抗风险没错。那后台内部报表、非核心的运营工具,哪怕崩一天,也影响不了营收,你犯不着花那个钱去做最高等级的防护对吧?把钱花在刀刃上就行。
第二,别贪大,用现成的云服务就能搞定大部分需求。你不用自己掏几百万建三个异地机房,找两个不同运营商、不同地域的云可用区,搞个跨区多活,成本比自己建机房低十分之一都不止,抗风险能力一点不差。
不过话说回来,我见过最多的坑,不是没钱做,是做完就扔那不管了。很多团队备份做了,预案写了,就觉得万事大吉了,一年半载都不演练一次,等真出事了才发现,备份文件损坏了,切换流程没人会操作,早就忘光了。
这不是白做吗?之前某电商公司,大促前一天发现备份半年没更,恢复不出来,差点耽误大促,连夜通宵赶,累瘫了三个开发,图啥啊?
这两年大家都能感觉到,黑天鹅越来越多了。上游供应链断供、极端天气、网络攻击、机房故障,哪一个出来都能把没准备的企业打懵。
抗风险技术设计这事儿,平时你看不到它创造什么收益,甚至还要多花人力物力,可真到出事的时候,你就会发现,那点提前花出去的功夫,就是你给自己留的最后一条后路。
总比出事了拍大腿哭强吧。
抗风险设计不是“事后补丁”,是骨架自带的支撑
大部分人对这件事的认知都错了。 很多团队觉得,抗风险技术设计就是出问题了加个备份,搞个预案,写在文档里存档就行。 真出事了你就知道,大部分预案连废纸都不如。去年河南暴雨那阵,多少制造企业把核心备件放在厂区地下仓库,洪水一来,主生产线淹了,备件也泡了,停摆了一个多月才恢复,订单丢了一大半。企业系统异地多活抗风险部署示意图
这两年科研领域提的抗脆性系统设计,核心逻辑其实很简单:风险从来不是“小概率意外”,是未来一定发生的必然事件。
你的系统从设计第一天起,就要接受“部分组件一定会坏”“局部一定会出问题”这个前提,而不是假设“一切都会正常运行”。
说白了,就是设计的时候就给自己留好后手,不是等塌了再去补承重墙。
我见过太多创业公司,老板拍板“先上线跑起来,活下去再说,抗风险以后考虑”,可真等风险来了,哪还有什么以后?活不到那一天啊。
当下抗风险技术设计的两个落地方向
说实话,最近五年这一块的进展真的很快,早就不是当年“搞个冷备份就算完事儿”的阶段了。现在主流落地的两个方向,真的能把系统的抗风险能力提好几个等级。 第一个就是去中心化冗余设计。 和传统的“一主一备”模式不一样,传统主备模式,主节点干活,备节点蹲那儿等着,真主节点炸了,切换不仅要人工操作,还经常出问题,去年某股份制银行的主备切换故障,停服务快一小时,多少人转不了账,投诉爆了客服中心。 去中心化冗余是啥?所有节点都是活的,大家一起干活,哪个节点挂了,流量自动分到其他节点,整个过程用户根本感知不到,根本不需要人工手动切。对分布式系统来说,这个设计的抗风险能力比传统主备强太多了。 第二个就是主动混沌工程测试。 说白了就是你自己没事就给自己搞点小破坏,故意炸掉几个节点,切断几段网络,模拟各种故障,测试你的系统能不能扛住。你天天练,真出事了就不慌了。 Netflix早十年就这么干了,他们有个团队专门天天找自己系统的麻烦,故意搞故障,现在哪怕一个机房整个掉网,用户都没感觉。混沌工程抗风险测试流程图
去年我接触过一家做分布式光伏电站的企业,他们就把这个思路用到了工业控制上。每个季度都会主动触发一次小规模的电网故障,测试电站的脱网保护和孤岛运行能力。去年夏天南方极端高温导致区域电网跳闸,他们旗下一百二十多座并网电站,只有两座出了小故障,其余全部自动切换到孤岛模式给周边用户供电,不仅拿到了电网的应急补贴,还拿下了三个大订单,这就是抗风险设计带来的实实在在的收益。
你说香不香?
中小团队不用烧钱,也能做好抗风险设计
中小团队不用烧钱,也能做好抗风险设计
很多人一提到抗风险技术设计,就觉得这是大公司烧钱玩的东西,中小团队没预算,搞不起。
说实话,真不是这样。抗风险不是堆钱,是选对方法,匹配你自己的业务阶段。
我给两个实用的思路,你拿去就能用。
第一,分等级做设计,别搞一刀切。核心链路,比如支付、用户核心数据、核心生产系统,你砸钱做多冗余抗风险没错。那后台内部报表、非核心的运营工具,哪怕崩一天,也影响不了营收,你犯不着花那个钱去做最高等级的防护对吧?把钱花在刀刃上就行。
第二,别贪大,用现成的云服务就能搞定大部分需求。你不用自己掏几百万建三个异地机房,找两个不同运营商、不同地域的云可用区,搞个跨区多活,成本比自己建机房低十分之一都不止,抗风险能力一点不差。
不过话说回来,我见过最多的坑,不是没钱做,是做完就扔那不管了。很多团队备份做了,预案写了,就觉得万事大吉了,一年半载都不演练一次,等真出事了才发现,备份文件损坏了,切换流程没人会操作,早就忘光了。
这不是白做吗?之前某电商公司,大促前一天发现备份半年没更,恢复不出来,差点耽误大促,连夜通宵赶,累瘫了三个开发,图啥啊?
这两年大家都能感觉到,黑天鹅越来越多了。上游供应链断供、极端天气、网络攻击、机房故障,哪一个出来都能把没准备的企业打懵。
抗风险技术设计这事儿,平时你看不到它创造什么收益,甚至还要多花人力物力,可真到出事的时候,你就会发现,那点提前花出去的功夫,就是你给自己留的最后一条后路。
总比出事了拍大腿哭强吧。