拆解韧性技术系统:为什么它是数字基建的下一张必打牌
前阵子跟某大厂云原生的朋友吃饭,酒过三巡他吐苦水。说去年大促的时候,流量突然冲垮了一个边缘节点,本来以为切备份就完事儿,结果备份和主节点用了同一片可用区的物理服务器,全挂了。三小时才恢复,损失小两个亿。
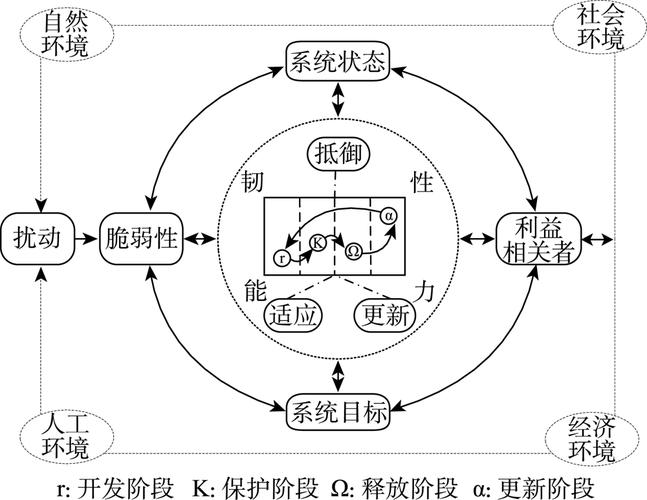 韧性技术系统与传统灾备系统对比图
差别在哪?传统灾备是“灾后重建”,韧性是“边抗灾边干活”。
现在黑天鹅事件越来越多,大到区域性断电、洪水地震,小到第三方厂商断供、程序员误删核心配置,你永远不知道下一个故障在哪等着。原来追求“系统永远不要坏”,现在根本做不到,那不如换个思路:坏了也不影响我干活,这就是韧性的价值。
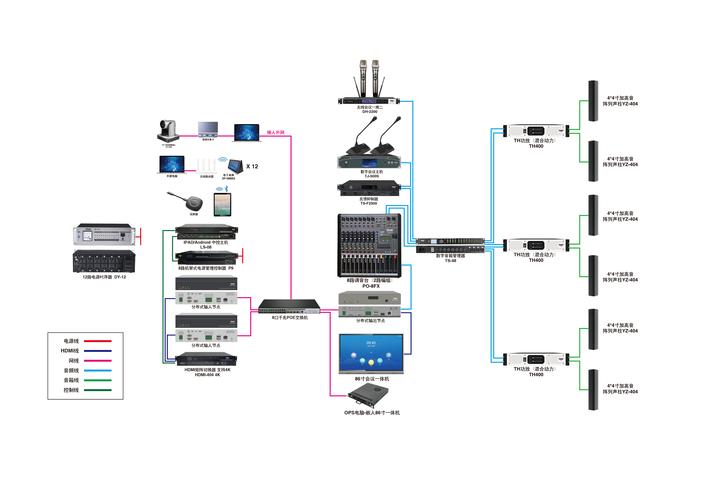 分布式韧性技术系统架构拓扑图
第三点,数据要做多维度异构备份。
别再把三份备份都存在同一个厂商同一片机房了,这跟没备份有什么区别?真韧性要求你,核心数据得同时存在不同地理位置、不同运营商、不同存储介质上,而且还要每个月自动演练切流,保证随时能切过去,不会切到一半数据乱码、丢包。
去年河南那场特大暴雨,我知道有一家城商行,提前三年就做了跨区域韧性改造,核心数据同步到了千里之外的南方机房,暴雨淹了本地机房之后,第二天核心业务就全恢复了,储户根本没受影响。同地段另一家没做改造的银行,停业了整整18天,多少老客户直接转走了存款,亏到姥姥家。
 未来两年,韧性技术会爆发在哪几个赛道
现在国内完成核心系统全链路韧性改造的企业,还不到15%,缺口大得吓人。接下来两年,肯定会有几个赛道先爆起来。
第一个就是大模型产业的韧性服务。
现在大家都在拼大模型推理服务的稳定性,你想啊,用户用你的大模型生成文案,生成到一半崩了,下次人家就用对手的了。还有训练阶段,一次训练大模型烧几百万,要是训练到一半集群出故障,之前半个月的成果全丢,能把创始人哭晕在厕所。现在专门做大模型集群韧性的团队,订单已经排到明年下半年了。
第二个就是中小微企业的标准化韧性SaaS。
原来做韧性改造,动则几百万上千万,只有大企业玩得起,现在公有云厂商把韧性能力拆成了标准化的SaaS服务,几千块钱一个月就能租来用,中小电商、初创公司都能用得起。这一块现在玩家还不多,跑出来的话增速肯定快。
不过话说回来,现在行业里也有歪风,不少厂商把原来的灾备服务换个壳,就叫“韧性技术系统”卖溢价,割不懂行的老板的韭菜。真韧性不是堆硬件堆出来的,是架构改出来的,这点大家一定要拎清楚。
你要是做技术的,早点把韧性这块的知识捡起来,以后跳槽开口薪资就能多要两成,绝对不亏。你要是做企业管理的,别等出事了再拍脑袋补预算,现在抽点小钱出来改架构,比出事之后掏几个亿赔损失,划算太多了。
黑天鹅永远不会停,你够韧,才能活的够久。
别把韧性和备份画等号,很多人一开始就错了
现在提起韧性技术系统,太多人第一反应就是“这不就是多做几个数据备份吗?换个名词割韭菜而已”。 说实话,真不是。 很多企业做了十几年灾备,核心逻辑还是“坏了之后人工救”,韧性技术系统的核心完全不一样——它是在故障发生的时候,不用人工介入,也能自动吸收冲击、维持核心服务运转,事后还能自己把烂摊子收拾好。 举个最直观的例子,去年亚马逊美东区域崩了三个小时,很多提前做了韧性架构改造的中小公司,用户根本没感觉到任何异常,刷商品下单全程顺畅,那些只做了本地单份备份的公司,直接跟着一起躺平,客服被骂到爆。韧性技术系统与传统灾备系统对比图
差别在哪?传统灾备是“灾后重建”,韧性是“边抗灾边干活”。
现在黑天鹅事件越来越多,大到区域性断电、洪水地震,小到第三方厂商断供、程序员误删核心配置,你永远不知道下一个故障在哪等着。原来追求“系统永远不要坏”,现在根本做不到,那不如换个思路:坏了也不影响我干活,这就是韧性的价值。
韧性技术系统落地,绕不开的三个核心改动
我翻过去年信通院出的《韧性技术系统白皮书》,再结合身边朋友落地的实际情况,总结下来真要做,核心就是三个地方改,没什么花架子。 第一点,混沌工程从“走流程”变成“常态化”。 很多公司说我也做过混沌工程啊,就是入职的时候找个测试炸一次服务器,走个过场就完了。真要做韧性,就得天天炸,每周抽几个节点故意搞坏,逼着系统自己长出容错的能力。我知道有一家做短视频的公司,现在要求开发提交代码的时候,必须同步写一个故障用例,每次发版都要带着故障跑一遍通,不通过不让上线,这才是对韧性该有的态度。 第二点,架构改成“小自治单元”模式。 原来很多企业喜欢做超级大单体,一个系统管所有业务,一处坏全系统崩,韧性架构要求你把大系统拆成成百上千个互不干扰的小单元,每个单元自己管自己,一个单元死了,其他单元自动接走流量,根本不会影响全局。分布式韧性技术系统架构拓扑图
第三点,数据要做多维度异构备份。
别再把三份备份都存在同一个厂商同一片机房了,这跟没备份有什么区别?真韧性要求你,核心数据得同时存在不同地理位置、不同运营商、不同存储介质上,而且还要每个月自动演练切流,保证随时能切过去,不会切到一半数据乱码、丢包。
去年河南那场特大暴雨,我知道有一家城商行,提前三年就做了跨区域韧性改造,核心数据同步到了千里之外的南方机房,暴雨淹了本地机房之后,第二天核心业务就全恢复了,储户根本没受影响。同地段另一家没做改造的银行,停业了整整18天,多少老客户直接转走了存款,亏到姥姥家。
未来两年,韧性技术会爆发在哪几个赛道
未来两年,韧性技术会爆发在哪几个赛道
现在国内完成核心系统全链路韧性改造的企业,还不到15%,缺口大得吓人。接下来两年,肯定会有几个赛道先爆起来。
第一个就是大模型产业的韧性服务。
现在大家都在拼大模型推理服务的稳定性,你想啊,用户用你的大模型生成文案,生成到一半崩了,下次人家就用对手的了。还有训练阶段,一次训练大模型烧几百万,要是训练到一半集群出故障,之前半个月的成果全丢,能把创始人哭晕在厕所。现在专门做大模型集群韧性的团队,订单已经排到明年下半年了。
第二个就是中小微企业的标准化韧性SaaS。
原来做韧性改造,动则几百万上千万,只有大企业玩得起,现在公有云厂商把韧性能力拆成了标准化的SaaS服务,几千块钱一个月就能租来用,中小电商、初创公司都能用得起。这一块现在玩家还不多,跑出来的话增速肯定快。
不过话说回来,现在行业里也有歪风,不少厂商把原来的灾备服务换个壳,就叫“韧性技术系统”卖溢价,割不懂行的老板的韭菜。真韧性不是堆硬件堆出来的,是架构改出来的,这点大家一定要拎清楚。
你要是做技术的,早点把韧性这块的知识捡起来,以后跳槽开口薪资就能多要两成,绝对不亏。你要是做企业管理的,别等出事了再拍脑袋补预算,现在抽点小钱出来改架构,比出事之后掏几个亿赔损失,划算太多了。
黑天鹅永远不会停,你够韧,才能活的够久。